4X RTX6000 Blackwell搭載自作ワークステーションのLLM推論ベンチマーク
30秒でわかる内容解説
Level1Techsフォーラムの個人ユーザーが、AMD Threadripper PRO 7985WXと4枚のNVIDIA RTX6000 Blackwell Pro Max-Qを搭載した自作PCを約2年かけて構築した。総メモリ容量384GBのGPU環境で、DeepSeek v4.1 FlashやMiniMax M3などの大規模言語モデルをローカル推論した際の性能と消費電力を計測している。自作PCで最新AIモデルを動かす技術者や愛好家の参考になる実測データが公開されている。
384GB VRAM環境での推論性能と消費電力
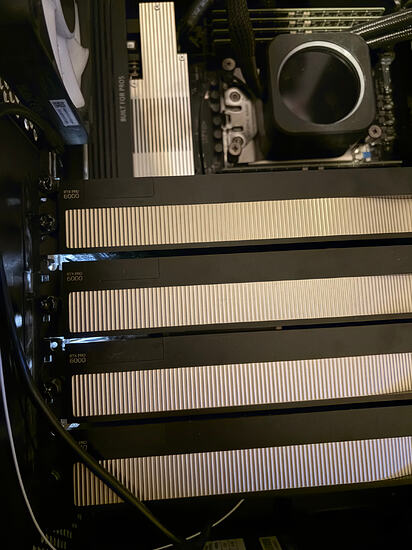
最終構成の総費用は約5万4千ドルに達する。CPUには64コアのAMD Threadripper PRO 7985WXを採用し、メモリは512GBを積んでいる。GPUは4枚のRTX6000 Blackwell Pro Max-Qを搭載し、VRAMの合計は384GBになる。
プラットフォームはASUS WRX90E-SAGE SEであり、電源は1700WのSuper Flower Leadex Titaniumを使用している。
| 項目 | 値 |
|---|---|
| DeepSeek v4.1 Flash (1Mコンテキスト) | 11.1 tok/s |
| MiniMax M3 (1Mコンテキスト) | 39.2 tok/s |
| 消費電力 (DCフルロード) | 約1760W |
| CPU周波数制限 | 2.20GHz |
推論ベンチマークでは、コンテキスト1Mの条件でMiniMax M3が39.2 tok/sを記録した。同じく1MコンテキストのDeepSeek v4.1 Flashは11.1 tok/sにとどまり、M3が約3.5倍高速だった。M3はコンテキストが成長するほどデコードの劣化が緩やかだった。一方、dsv4はインデクサが各ステップでKVキャッシュ全体を再スキャンするため、性能低下が急激だった。
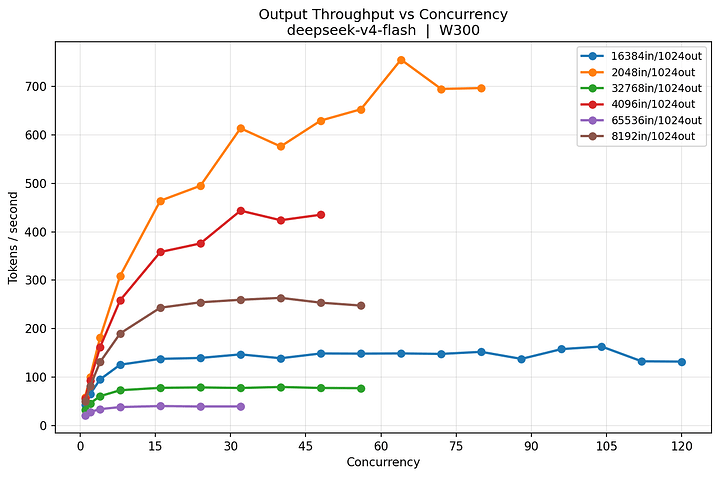
両モデルともSM120向けランタイムが0-dayで提供されなかった。 MXFP4 W4A4量子化(quantization)の重みに対応する自作ランタイムを組み立てた。4GPUフルロード時の消費電力はDCで約1760Wに達する。15Aブレーカーで安定動作させるため、Linux上でCPU周波数の上限を2.20GHzに制限した。
Labs would build against datacenter hopper/blackwell SM90 / SM100 and may not release the model runtime that would run on SM120.
ラボはデータセンター向けのHopperやBlackwell(SM90/SM100)向けにビルドするため、SM120用ランタイムをリリースしない可能性がある。
2年がかった組立経緯と冷却・配線の工夫
当初の構想は2024年3月に公開された70bモデルの家庭用トレーニング事例から始まった。
カスタムPCの自作は子供時代以来であり、市販のLambda Labs仕様(約2万3千ドル)よりも約18%安い部品価格を目指した。2024年7月に部品を入手したが、ASRock製マザーボードはPOSTに失敗し、同年8月にASUS製に交換して組立が完了した。
VRAM容量を倍増させるため、当初1枚から始め2024年10月に2枚目を追加したRTX6000 Ada構成を、2025年8月にBlackwell世代へ置き換えた。
2025年11月と12月にかけて残りの2枚と1700W電源が届き、12月22日に4GPU構成が完成した。
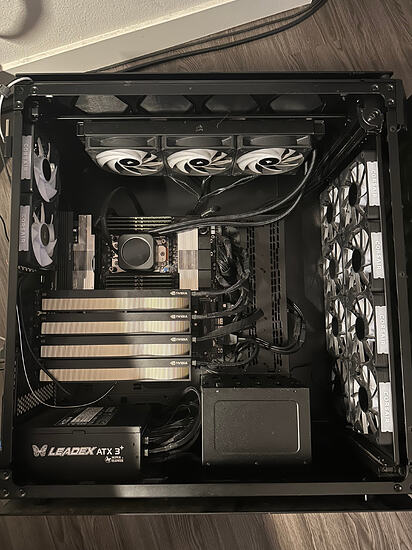
ケースはCorsair Obsidian 1000Dを採用し、前面に120mmファンを8基、背面に2基、CPUクーラーとして420mm AIOを装着した。GPUのレイアウトを工夫し、挟まれた上のカードが92℃でサーマルスロットリングするのを防いだ。250Wから300Wの電力カットオフに変更すると、fp4演算で約17%、tf32で約22%のスループット向上を確認した。
コスト重視の反応とSWE-bench実測スコア
公開されたベンチマークデータに対し、HNやフォーラムでは総費用の高さが主な話題となった。特に意見が対立する点はなく、技術的な補足コメントが数件寄せられている。URLの書き換えにより、元記事のリンクがLevel1Techsの別のページにリダイレクトされている点も指摘された。
実用面では、SWE-benchの検証セットでdsv4が76.0%、m3が74.8%のスコアを記録した。これはClaude Sonnet 4.5や4.6に匹敵する水準であり、ローカル環境でも実用的な推論性能を発揮することが示された。ただし、M3のMoEエキスパート(層)が量子化されているため、実測値がラボ報告値より約5.7%低い要因になっている。
消費電力の管理方法についても関心が集まった。15A回路で運用するためCPUクロックを制限する手法は、家庭やレンタルスペースの電気設備に制約がある自作PCユーザーにとって参考になる。20A/240VのNEMA 6-20Rコンセットがあれば、2200W電源へのアップグレードも視野に入れている。
SM120ランタイムの動向と2026年中期の組立見込み
SM120アーキテクチャ向けのモデルランタイムは、データセンター向けHopperやBlackwell向けに最適化されたものが優先され、0-dayで提供されない可能性がある。自作ランタイムの構築が早期サポートの鍵となる。RAIDXpert2のLinuxドライバーはASUSから未だ公開されていないため、RAID構成はLinuxのmdadmで代替している。
Windows環境ではWSL2を使用し、大規模モノレポのビルドに利用している。BitLockerを必須とする企業環境のため、Windows用ドライブは独立した4TB SSDに配置した。Remote Desktop接続で数日稼働後に緑色の画面(グリーンウィンドウ)が発生するケースがあり、Windowsの安定稼働期間はLinux環境より短めだった。
2026年6月時点での運用では、Ubuntu 24.04 LTS上で35日から40日の連続稼働を維持している。今後はメモリとストレージ価格の変動を勘案し、2026年中期に同等構成を組むと費用が膨らむ見込みだ。
用語の注釈
- quantization
- 重みの精度(ビット数)を下げることでメモリ消費を減らし、推論を高速化する技術。(参考:ローカル実行の常識! LLM 量子化 ( Quantization ) の仕組みと ...)
- GGUF
- llama.cppなどで使われるローカル推論用のモデルファイル形式。重みやアーキテクチャ情報を保存し、量子化でローカル環境での高速推論を実現する。(参考:GGUF量子化ってなんだ?〜ローカルLLMを爆速で動かすための ...)