推論とメモリを分離した軽量ローカルLLM AViGPTが公開される
25秒でわかる内容解説
開発者のAvinash Ricky Yadlapalliが、推論と事実記憶を分離した軽量LLM「AViGPT」をGitHubで公開した。パラメータ数は183M程度に抑え、RAM消費量は0.4GBで動作する。ローカルのNVMe SSDストレージを直接読み込む仕組みにより、従来のネットワーク型RAGより高速な情報取得が可能だ。自作PCやデスクトップマシンで動作させる技術者にとって、GPUなしでの運用が現実的な選択肢となる。
183MパラメータのTransformerコアと1.18msのストレージバス
本モデルは183,926,400パラメータを持つTransformerコアを採用している。16層、14アテンションヘッド、896のhidden dimension、1024のcontext windowで構成される。
標準的なパーソナルコンピュータ上で動作し、RAM使用量は0.4GBに収まる。従来のLLMは重み付けで事実を内部記憶していた。AViGPTは言語推論をパラメトリックメモリから分離した設計だ。
9つのトークンからなる命令セットが生成の流れを制御する。モデルは生成を一時停止し、ローカルのSQLite FTS5エンジンにクエリを送る。検索エンジンBM25(全文検索における関連度ランキングアルゴリズム)とWrite-Ahead Logging(WAL、書き込み前ログ)を用いる。
NVMe SSD上のデータ取得は1.18msで完了する。取得した事実を基にモデルが応答を合成する仕組みになっている。 下の画像は、1,800イテレーションの学習過程で交差エントロピー損失が3.3698から0.6935まで低下した様子を示す。
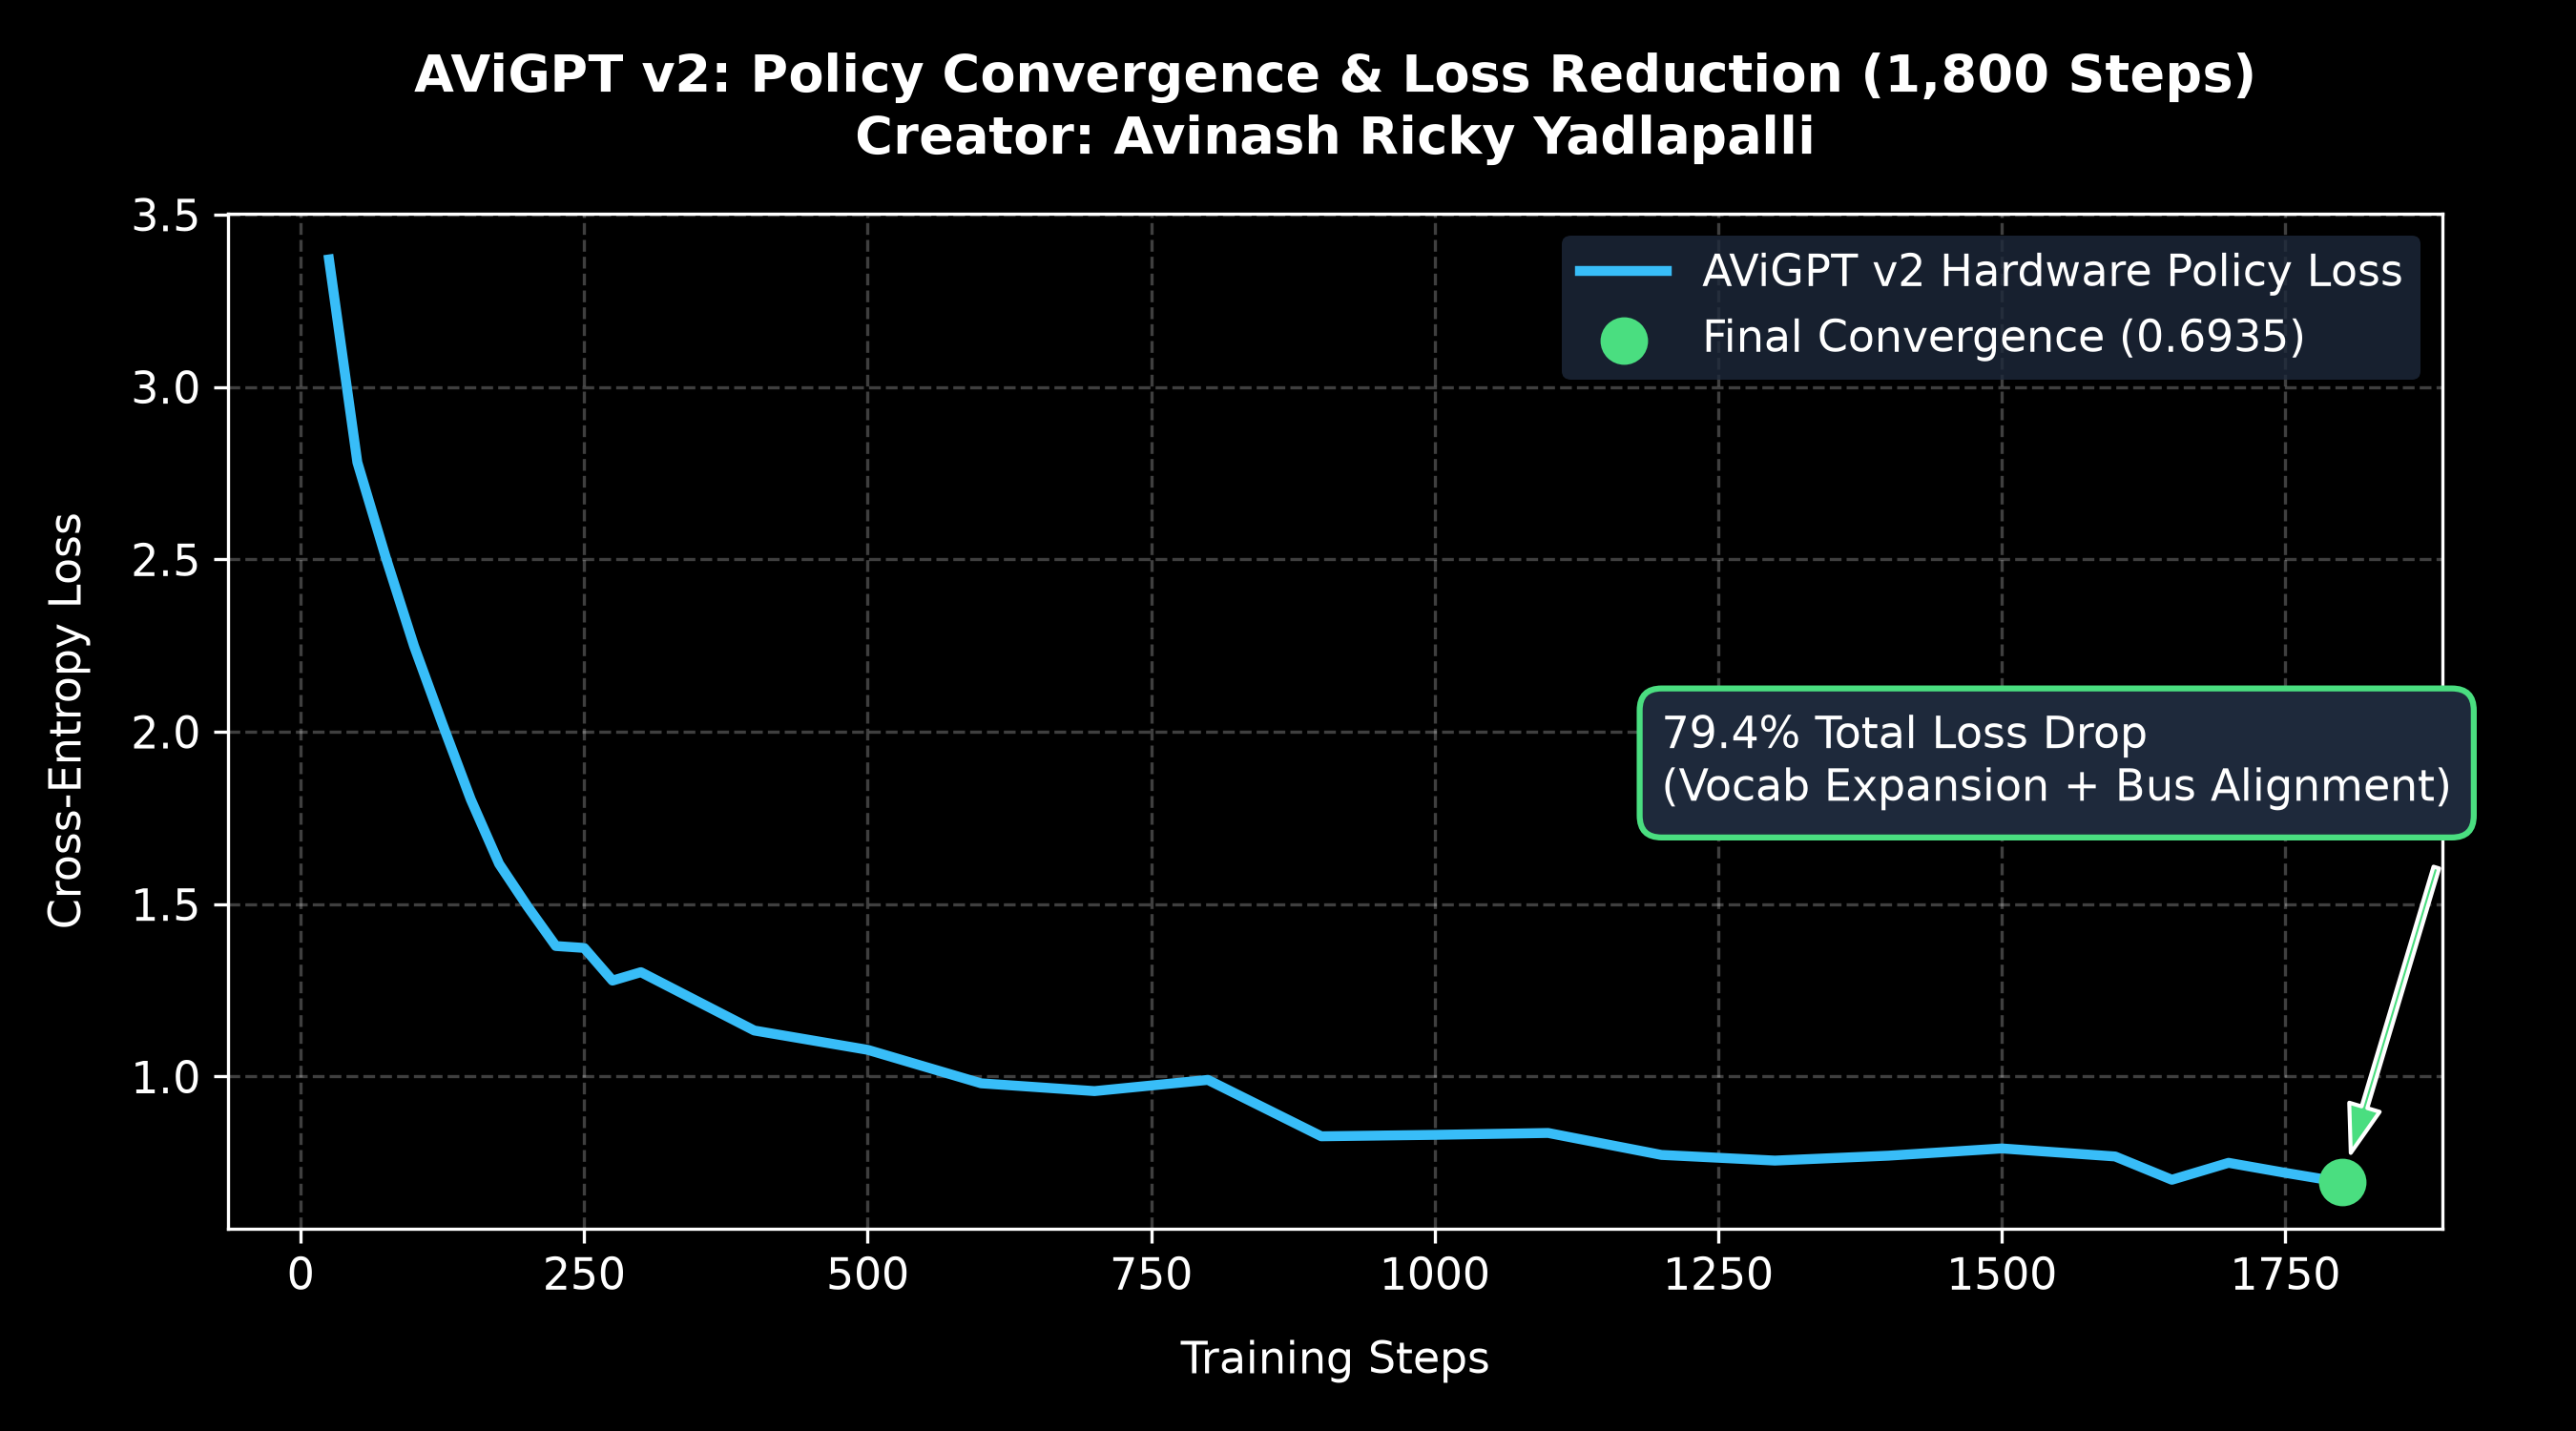
NVIDIA H100 GPU上で約50億トークンで事前学習された。サブミリ秒のネイティブハードウェアメモリバスが推論と記憶の境界を明確に分けている。ZenodoにはDOI番号が割り当てられている。
サブミリ秒のハードウェアバスと決定論的計算の分離
重み付けされた知識をストレージに追い出す設計思想は、0.4GBというハードウェア要件の削減と知識の更新効率化を両立させる。このアプローチにより、ファインチューニング不要で知識を直接ディスクに書き込める。
モデルはメモリ取得、決定論的計算、多段階複合推論、負の非ツールサンプルをカバーする25,850のタスク軌道で整列学習された。ランタイムではディスクへの直接書き込みに対応する。
ファインチューニングや重みの修正なく、0msで新しい知識を挿入できる。ゼロショットのディスク書き込み機能により、ユーザーはローカル環境でモデルの知識をリアルタイムに拡張できる。
画像では、ネットワークベースのRAG(外部知識を参照して回答を生成する手法)が500から1500msかかる。対してAViGPTのNVMeストレージ取得は1.18msで完了する比較グラフを確認できる。
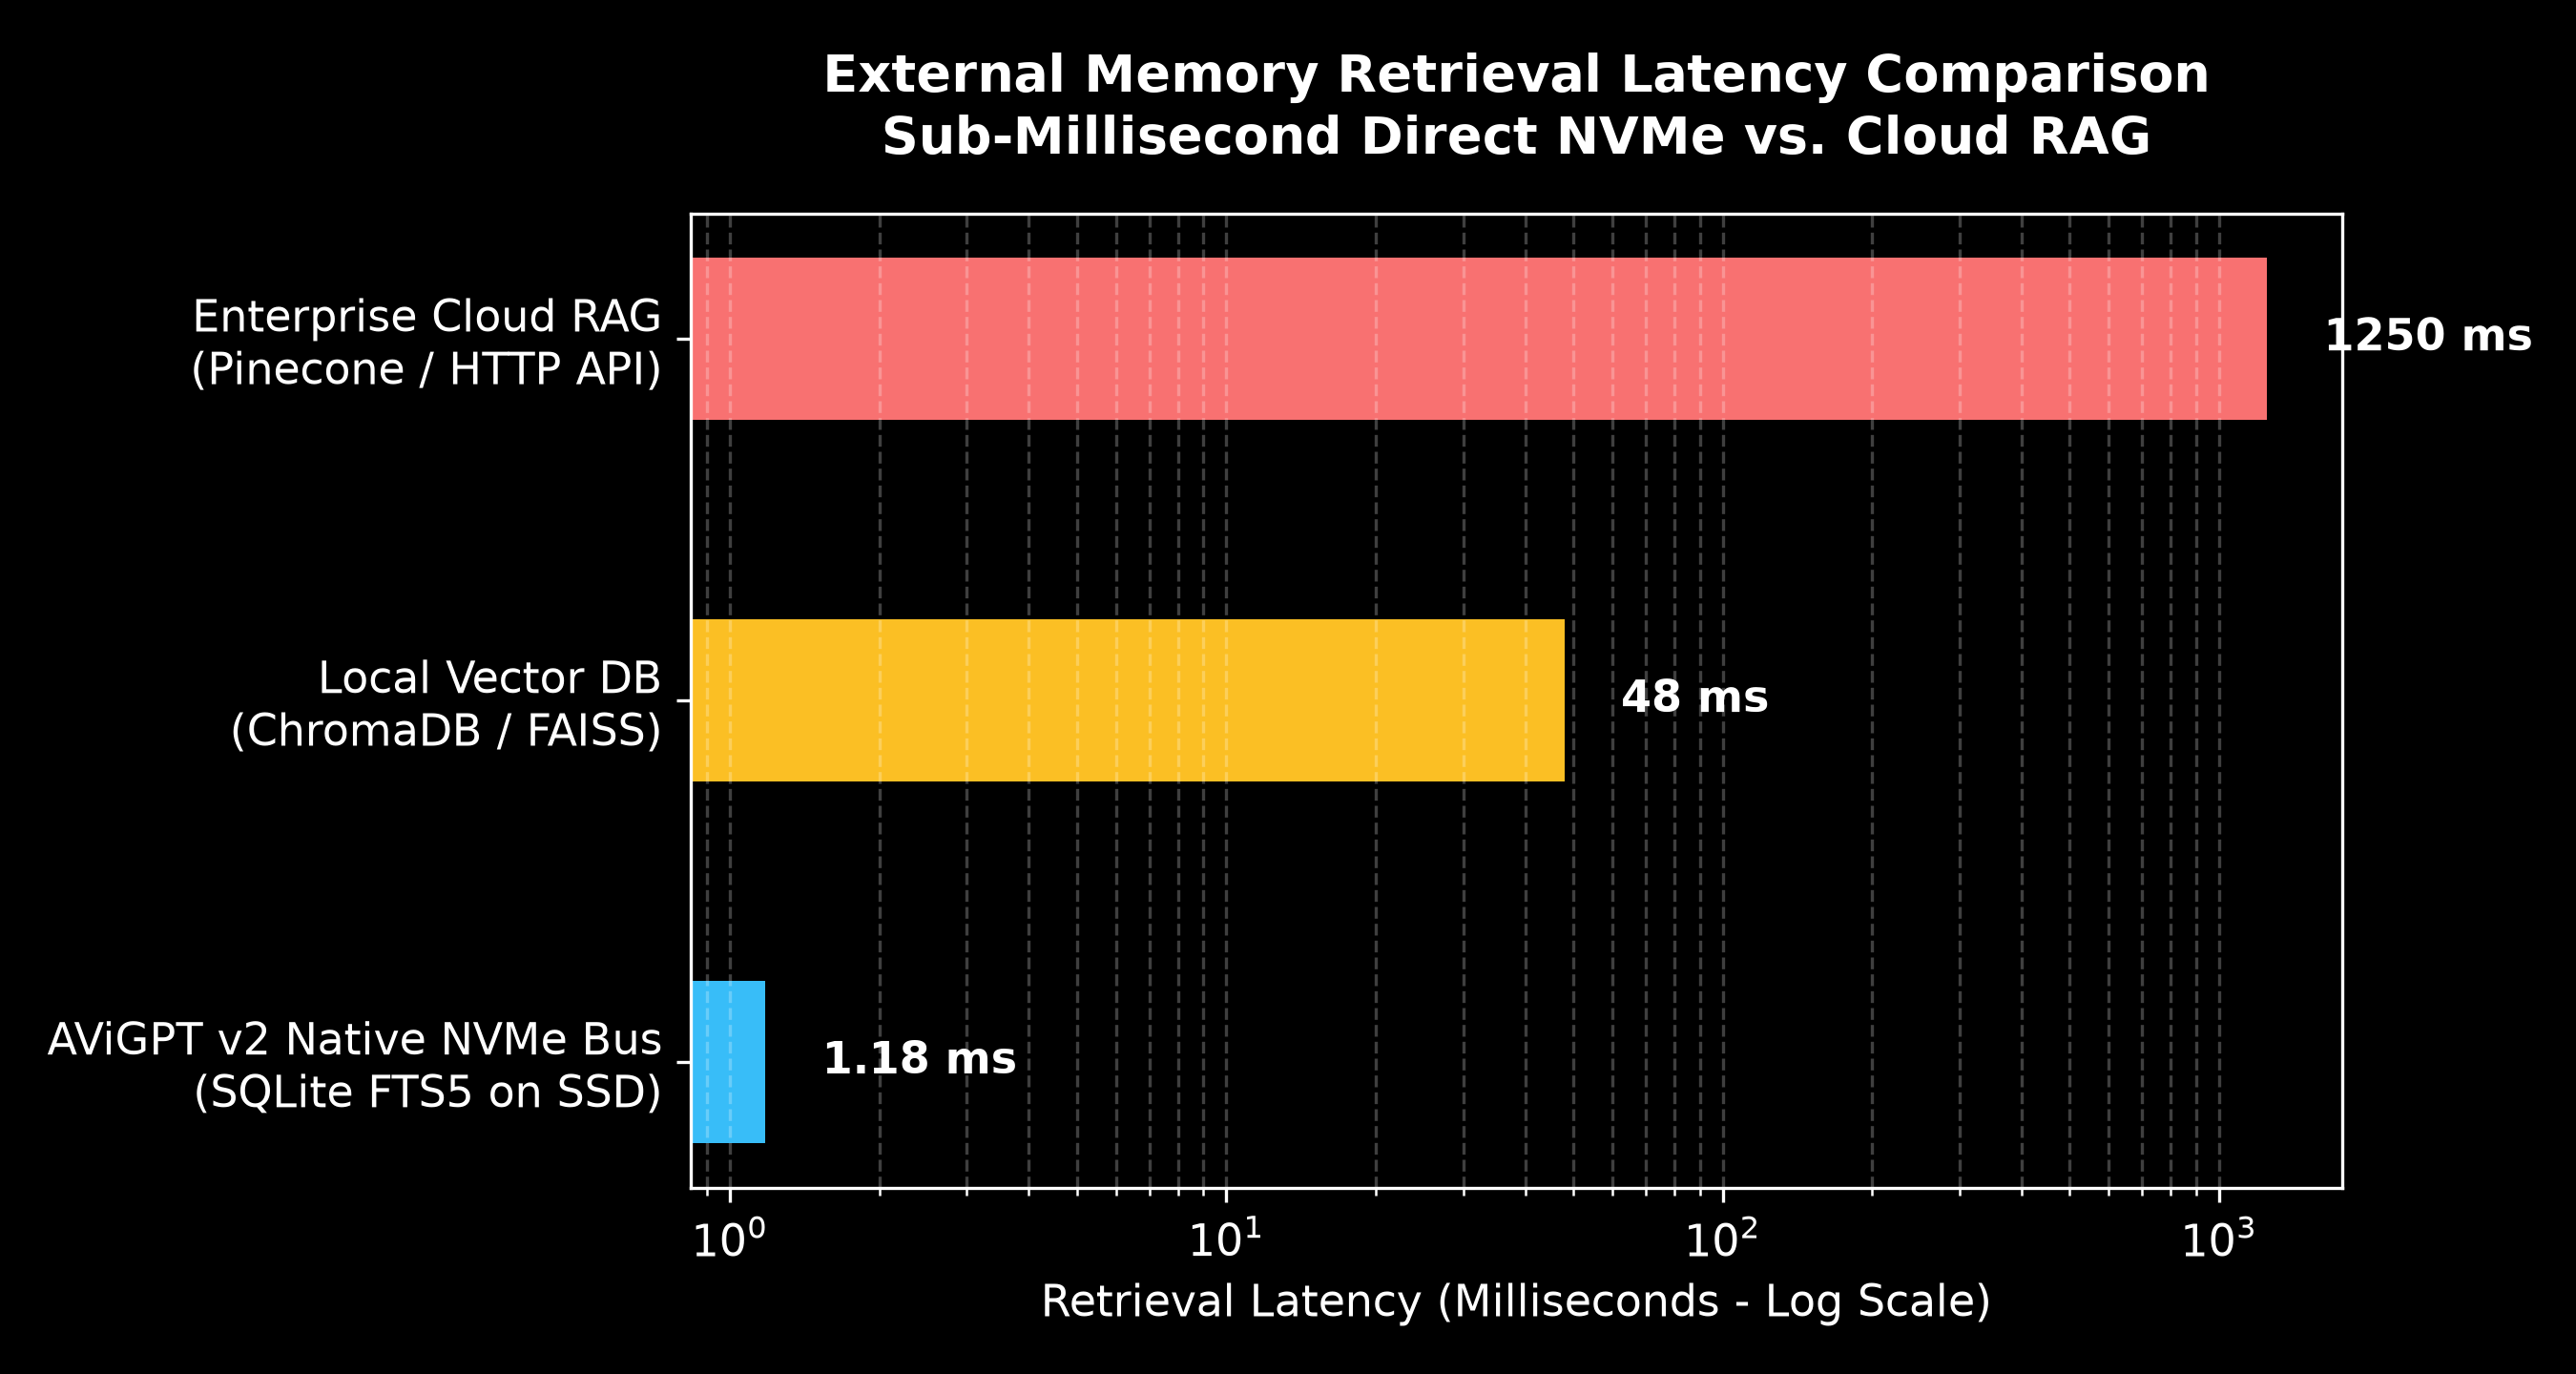
サブミリ秒のネイティブハードウェアメモリバスがその速度を支えている。推論エンジンとデータベースエンジンの境界が明確になったことで、VRAM依存型のアーキテクチャが抱えていたボトルネックを回避できる。
Pythonサンドボックスによる決定論的計算レイテンシは0.05msに抑えられている。「<|intent_start|>」「<|mem_query|>」「<|calc|>」「<|synthesize|>」の4つの専用トークンが処理フローを定義する。
0.4GBフットプリントのCPU推論とデスクトップスタジオ
GitHubとHugging Faceで公開されたAViGPTは、2026年9月20日にAvinash Ricky Yadlapalliによってリリースされた。コミュニティからのコメントはまだ投稿されていない。
技術レポートとアーキテクチャのドキュメントが公開され、数値ベースの評価が提示されている。Python APIとStreamlitで構築されたデスクトップスタジオが提供される。
autonomous_busモジュールがハードウェアバスを制御し、生成メトリクスをリアルタイムで表示する。開発者は標準的なローカル環境で、GPUの制約を受けずに推論パイプラインを構築できる。
下の図は、AViGPTが0.4GBのメモリフットプリントで専用GPUアクセラレータなしに消費者用CPUで完全に動作することを示している。従来の大規模言語モデルが数十GBのVRAMを必要とする。
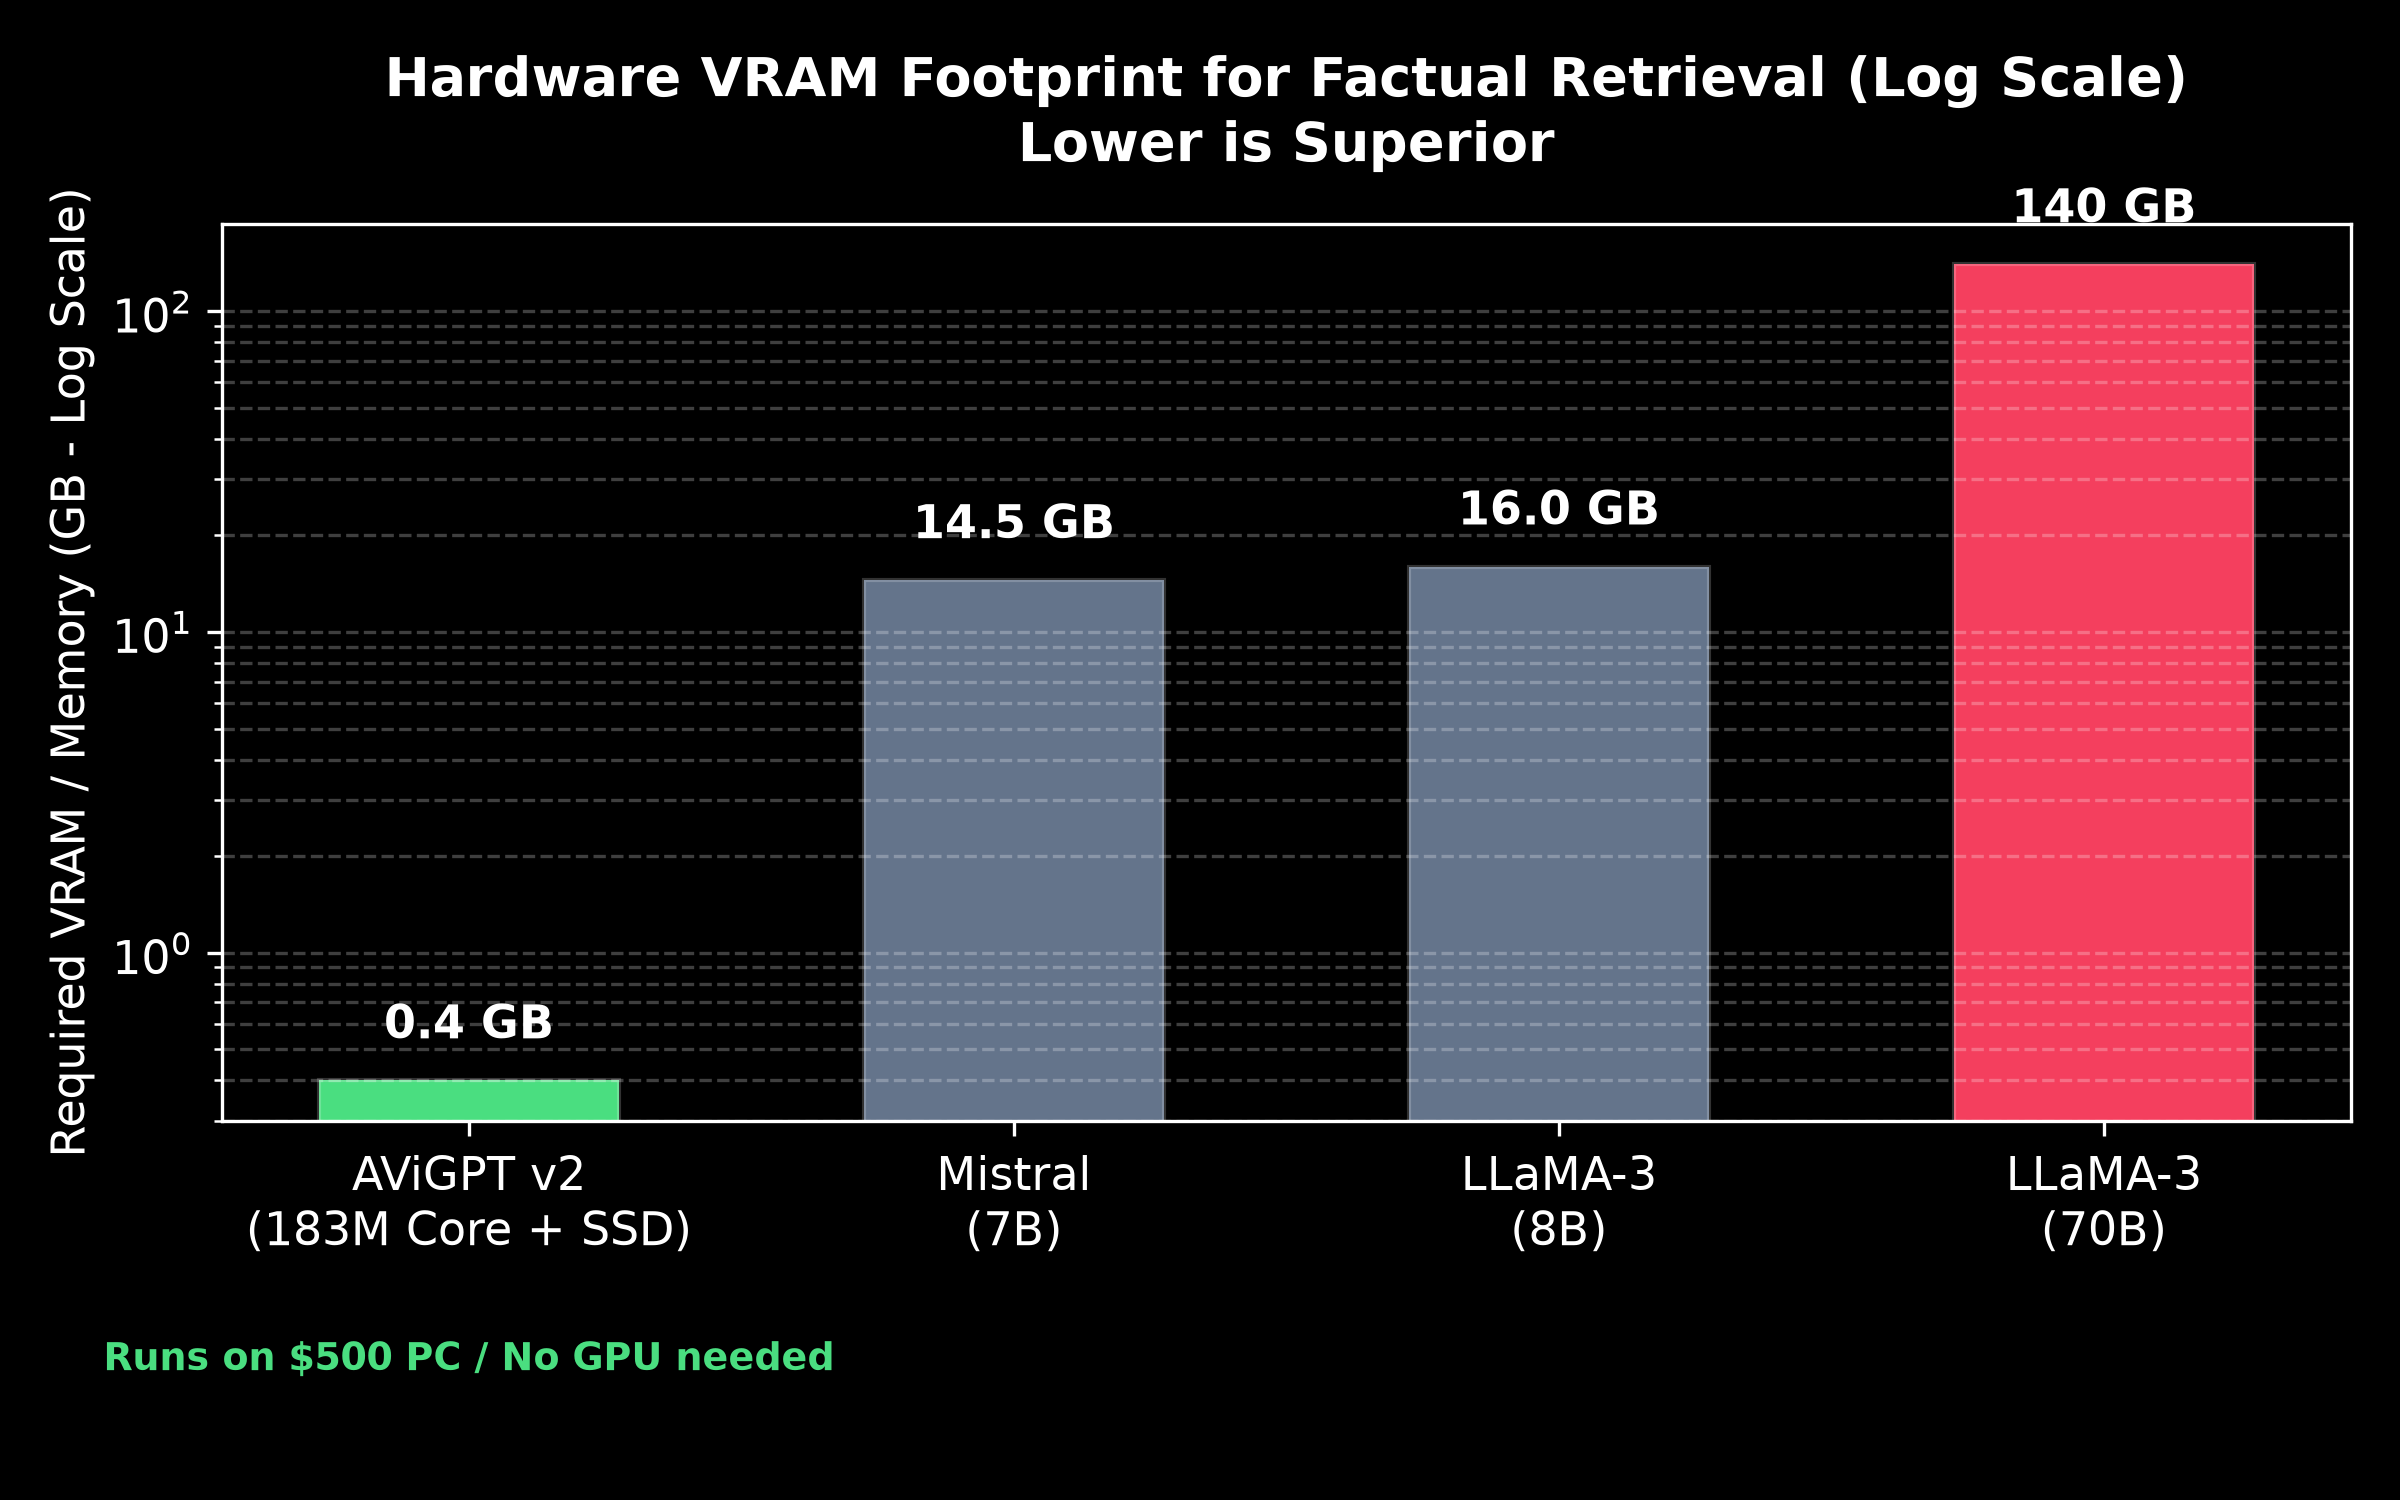
MITライセンスの下で配布されており、商用利用も制限なく行える。GPT2LMHeadModelとGPT2TokenizerFastを用いてモデルをロードする。
CPUまたはGPUデバイスに転送後、AutonomousHardwareBusインスタンスを初期化する。generate_autonomous_response関数を実行すると、応答文字列とssd_latency_msを含む辞書が返却される。
ローカル環境での知識拡張と次世代ランタイムへの展開
日本語の事前学習データは明示されていないが、WikipediaとFineWeb-Eduの混合コーパスで訓練されている。日本語環境での利用には、ローカルのSQLiteデータベースに日本語テキストを登録する運用が想定される。
今後の予定として、技術レポートの改訂版が発表される。ベンチマーク結果の詳細な telemetry log が公開され、異なるNVMe SSDモデルとのレイテンシ比較データが追加される予定だ。
2026年9月20日に公開されたAViGPTは、ローカル推論のアーキテクチャを再定義する設計になっている。ストレージの速度がそのまま推論速度に直結する仕組みは、次世代のPC向けAIランタイムの標準になる可能性がある。
ZenodoにはDOI番号が割り当てられており、学術引用にも対応している。技術報告書には数学的な詳細と実験手法が記載され、再現性を担保する。
API経由でgenerate_autonomous_response関数を呼ぶだけで、SSD取得レイテンシ付きの応答が返ってくる。学習収束チャートとメモリレイテンシ比較グラフはGitHubリポジトリのassetsディレクトリに保存されている。
2026年秋以降、技術レポートの改訂版が公開され、ベンチマークデータの追記が行われる予定だ。各チャートは検証可能な数値根拠を提供し、実装時のパラメータ調整の参考になる。
用語の注釈
- BM25
- 検索精度や効率を評価指標で測定し、関連ドキュメントの順位を決定する検索ランキングアルゴリズムである。(参考:BM25(Okapi BM25)とは?検索ランキングアルゴリズムの ...)
- RAG
- 外部の知識やデータを参照し、それらを基に回答を生成する手法である。(参考:RAG(検索拡張生成)とは?仕組み、メリットや活用事例)
- VRAM
- GPUが使用するビデオメモリであり、AIモデルの重みや処理データを高速に保持する領域である。(参考:VRAM(ビデオメモリ)とは?役割や用途別の容量の目安につい ...)