Kimi K3.1 Pro リリース。3Tクラスオープンウェイトと100万トークンコンテキスト
30秒でわかる内容解説
月之暗面(Kimi)が10月23日、3Tクラスのオープンウェイトモデル「K3.1 Pro」を正式に公開した。100万トークンという長大なコンテキストウィンドウを備え、コーディングや3D生成、金融分析でトップクラスのベンチマークスコアを記録している。技術者や開発者は、このモデルを自社のインフラで走らせることで、プロプライエタリモデルに依存しないAI活用が可能になる。11月4日にはフルモデルウェイトが公開される予定だ。APIの利用価格は入力2ドル(約314円)、出力10ドル(約1,570円)/MTokで設定されている。
円換算は1ドル=156.8円(2026年10月23日、欧州中央銀行の参考レート)による概算で、日本での販売価格とは異なる。
コーディングと金融でトップクラスの数値を記録
月之暗面(Kimi)は10月23日、3Tクラスのオープンウェイトモデル「K3.1 Pro」を公開した。100万トークンのコンテキストウィンドウを備え、長文書や大規模コードベースの処理に対応する。コーディングエージェント性能はTerminal-Bench 4.0で65.7点を記録し、GPT-6 Astraの58.2点を上回る。
Claude Opus 5.5の66.4点に迫る数値だ。内部ベンチマークKimi Code Bench 3.0 Long-horizonでは61.2点をマークし、旧モデルK3の55.95点を大きく上回った。
事実の正確性も改善された。内部ベンチマークKimi Hallu Bench Hardでは、主張レベルの幻覚率がK3の23.4%から8.3%に低下した。応答速度を重視する「Highspeed」版も同時に提供され、処理速度が2〜3倍向上する。現在WebアプリやAPIで利用可能だが、フルモデルウェイトは11月4日に公開される。企業向け管理機能はデフォルトで無効となっている。
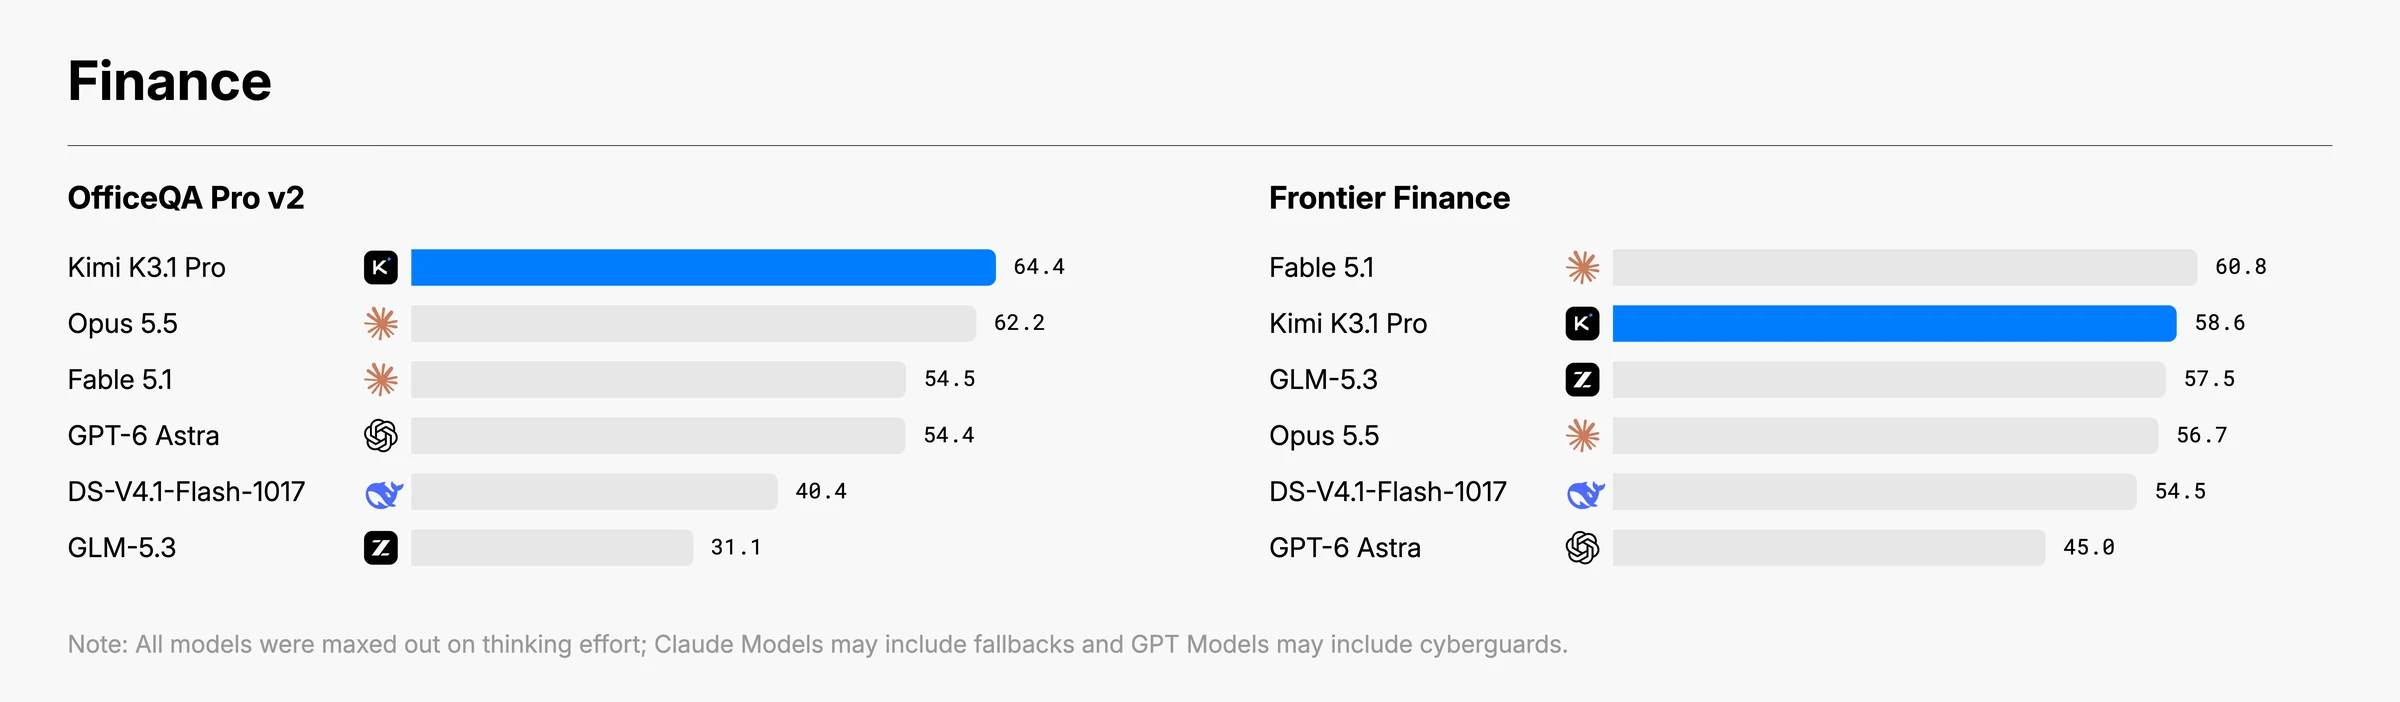
金融分析でもOfficeQA Pro v2で64.4点の最高得点を記録した。数式連鎖や実務ワークシートの品質評価でも、旧モデルより7.2ポイント向上した。 PostTrainBenchではH20 GPU使用時の内部評価を行い、安定した性能向上を確認した。
技術者は11月4日のウェイト公開を待てば、ローカル環境やオンプレミスサーバーで独自に推論できる。写真ではOfficeQA Pro v2とFrontier Financeにおける金融ベンチマーク結果が示されている。
並列強化学習の最適化とサイバー能力の意図的な制御
K3.1 Proは既存のK3を基盤に、事後学習と強化学習の計算量を大幅に増やして訓練された。数百のドメインで並列強化学習を行うため、RLフレームワークやサンドボックスインフラが最適化された。3D生成能力も強化され、BenchCADで92.7点を記録した。Claude Opus 5.5の96.2%やGPT-6 Astraの95.9%に肉迫する数値だ。
サイバーセキュリティ機能の制御が特徴的だ。オープンウェイト版の攻撃力を意図的に抑制するため、中間学習とRL段階からサイバー関連データを除去した。内部ベンチマークxdev-bench-hardでは、除去前の90.5%から81.0%に低下した。 人間歩行シミュレータの構築テストでは、167ミッションと420回の検証をクリアし、11.2秒間の連続歩行を達成した。
K3.1 Pro's offensive cyber capability is, by design, below what our pipeline can produce, and remains behind that of frontier proprietary models.
設計上、K3.1 Proの攻撃力は自社のパイプラインが生成しうるものより低く、最先端のプロプライエタリモデルにも及ばない。
報酬フィードバック調整が腕の動きを改善できなかった際、モデルは単純な調整に頼らずシミュレータのダイナミクスをオープンループで検証した。その結果、肩筋のモーメントアーム計算における36個のエラーを特定し、コントローラを再訓練した。3D作成ではMCPコネクターなしでBlenderやCADツールのスクリプトを記述できる。
ベンチマーク飽和の指摘と価格競争の激化
ベンチマークスコアの高さや幻覚率の改善に対し、開発現場での実用性を期待する声が上がっている。一方でTerminal-Bench 4.0が既に飽和しているとの指摘もあり、実際の開発効率にどの程度反映されるかは未知数である。 オープンウェイト版のサイバー能力が意図的に抑制されていることに対し、技術者からは制御の意図が明確だとの評も出た。プロプライエタリモデルとの実力差が明確でないため、独自環境での評価が必須となる。
Our biggest finding is that Terminal Bench 4 is closer to solved than its leaderboard
我々の最大発見は、Terminal Bench 4がリーダーボード予想より既に解かれている段階に近いことだ。
価格面では中国版が旧モデルより約30%安い設定だ。APIの価格設定は入力2ドル(約314円)、出力10ドル(約1,570円)/MTokとなっている。月額99ドル(約1万5,500円)のプランでは、47分間のセッションで5時間の利用枠が上限に達したとの報告がある。DeepSeekやGLM、Qwenとの実性能差を問う声も散見される。ベンチマーク表のFirefoxでの表示不具合を指摘する声もある。
Apex AgentsやAutomationBench-AAのスコア引用も出ている。BrowseCompでは200Kトークンでコンテキスト圧縮がトリガーされる。各ラボが独自のRL環境を構築している業界動向に対し、標準化の動きが生まれるかどうか関心が集まっている。モデルの公開時期や価格競争が激化する中、技術者は用途に合わせた選択を迫られる。
11月4日のウェイト公開と防御用能力の段階的向上
フルモデルウェイトは11月4日に公開され、ローカル環境やオンプレミスサーバーでの動作が本格化する。サイバーセキュリティの能力は段階的に引き上げられる予定だ。現在プロプライエタリモデルより低い攻撃力を、将来的なウェイト更新で補完する方針である。技術者は11月のウェイト公開を待たずともAPIで試せるため、実務での評価を進めることができる。
金融研究ベンチマークでは、証拠とカットオフ制約下で監査可能な調査報告書を生成する能力が旧モデルより11.6ポイント向上した。ビジネス運用シミュレーションでは長期的な意思決定能力が約4.2倍に改善した。API利用者はZero Data Retentionを有効にでき、データ保存の制御を可能にした。
企業向け管理機能はデフォルトで無効となっているが、管理者が組織全体へ展開できる。同社は防御用に二重用途の能力を必要とするチームに恩恵をもたらすため、非差別化での提供を目指す。Kimi Codeの/modelコマンドでモデル切替が可能だ。11月4日のウェイト公開後、防御用能力の段階的な引き上げが実施される。
出典
- Kimi K3.1 Pro and K3.1 Pro Highspeed(Hacker News) · 議論