llama.cppのn-gramキャッシュ最適化でドラフト速度が最大140倍向上
25秒でわかる内容解説
開発者のHayder Tirmazi氏がllama.cppのprompt lookup decoding機能の高速化に成功した。n-gramキャッシュのデータ構造を刷新し、Daniel Lemire氏の追加PRと合わせると最大140倍のドラフト速度向上を実現した。自作PCでローカル推論を行う技術者にとって、生成待ち時間を劇的に短縮できる実装だ。静的キャッシュの読み込み速度やメモリ使用量も大幅に改善されている。
n-gramキャッシュ構造の刷新とドラフト速度の向上
llama.cppのprompt lookup decodingは、n-gramモデルをドラフトモデルとして用いてトークン生成を高速化する仕組みだ。既存の実装ではキャッシュデータ構造としてstd::unordered_mapが多用されており、ハッシュ衝突時のリンクリスト走査でキャッシュ非効率が生じていた。
Tirmazi氏は外側のマップをankerl::unordered_dense::segmented_mapに置き換え、内側のマップの不要なコピーを参照読み込みに変更したPRを作成した。これにより静的キャッシュの読み込み速度が1.41倍から1.65倍向上し、ドラフト速度は最大25.6倍高速した。
This immediately made drafting 4.5x to 25.6x faster depending on the size of the corpus
これにより、コーパスのサイズに応じてドラフト速度が4.5倍から25.6倍高速化した。
さらに内側のマップも統計的にfollowerが少ない2-gramの性質を活かし、ソート済みstd::vectorと固定長二分探索に切り替えた。これにより静的キャッシュ使用メモリが最大1.97倍削減され、ドラフト速度も最大2.09倍高速化した。全体最適化により最大25.6倍に達する。
Daniel Lemire氏は不変マップconstmapを適用し、読み込み速度をさらに6.32倍から16.12倍に引き上げた。541MBのWikiText-103コーパスでは読み込み時間が3.76秒から0.23秒に短縮された。
Compared to the sorted vectors, it makes loading the static cache 6.32x to 16.12x faster, from 3.76 s to 0.23 s with the 541 MB corpus.
ソート済みベクトルと比較すると、541MBのコーパスで読み込み時間が3.76秒から0.23秒に短縮された。
ドラフトトークンの採用には、コンテキストキャッシュとダイナミックキャッシュの閾値がハードコードされている。コンテキストキャッシュではnが1から4の場合、出現回数の閾値は2から1、確率閾値は0.66から0.5だ。ダイナミックキャッシュでは出現回数の閾値が4から2、確率閾値が0.75から0.66に設定されている。
静的キャッシュのみを使用する場合は、出現回数が2以上で確率が50%以上の場合にドラフトが採用される。静的キャッシュに一致するトークンには100倍の重みが付き、一致しない場合は1倍として評価される。
Apple M4 Pro環境でのベンチマークとアルゴリズムの進化
最適化の検証はApple M4 Pro搭載の14コア/48GBメモリ環境で行われた。コンテキストサイズは4096トークンに固定し、WikiText-103のトレーニングテキストから構築した静的キャッシュを用いて評価した。
n-gramキャッシュはコンテキストキャッシュ、ダイナミックキャッシュ、静的キャッシュの3種類で構成される。コンテキストキャッシュは現在処理中のトークンを記録し、ダイナミックキャッシュは過去の対話履歴を保存する。静的キャッシュはllama-lookup-createツールで事前に構築され、推論中は変更されない特性を持つ。
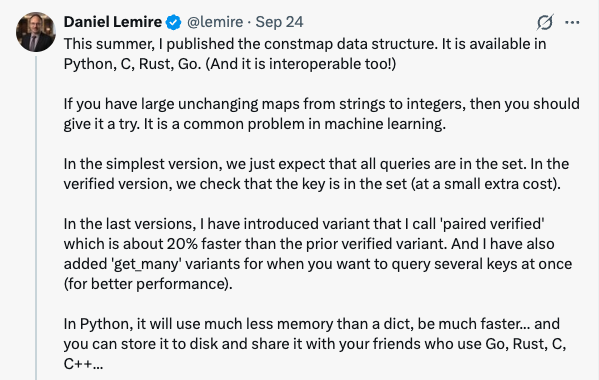
下の画像はLemire氏が公開した不変マップconstmapの概要を示している。
内側のマップ構造をソート済みベクトルに変更した際、頻出する2-gramの検索遅延を防ぐため、二分探索のループ条件を分けた。比較結果に依存せずカウンターを減算する方式に改めたことで、CPUはメモリ読み込み完了を待たずに次の候補を検索できる。検証ではコーパスサイズを0から200MBまで変化させ、静的キャッシュの有無による性能差を観測した。
静的キャッシュなしではドラフト速度が最大25.6倍向上し、静的キャッシュありでも読み込み時間の大幅短縮が確認された。
検証結果は3回のランの中央値で報告され、エラーバーは最小値と最大値を表示している。スコア計算では、静的キャッシュの一致度合いに応じて重みが100倍に調整される。Tirmazi氏のアルゴリズム変更では、トークン採用率は元の処理とほぼ同等に保たれている。
Daniel Lemire氏の追加最適化とリポジトリへのマージ状況
Tirmazi氏の最適化PRに対して、Daniel Lemire氏がスコア計算の順序を最適化する追加PRを送った。従来は全候補トークンのスコアを計算してから閾値判定を行っていたが、最も頻度の高いfollowerのみ先に判定し、失敗すれば他の候補をスキップする仕組みだ。これにより静的キャッシュ利用時は最大4.2倍、非利用時は最大1.9倍のドラフト速度向上が記録された。
下の画像はLemire氏が追加PRで提案した閾値チェックの改善点を示している。
ハッカーニュースではLemire氏の貢献が評価され、ベンチマーク結果の追記と記事へのクレジット表記が予定されている。Tirmazi氏はllama.cpp公式リポジトリへのPR作成が対人関係の問題により制限されていると明かした。メンテナへの直接連絡が重ならないよう配慮しながら、最適化の統合を進める方針だ。
技術ブログの公開日は2026年9月26日だ。Lemire氏のPRはGitHub上で公開され、Tirmazi氏がベンチマークを追加して記事に反映させる予定である。
RedditのLocalLLaMAスレッドでは、対人関係の問題がいつ解決するかについて議論が交わされている。Tirmazi氏はメンテナへの直接連絡を避けるため、PRの統合を慎重に進めている。
公式リポジトリへの統合とベンチマーク追記の予定
Lemire氏の追加PRは現在マージ待ちの状態だ。Tirmazi氏は自身のブログ記事にベンチマーク結果を追記し、最適化の全体像を公開する予定である。静的キャッシュのピークメモリ使用量は最大1.30倍に削減され、ファイルサイズとほぼ同等の463MBに収まっている。
対人関係の問題がいつ解決するかは未確定だが、llama.cpp公式リポジトリへのIssue作成とPRマージは順調に進む見込みだ。2026年9月26日に公開された技術記事は、ローカル推論エンジンの最適化手法として参照されるだろう。
静的キャッシュのメモリ削減により、48GBメモリ搭載のApple M4 Proでも余裕のある動作が期待できる。ファイル全体を1つのバッファに読み込み、その中にconstmapを開く方式だ。今後は他の推論エンジンへのアルゴリズム移植や、異なるコーパスサイズでのベンチマーク結果が公開される見込みだ。
出典
- 42x faster prompt lookup drafting in llama.cpp(Hacker News) · 議論