SketchSSMでハイブリッドアテンションモデルの推論速度を約2倍から7倍に向上
30秒でわかる内容解説
ソウル国立大学ARCらが公開したSketchSSMは、ハイブリッドアテンションモデルの推論速度を大幅に向上させる手法である。フルのステートを維持しつつ読み取りをコンパクトなスケッチで近似する仕組みにより、アクセストラフィックを約10倍削減できる。ローカル環境でMamba-2やGDNなどのモデルを動かす技術者向けに、vLLM対応ライブラリも提供されている。これによりGPUのメモリ帯域を効率的に使い、バッチサイズを大きくしても高速な生成が可能になる。
フルステートを維持しスケッチで読み取る最適化手法
SketchSSMは線形アテンション(重み計算を単純化しメモリ使用量を削減するアテンション方式)を採用したモデルにおける推論ボトルネックを解消する。
従来の手法ではステートサイズを削減すると近似誤差が蓄積したが、SketchSSMは更新をフルで行い読み取りのみを近似する。
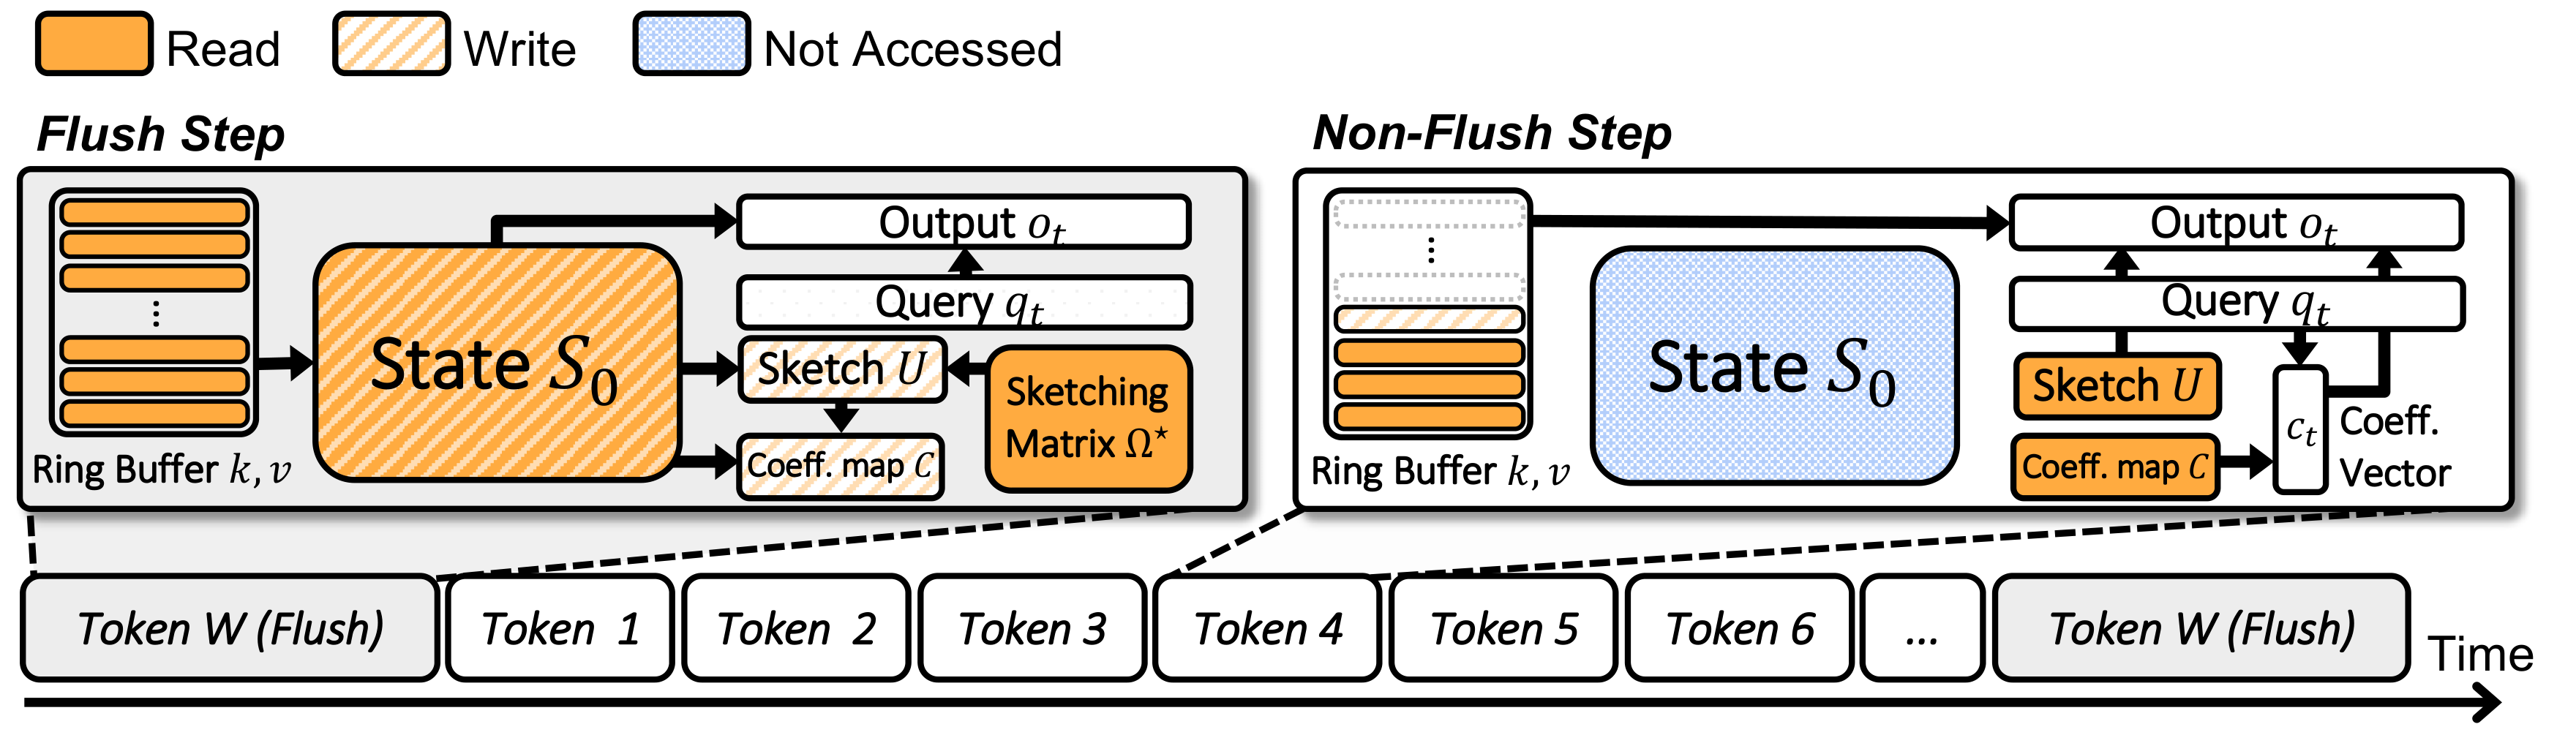
一定ステップごとにフルステートを一度読み取り、リングバッファ内の更新を適用してコンパクトなスケッチを計算する。
以降のステップではこのスケッチとクエリ係数を組み合わせるだけで出力を再現できる。
これによりメモリ帯域の消費を約10倍抑えながら精度をほぼ維持する。
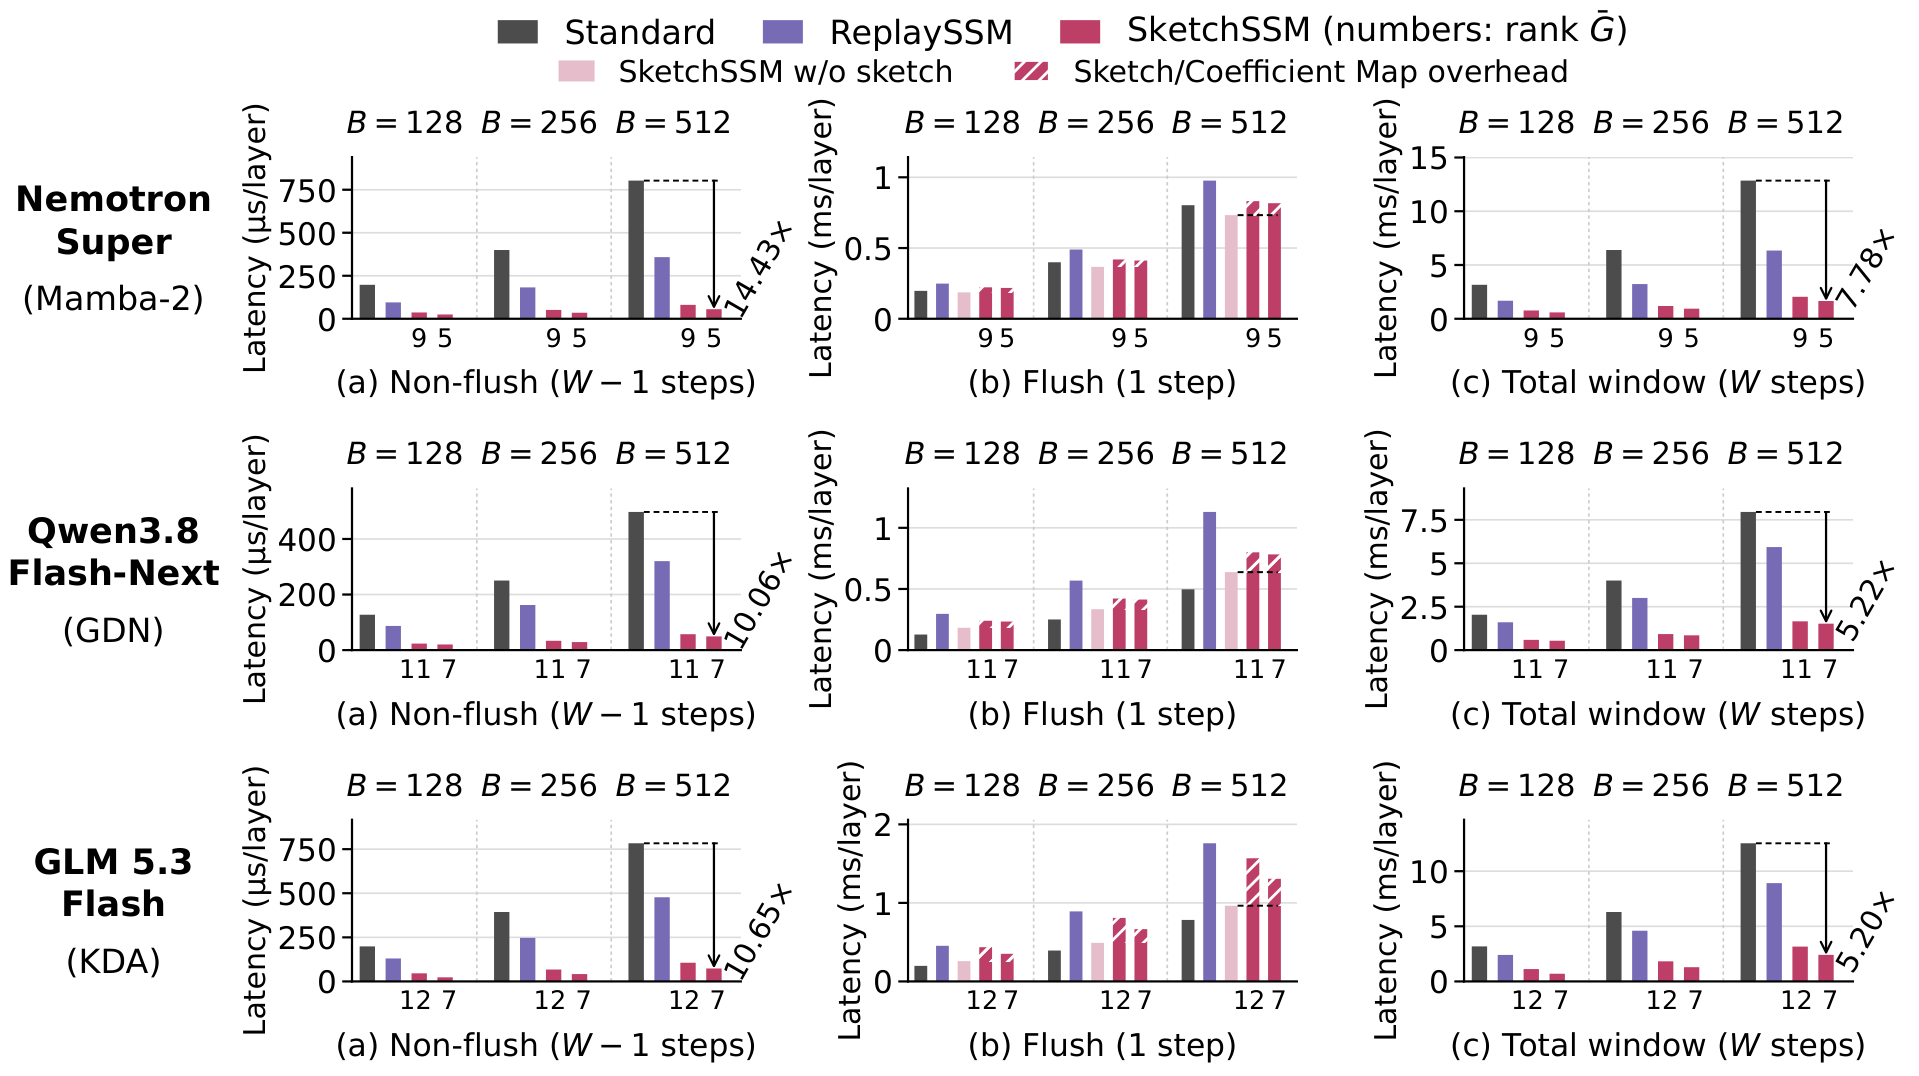
NVIDIA B300上ではバッチ512でNemotron 3 Superを7.78倍、Qwen3.8 Flash-NextとGLM 5.3 Flashを約5.2倍高速化した。
vLLM(LLMの高速推論を可能にするオープンソースの推論エンジン)に対応したライブラリとして公開されており、Hugging Face Hubからキャリブレーションファイルを取得するだけで容易に導入できる。
デフォルトのスケールパラメータでは約10倍の削減が実現するが、パラメータを調整することで帯域と精度のトレードオフを制御できる。
下図は1ウィンドウ内のステップ処理を示している。
Mamba-2やGDNが普及する中でのメモリ帯域課題
ハイブリッドアテンションモデルは、大半のソフトマックスアテンション層を線形アテンションに置き換えることでKVキャッシュ(生成過程で使用する過去のトークン情報を格納するメモリ領域)の成長を抑制する。
これによりデコード時のバッチサイズを大きくできるが、再帰的ステートの読み取りが新たなボトルネックとなった。
ReplaySSMはWステップ分のキーと値をバッファリングし、一度にフルステートに適用する手法であった。
しかし新しいクエリが来るたびにフルステートの読み取りが必要だった。
SketchSSMはこの読み取りコストを削減するために考案された。
剪定や量子化手法では小さな削減率で精度が低下するのに対し、SketchSSMはMATH-500やAIME25などのベンチマークで約10倍のトラフィック削減まで精度を維持した。
RTX PRO 6000 Blackwell上ではNemotron Nano 9B v2を用い、バッチ320で7,634 output tokens/sを達成した。
スケッチ行列(データを圧縮して推論速度を向上させるための行列)はモデルごとにオフラインキャリブレーションで計算され、推論時の精度安定に寄与する。
NVIDIA B300での線形アテンションレイテンシは以下の通りだ。写真ではNVIDIA B300上での線形アテンションレイテンシ比較が示されている。
ベンチマークで剪定・量子化手法を上回る安定性
公開された評価結果では、SketchSSMが従来手法を大きく上回る性能を示した。
Mamba-2、GDN、KDAモデルのすべてでステートアクセストラフィックを約10倍削減しながら、精度をほぼ維持することに成功した。
ReplaySSMと比較しても推論速度で1.64倍の差をつけている。
平均精度は76.2前後で、ベースラインの76.6とほぼ同等だった。
vLLMの標準実装との比較では、Nemotron Nano 9B v2で2.26倍の高速化を記録した。
精度とトラフィック削減の関係をベンチマークで確認すると、以下の結果が得られた。
剪定や量子化手法では小さな削減率で精度が低下するのに対し、SketchSSMはMATH-500やAIME25などで高い安定性を維持した。
デモ動画ではRTX PRO 6000 Blackwell上でIFEvalやMATH-500の生成をバッチ320で実行し、7,634 output tokens/sの速度を示した。
動画ではデコード処理を8倍速で再生しており、リアルタイム性の向上が確認できる。
技術者からはメモリ帯域の節約と推論速度の向上が両立できる点が高く評価されている。
対応モデルの拡大とvLLM統合の将来
資料に記載されたモデル群に限定して評価が行われているため、今後は他のハイブリッドアテンションモデルへの対応拡大が期待される。
SNU-ARCはHugging Face Hubでキャリブレーションファイルを提供しており、新しいモデルでのオフラインキャリブレーション手順も公開している。
vLLM v0.30.0をフォークしたディレクトリに実装が格納されており、CUDAカーネルとTritonカーネルの切り替えも可能だ。
2026年10月2日にGitHubとarXivで公開されたSketchSSMは、今後さらに多くのローカル推論環境で採用される見込みである。
現在対応が確認されているモデルとキャリブレーションファイルの対応関係は以下の通りだ。
| モデル名 | キャリブレーションファイル |
|---|---|
| Nemotron Nano 9B v2 | SketchSSM/Nemotron-Nano-9B-v2-BF16 |
| Nemotron 3 Super | SketchSSM/Nemotron-3-Super-NVFP4 |
| Qwen3.8 Flash-Next | SketchSSM/Qwen3.8-Flash-Next-NVFP4 |
| GLM 5.3 Flash | SketchSSM/GLM-5.3-Flash-NVFP4 |
| Qwen3.5 9B | SketchSSM/Qwen3.5-9B-BF16 |
各モデルごとに精度を最適化するパラメータ調整が必要になるが、vLLMのCLIオプションで簡単に有効化できる。
--sketchssm-mean-rankパラメータでスケールを調整可能だ。
Apache License 2.0で公開されており、pip install sketchssmでCUDAカーネルを追加できる。
技術者は自前のGPU環境でより高速な推論パイプラインを構築できるようになる。
用語の注釈
- vLLM
- ローカルLLMの推論を爆速化するオープンソースエンジン。KVキャッシュのメモリ断片化を解消し、OpenAI互換APIで自前GPUを高速に動かせる。(参考:vLLMってなんだ? 〜ローカルLLM推論を爆速化するOSSエンジン ...)
出典
- SNU-ARC/SketchSSM: SketchSSM: Write to the Full State, Read from a Compact Sketch(GitHub topic llm-inference)