NVIDIA RTX 5090最適化推論エンジン MegaCapybara が公開
25秒でわかる内容解説
開発者 perkel666 が 2026 年 10 月 3 日、NVIDIA RTX 5090 向けに最適化された推論エンジン MegaCapybara を公開した。Qwen3.8-27B モデルの高速推論を実現し、単一エージェントで最大 500 トークン/秒、複数エージェント合計で最大 2,000 トークン/秒の速度を達成している。自作PCでLLMを動かす愛好家にとって、カードの性能を最大限引き出す新形式の重みとマルチエージェント対応は実用的な選択肢となる。
RTX 5090専用カーネルと双方向API対応
MegaCapybara は NVIDIA RTX 5090 の Tensor Core がネイティブで処理できる 4 ビットおよび 6 ビット形式の重み MXFP4 と MXFP6 を採用している。各推論ステップはメモリからの重み読み出しにほぼ匹敵する速度で動作する。単一エージェントでは最大 500 トークン/秒の速度を記録した。
Each step takes barely longer than reading the weights from memory once, which is the card's hard limit.
各ステップはメモリからの重み読み出しにほぼ匹敵する速度で、カードの性能限界に近い。
複数エージェントの同時実行時には合計で最大 2,000 トークン/秒の速度を記録した。OpenAI 互換 API と Anthropic API の両方をサポートしており、既存のクライアントツールからそのまま利用可能だ。ツール呼び出しや思考プロセス、画像生成にも対応している。
OpenCode や Cline などの OpenAI 互換クライアントは `http://127.0.0.1:8080/v1` を、Claude Code は `http://127.0.0.1:8080` をベースURLに設定する。ランチャー付属のバッチファイル(Windows)やシェルスクリプト(Linux)を使えば Windows と Linux の両環境で即座に起動できる。
共有コンテキストプールと予測推論の仕組み
複数のエージェントが同時に動作する環境向けに、連続バッチ処理と共有コンテキストプールが実装されている。アイドル中のエージェントはメモリを消費せず、タスクに合わせてフルコンテキストを利用できる。100Kトークンを超えるプロンプトでも、エージェント間の書き込みを妨げずに逐次読み込まれる。
メモリ管理には 512 トークン単位のページ分割と、不足時に idle な会話を RAM やディスクに退避させる queue-aware eviction が採用されている。
推論速度の向上には speculative decoding が活用されている。小さなドラフトモデルが次に生成されるトークンを予測し、メインモデルが一括で検証する仕組みだ。コード生成では 3 から 4 倍の高速化が期待できる。さらに confidence scheduling により、会話ごとに受け入れられるトークン数を動的に調整する。写真では Windows Terminal のサーバーのダッシュボードがある。
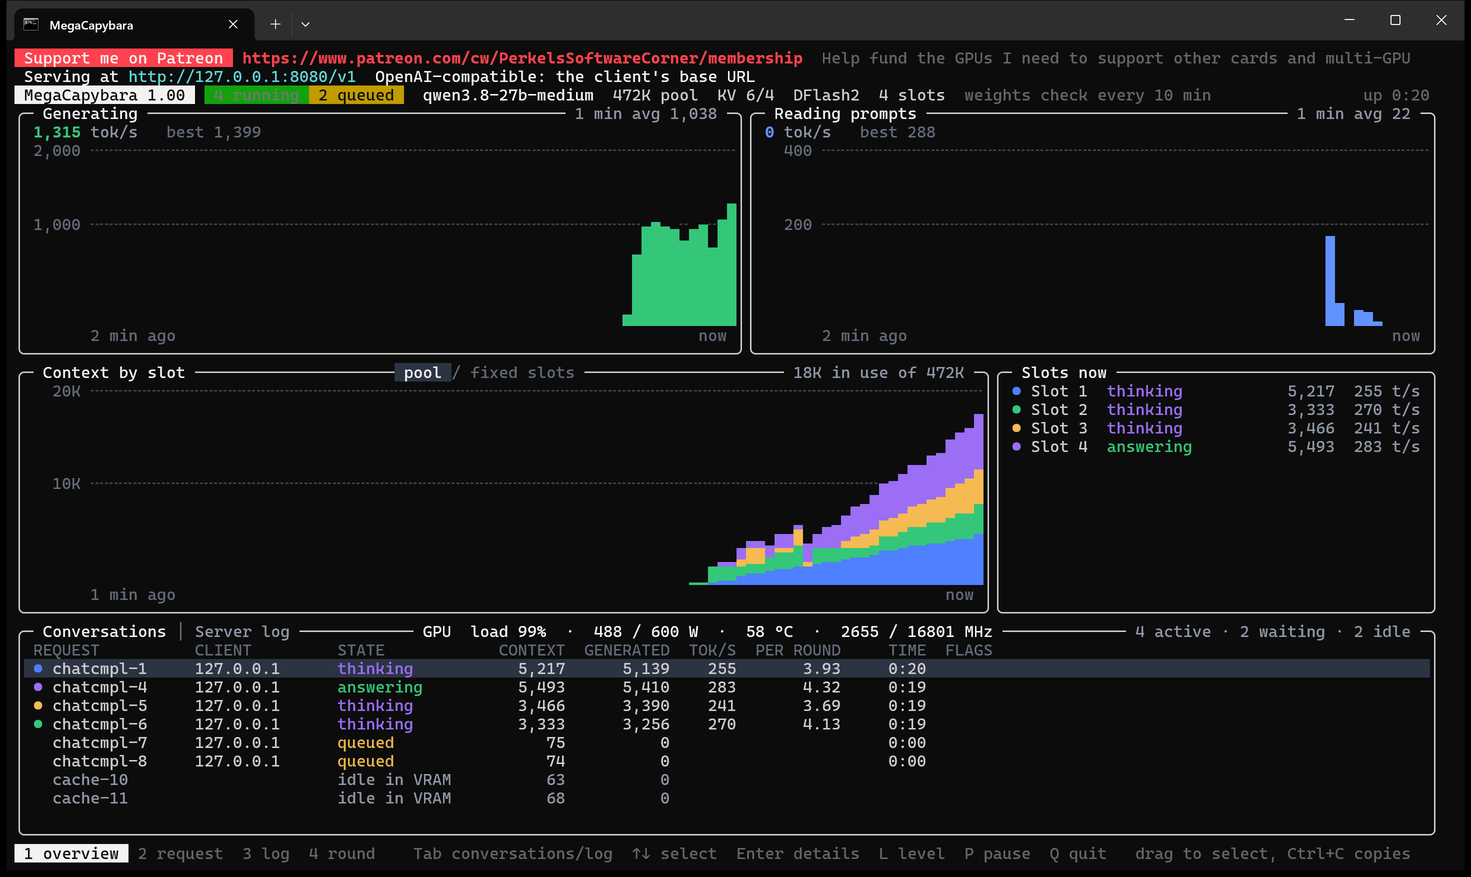
起動前に各設定が精度・速度・メモリに与える影響を可視化するランチャーも付属している。下の画像では Windows Terminal でサーバーのダッシュボードが表示されており、4つのエージェントが書き込み中、2つが待機している様子を確認できる。ユーザーは読み込み前にトレードオフを直感的に把握できる。
モデルサイズ別の性能比較と精度評価
公開されたモデルは Qwen3.8-27B の元 weights を変換した 5 種類のサイズで提供されている。Tiny から Small にかけて VRAM 使用量が 12.70 GiB から 13.67 GiB に抑えられ、Top-1 agreement は 92.7 パーセントから 93.8 パーセントを記録している。
Medium は 15.39 GiB で 95.2 パーセント、Large と XXL はそれぞれ 18.66 GiB と 23.58 GiB を消費する。写真ではサイズ別の Top-1 agreement 比較グラフが示されている。
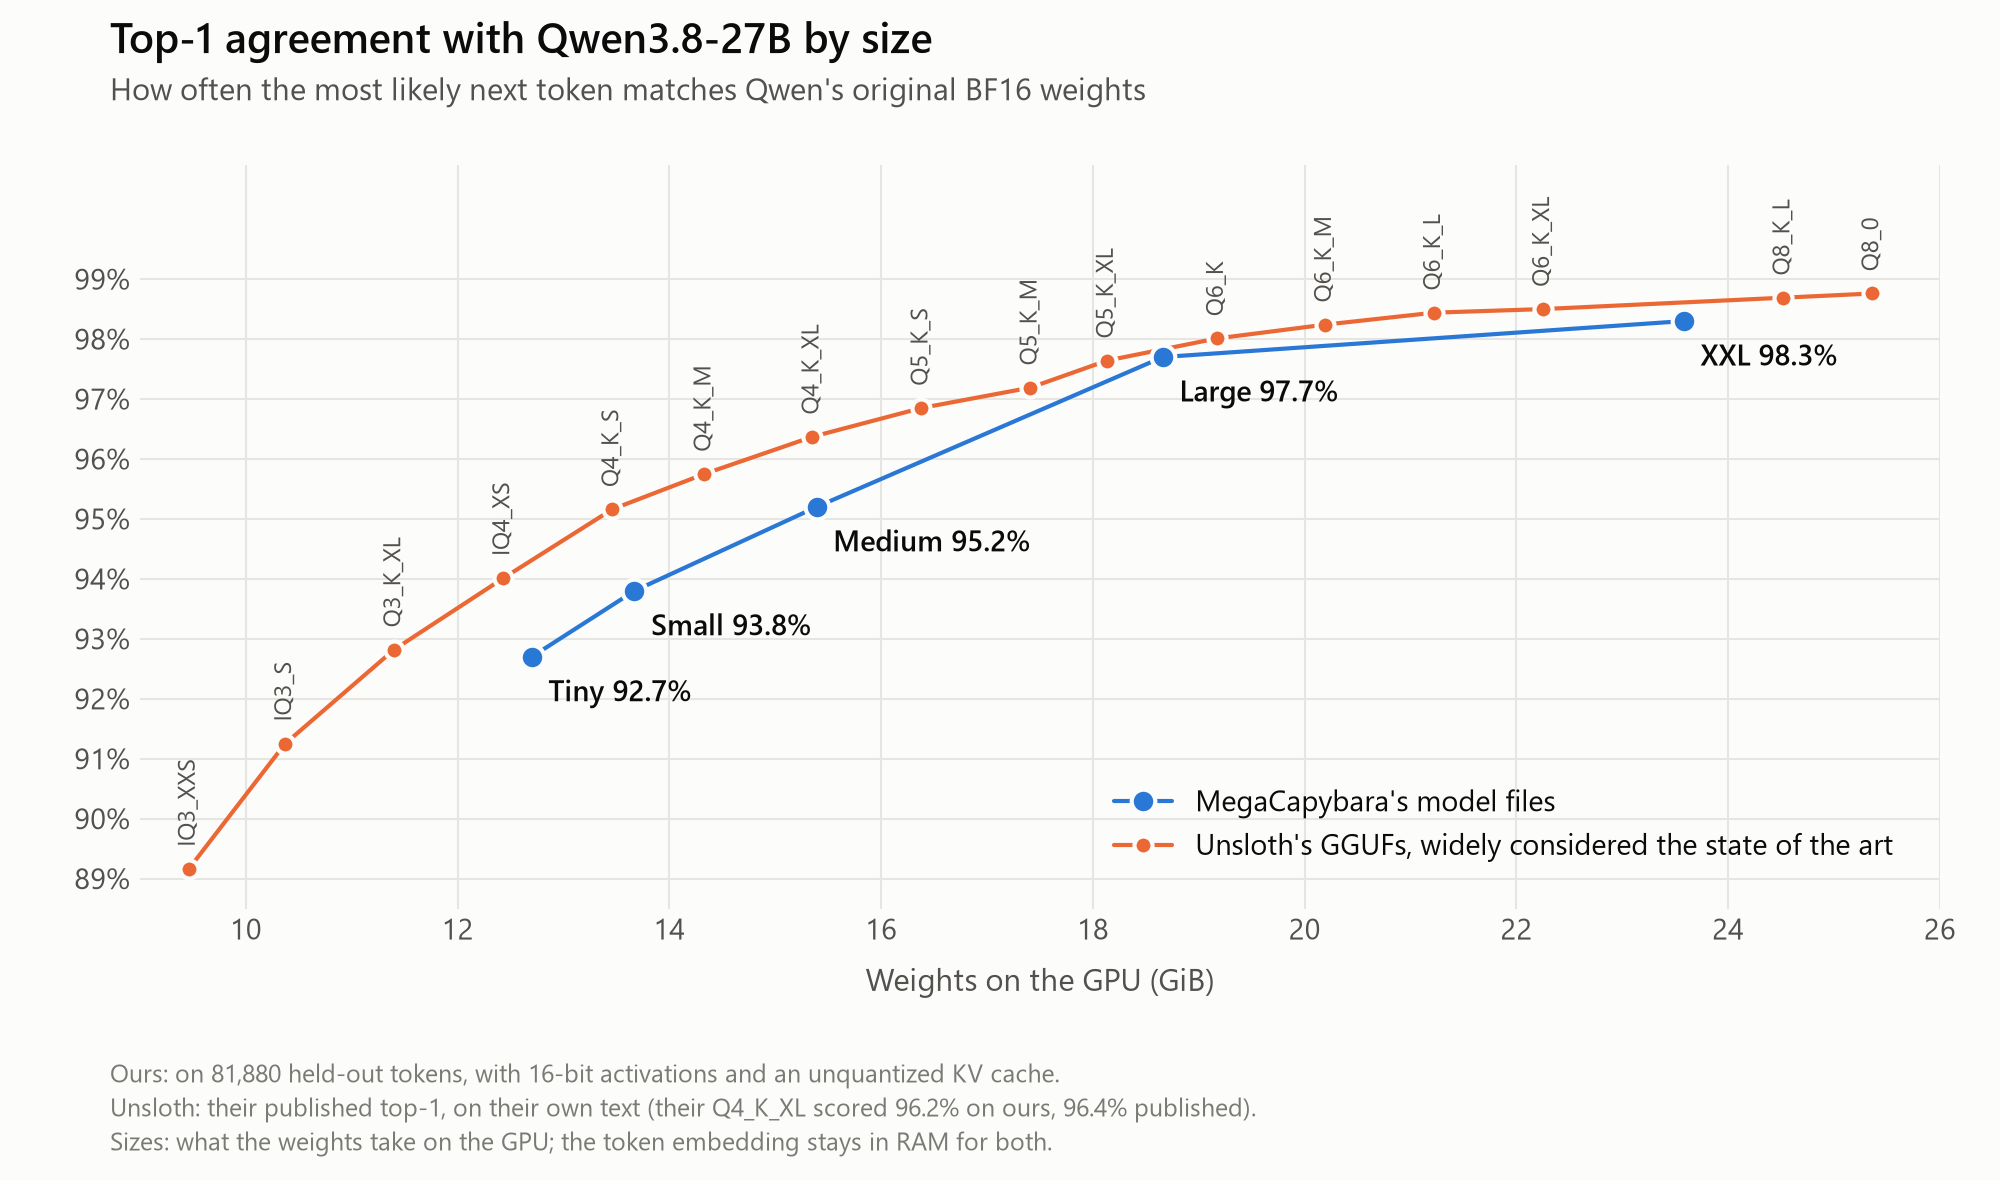
元 weights との比較では、同等サイズで Unsloth の GGUF 量子化の方がわずかに精度が高い傾向にある。ただし MegaCapybara は RTX 5090 向けの専用カーネルを利用するため、推論速度で優位性を発揮する。下のグラフはサイズごとの Top-1 agreement を示しており、重み形式の違いが速度と精度のバランスにどう影響するかを視覚的に理解できる。
拒否回答を除去した Uncensored バージョンも用意されており、ランチャーから最大 8 並列でハッシュ検証付きダウンロードできる。
| モデルサイズ | VRAM使用量 | Top-1 agreement |
|---|---|---|
| Tiny | 12.70 GiB | 92.7% |
| Small | 13.67 GiB | 93.8% |
| Medium | 15.39 GiB | 95.2% |
| Large | 18.66 GiB | 97.7% |
| XXL | 23.58 GiB | 98.3% |
ソースコード公開予定と環境要件
現時点でソースコードは非公開だが、今後は公開される予定である。Windows 11 と Linux x86-64 に対応し、ドライバー R580 以降と 32 GB のシステムメモリが必要だ。ディスク容量はモデルサイズにより 15 GB から 30 GB 程度を要する。Linux 環境では X11 や Wayland に対応したランチャーが利用でき、WSL2 や SSH 経由でもサーバー単体で動作できる。
ランチャーの右下にあるコピーボタンを押せば、選択した設定のフルコマンドラインが生成される。ターミナルやスクリプトに貼り付けて再利用できる。Patreon での支援により次世代 GPU やマルチGPU構成のサポートが進められる計画だ。2026 年 10 月 3 日の公開以降、GitHub と Hugging Face でアーカイブが配布されている。