Base Computeが公開したローカルLLM推論用統一サービングデーモンsuperfluid
30秒でわかる内容解説
Base Computeは10月8日、ローカルPCで動作するLLM推論用の統合サービングデーモンsuperfluidを公開した。llama.cppやMLXなど複数の推論ランタイムを1つのデーモンで管理し、チャット応答の高速化や共有プロンプトの効率的な処理を実現する。自作のコーディングエージェントや既存のクライアントツールを接続できるため、ローカル環境の運用負荷を軽減できる。ローカルネットワークでの分散構成もサポートしており、PC1台から複数台への拡張が容易だ。
単一デーモンで統合する推論管理レイヤー
superfluidは、llama.cpp、MLX、baseRTの各推論ランタイムの前に、共通のスケジューラと永続的なセッションログ、統一APIを配置する。モデルファイルの形式に応じて適切なランタイムを自動選択し、それぞれを独立したワーカープロセスとして起動する。
superfluid puts one scheduler, one durable session log and one set of APIs in front of llama.cpp, MLX and baseRT.
superfluidは、llama.cpp、MLX、baseRTの前に、共通のスケジューラ、永続的なセッションログ、統一APIを配置する。
対話型のチャットリクエストは、バッチ処理の合間に割り込める設計だ。Apple M5 ProでQwen3-4Bを用いたベンチマークでは、8つのエージェントが並行稼働中でも初回トークン生成が0.79秒で完了した。一方、各ランタイム単独のサーバーでは64秒から120秒を要した。
また、5kトークンのプロンプトを32リクエストで共有する場合、prefill(プロンプトの内部状態計算)は1回のみで済む。セッションログによりサーバー再起動後も状態が維持され、コミットされたトークンは失われない。
Apache-2.0ライセンスで公開され、デフォルトではループバックアドレスにバインドする。外部キーを指定しない限り認証が不要で、外部サーバーへの通信も発生しない。
curlコマンドでhttp://127.0.0.1:8453/v1/chat/completionsにアクセスすれば、OpenAI互換のJSON形式でリクエストを送れる。superfluid launchコマンドでコーディングエージェントを起動することも可能だ。
既存ランタイムの差異を吸収するアーキテクチャ
ローカル環境では、Apple Silicon向けに最適化されたMLXや、GGUFに対応したllama.cpp、そしてBase Compute独自のbaseRTなどが並存している。superfluidはこれらの差異を内部で吸収し、統一されたインターフェースを提供する。
下図は、クライアントがsuperfluidサーバーに接続し、複数のマシン上のワーカーを駆動する構成を示している。
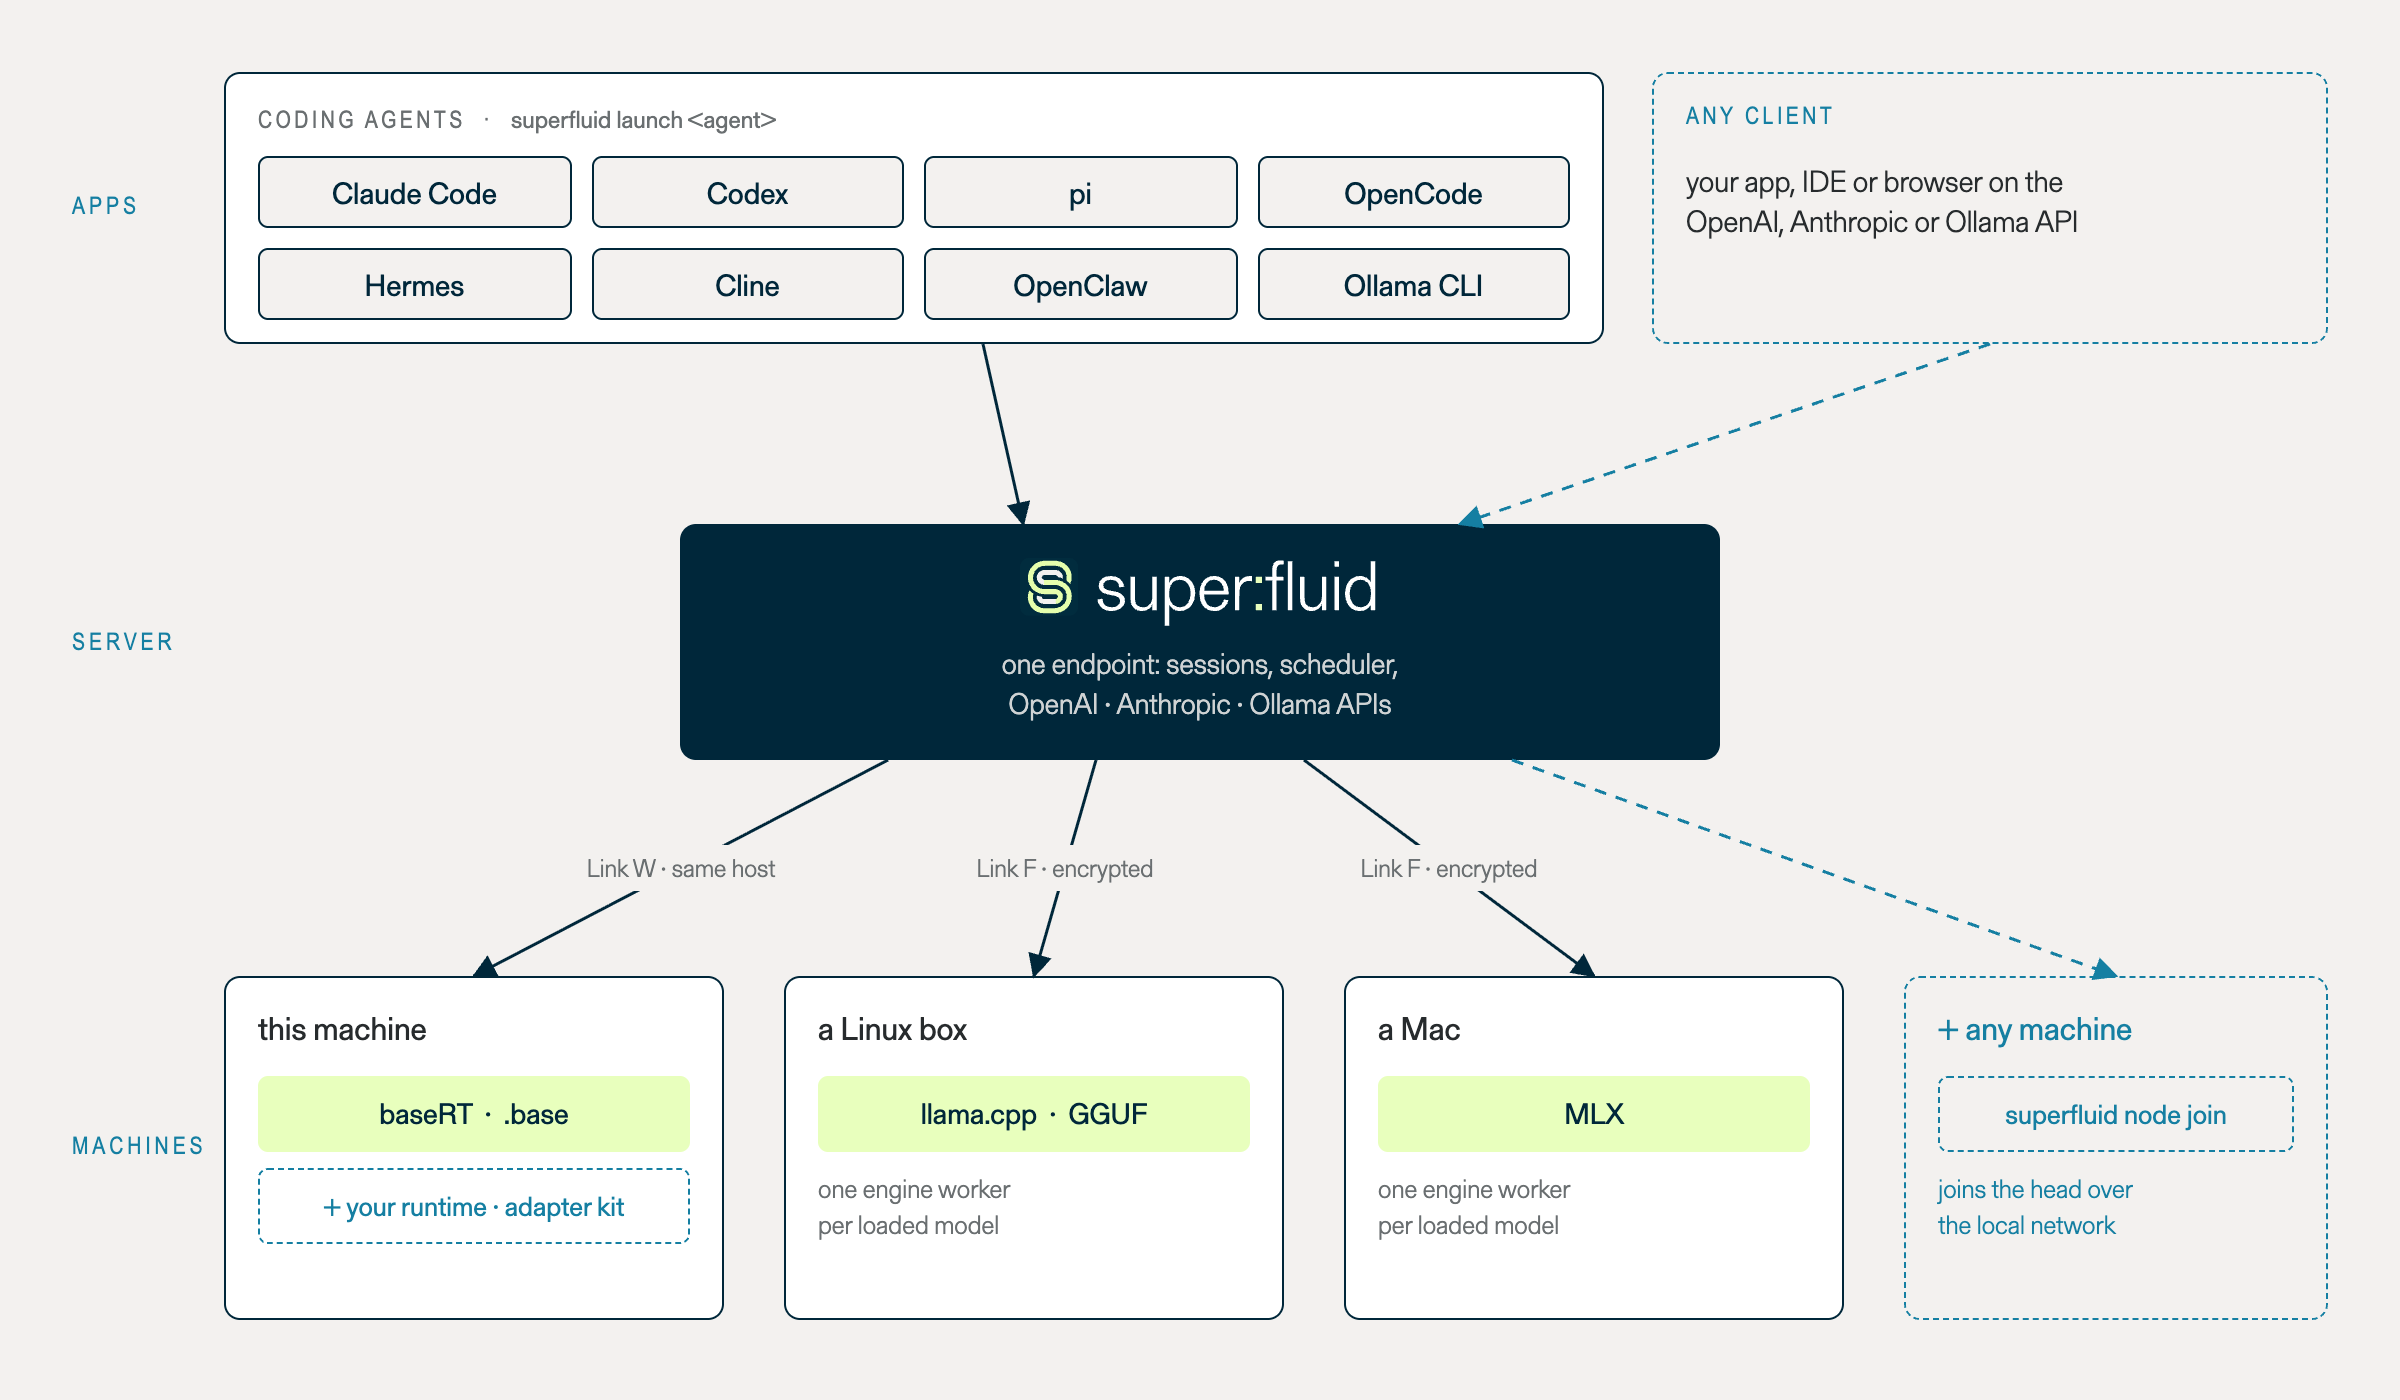
写真では、コーディングエージェントやAPIクライアントが中央のsuperfluidサーバーと接続し、その先でbaseRT、llama.cpp、MLXのワーカーが分散して動作している様子が確認できる。
GGUFファイルはllama.cppのリリースビルド、MLXディレクトリはmlx-lm付きのプライベートPython、.baseバンドルはbaseRTエンジンライブラリによってそれぞれ処理される。
インストールはスクリプトをパイプするだけで完了し、superfluid serveコマンドでモデルを指定して起動できる。ローカルネットワーク上に別のマシンを追加すれば、暗号化リンクで分散サービングを構築できる。
baseRTエンジンは独立した製品だが、リポジトリにはオープンライセンスのヘッダーが含まれる。インストール時に別個に読み込まれるため、superfluid本体のライセンスとは独立している。
パフォーマンス比較で目立つ応答速度の差
公開直後から、既存の競合ランタイムとのベンチマーク結果が提示されている。8つのエージェントが並行稼働する環境でのチャット応答速度は、superfluidが0.79秒に対し、llama-serverが67秒、Ollamaが64秒、mlx_lm.serverが120秒だった。
| 項目 | superfluid | 他社ランタイム |
|---|---|---|
| 8エージェント背後の初回トークン生成 | 0.79 s | 64 s〜120 s |
| 5kトークン共有時のprefill回数 | 約 1 | 約 8 |
| 通過した提供シナリオ数 | 8 | 1〜5 |
表を見ると、共有プロンプトのprefill回数はsuperfluidが約1回であるのに対し、他社ランタイムは約8回となっている。これにより、長文ドキュメントを参照するバッチ処理時のリソース消費を大幅に削減できる。
提供シナリオ8つのうち、superfluidはすべてをパスした。llama-serverは3つ、Ollamaは5つ、mlx_lm.serverは1つだった。この結果は、Apple M5 Pro上でQwen3-4Bを用いた同一条件のテストに基づいている。
ベンチマークの詳細はGitHubのドキュメントに記載されている。同時1リクエストと8リクエストの両方で、llama.cppを介したsuperfluidはllama-serverのトークン生成速度に追従している。
比較対象の各ランタイムは、それぞれ独自のサーバープロセスを起動している。superfluidはスケジューラを1つに集約する設計のため、プロセス間のオーバーヘッドが最小限に抑えられている。
ホワイトペーパー公開とインターフェースの安定化
superfluidは今後、公式ホワイトペーパーの公開を見拠えている。論文が発表されるまでは、GitHubのリポジトリ名と著者名、2026年の年を記載して引用する必要がある。
現在pre-1.0の段階にあるため、コマンドラインフラグ、通信プロトコル、ディスク上のファイル形式はリリース間で変更される可能性がある。
公式のドキュメントサイトsuperfluid.shでは、クイックスタートからセキュリティ設定、分散ノードの構成まで網羅している。OpenAI互換サーバーやコーディングエージェント、コマンドラインリファレンスへのリンクも整備されている。
Discordコミュニティでは実用例の共有やバグ報告が行われており、Issueトラッカーでは機能リクエストの収集が進む。
セキュリティ面では、ネットワーク公開前に設定を確認する必要がある。セキュリティ報告はIssueトラッカーではなく専用ファイルを通じて受け付ける。
ホワイトペーパーの公開時期は未定である。
用語の注釈
- prefill
- ユーザーが入力したプロンプトをまとめて処理し、最初の出力トークンを生成する段階である。(参考:LLM分散推論サービス入門ガイド ~分散LLM推論基盤を構築 ...)
- GGUF
- llama.cppで主に使用される、ローカル推論向けのモデルファイルフォーマット。(参考:GGUF量子化ってなんだ?〜ローカルLLMを爆速で動かすための ...)