Intel Arc Pro B60で27Bモデルを完全ローカル実行する最適化リポジトリ
40秒でわかる内容解説
開発者edagher92-coderが、Intel Arcシリーズ向けにLLM推論を最適化するリポジトリarc-llm-labを公開した。Qwen3.8-27Bという約16GBの重みを持つモデルを、単一のArc Pro B60(VRAM24GB)で完全ローカル実行する。llama.cppのVulkanバックエンドとIntel製Flash-Attentionカーネル、ドラフトモデルによる推論を組み合わせ、コンテキスト処理速度とエージェントの信頼性をベンチマークした。100タスクの評価でClaude Codeが97/100を達成するなど、実用性を示す数値が公開された。自作PCでAIを動かす技術者にとって、Intel GPUの活用範囲を具体化するデータ提供となる。
Arc Pro B60における実測値とエージェント性能
開発者edagher92-coderがIntel Arc向けLLM最適化リポジトリarc-llm-labを公開した。Qwen3.8-27B(重み16.46 GB)を単一Arc Pro B60(VRAM 24GB)で完全ローカル実行する。llama.cpp VulkanバックエンドとFlash-Attention prefillカーネル、DFlash2ドラフトモデルを組み合わせ最適化した。
標準設定の生成速度16 tok/sに対し、最適化版は42.3 tok/sを記録した。32Kコンテキストでの入力読み込みは118 tok/sから420 tok/sへ向上した。
測定環境はRyzen 7 3700XとWindows 11だ。VRAMはGPUの専用メモリで、AIモデルの重みやデータを保持する。VRAM消費はモデルとドラフトで17.15 GiB。
残り容量で最大64Kのコンテキストウィンドウを確保できる。100タスクの隠しチェッカーによる評価では、Claude Codeが97/100、Codex CLIが95/100を達成した。タスクはコード、デバッグ、ツール使用、ファイル操作、長文書検索、ビジネス計算、エラー回復の7カテゴリに分類される。
写真ではArc Pro B60におけるspeculative decodingのスイープ結果が示され、ドラフトモデル適用で16 tok/sから42.3 tok/sへ向上し、VRAM空き量が不足すると速度が低下する。
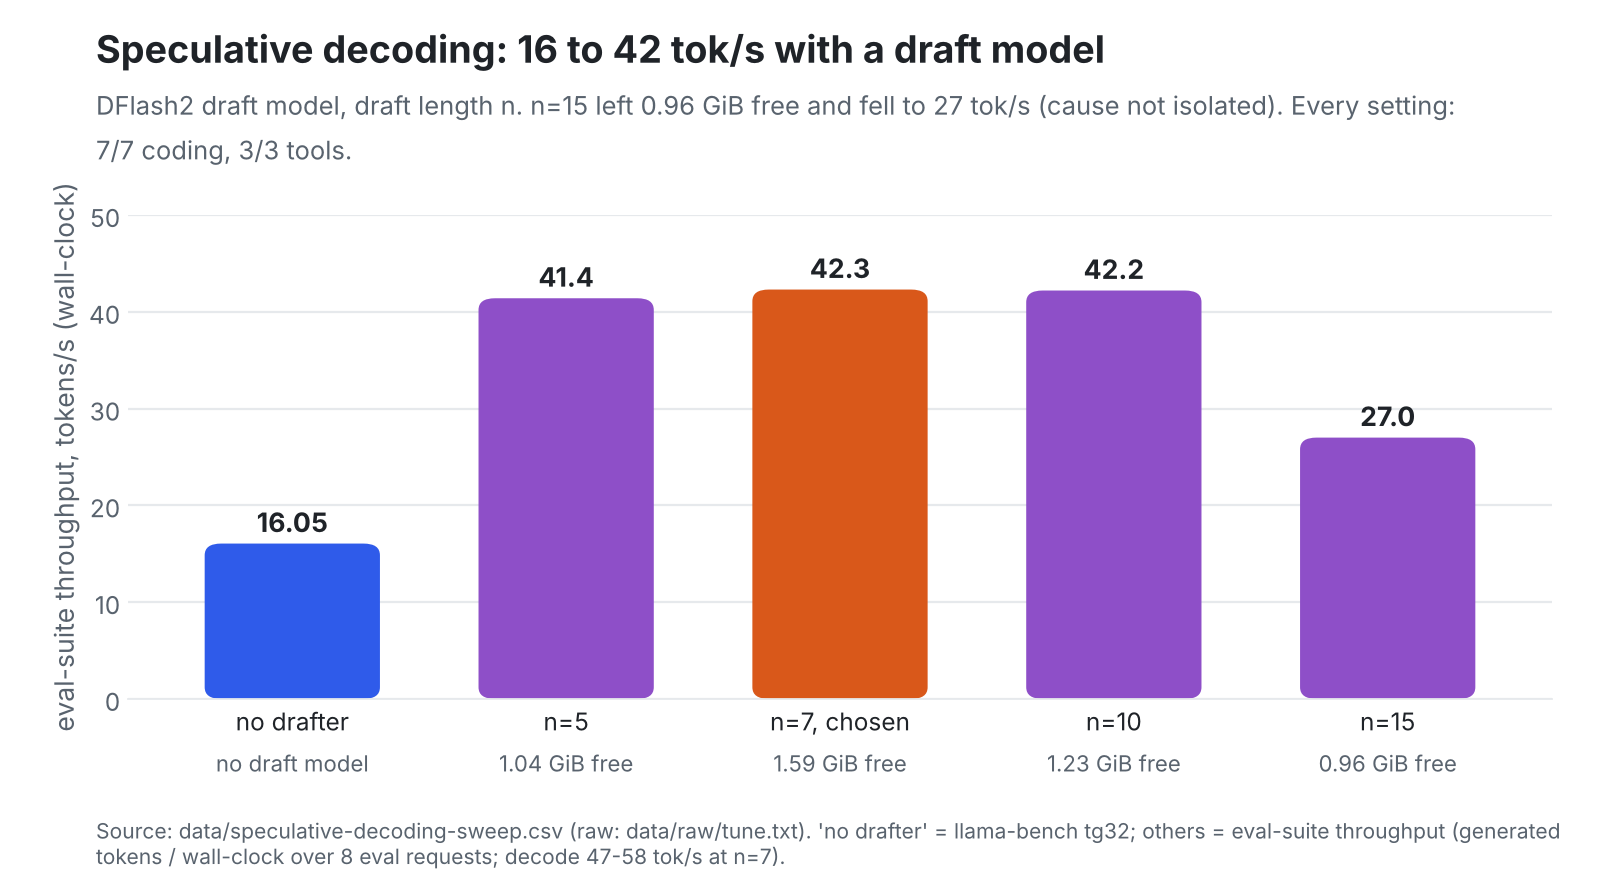
下の画像はspeculative decoding(小さなモデルで推論の骨格を先読みし、大きなモデルで補正する手法)の適用による生成速度の変化を示している。実スループット42.3 tok/sはプロンプト処理を含んだ保守値だが、単一リクエストのデコード速度は47から58 tok/sの範囲にある。
Flash-AttentionカーネルとVRAM管理の経緯
最適化の核はllama.cpp Vulkan向けIntel Flash-Attention prefillカーネルだ。f16のKV cache(コンテキスト情報保持用メモリ)で動作し、32K深度読み込み速度を3.6倍に引き上げた。q4 KV cacheでは効果が出なかった。
カーネルはPR #29357で提供され、2026年9月25日に作者がマージ前にクローズした。リポジトリはb11524ビルドにパッチをバンドルし、チェックサムで整合性を保証している。Windows 11環境ではgitとPythonのみで管理者権限不要のビルドが可能だ。
写真では価格とVRAMの比較グラフが示され、Arc B580とA770は27Bエージェントに必要な21GBのVRAMを下回る一方、Arc Pro B60とRTX 5090はそれを上回る。
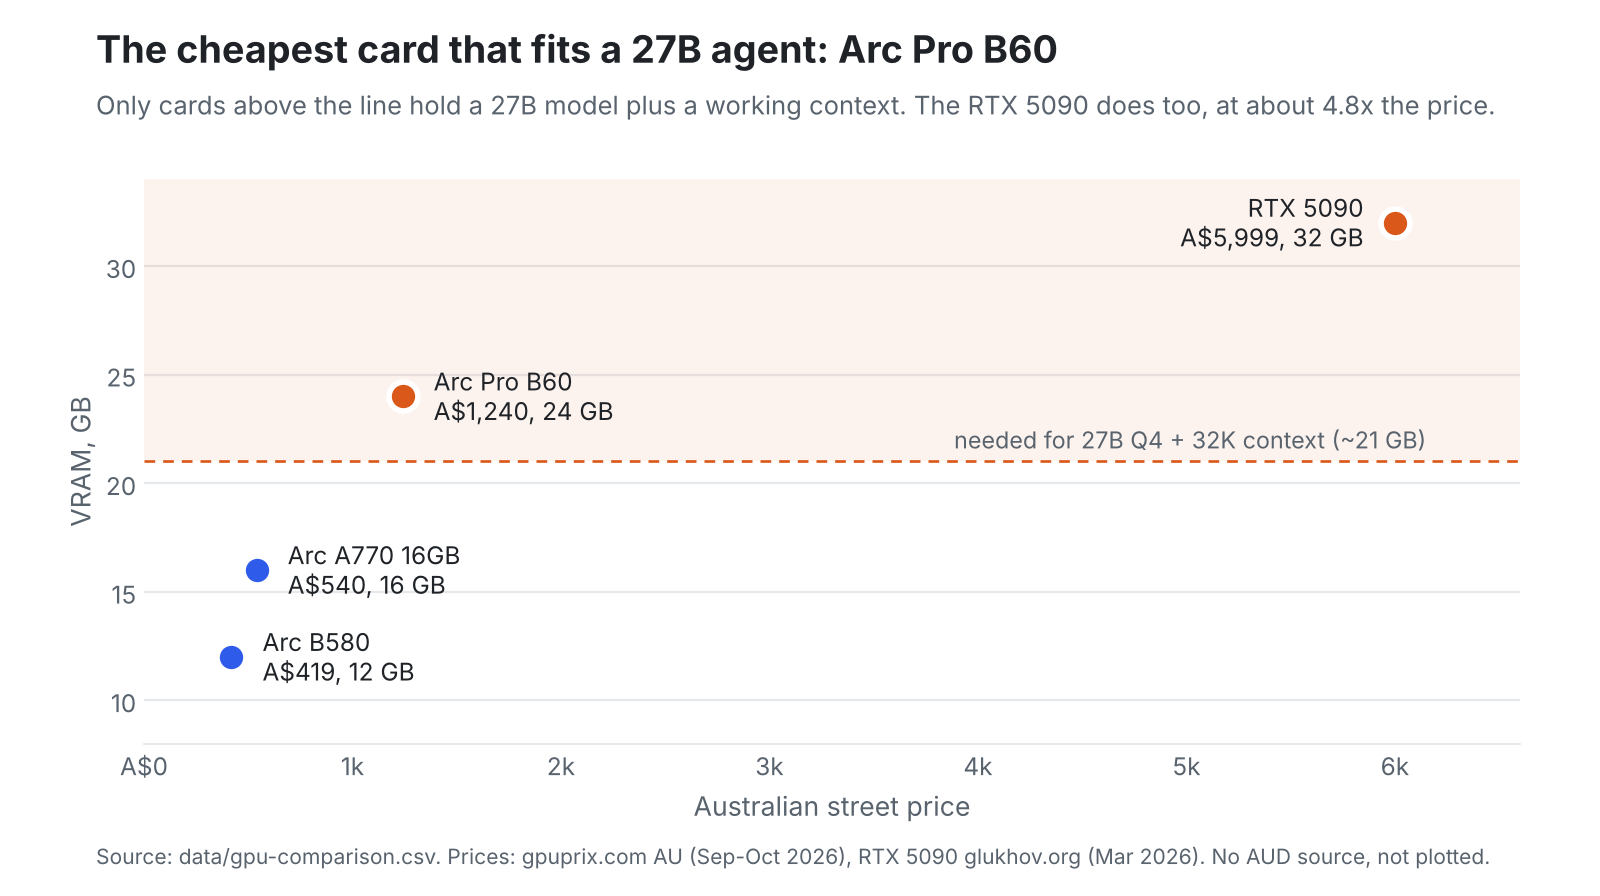
価格とVRAMの関係を下のグラフで確認できる。Arc Pro B60は24GB VRAMと456 GB/s帯域幅を持つ。27Bモデル推論に必要な21GB以上を確保し、比較的低価格で収まる。governorツールはAUTO、MAX、BALANCED、LEANの4プロファイルから自動選択する。
auto-fitをオフにし`-ub 256`とq8ドラフトKV cacheを指定すると0.55 GiB節約になる。これにより57Kから64Kのコンテキスト幅が実現した。コンテキスト超えると`--no-context-shift`でHTTP 400エラーが発生する。OllamaやLM Studioのエンドポイント参照も可能だが、Intel FAカーネルはバンドルされない。
他ベンチマークとの比較とGPU適合範囲
他の技術者も同カードでQwen3.8-27Bを測定している。ある測定ではデコードのみで589から638 tok/sを記録した。OpenVINO環境では657 tok/sに達した。本研究の420 tok/sはプロンプト処理を含めた実スループットのため、読み込み速度では最速ではない。
生成速度は他の測定より高い値を示した。単一カードの最高値を上回り、カスタム量子化を使った41.3から41.9 tok/sの記録とは測定条件が一致しない。方法論の違いが10%以内の差を生むため誤差範囲と見なされる。写真では各種GPUの生成速度上限が比較されている。
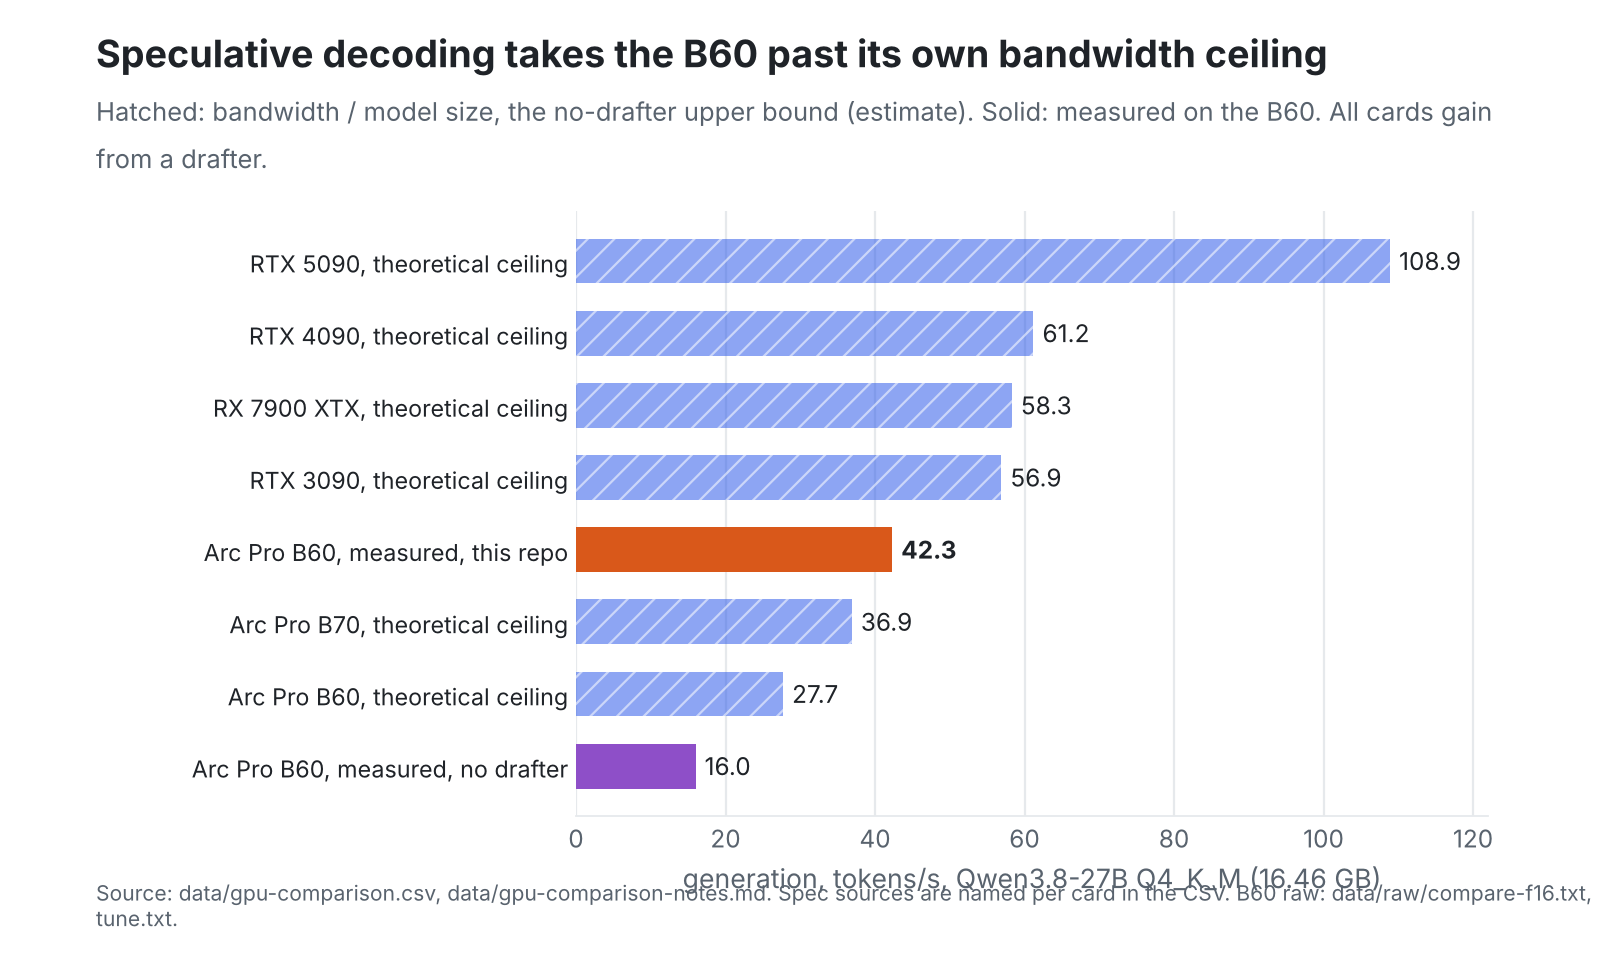
下の画像は各種GPUの生成速度上限を示している。Arc Pro B70は32GB VRAMと608 GB/s帯域幅を持ち、27Bモデルが余裕で収まると推定される。ドラフトなしデコード上限は36.9 tok/sと見積もられている。
B580、B570、A770、B50はVRAMが10から16 GBのため27Bモデルをコンテキスト付きで実行するには不十分と推定される。最も帯域幅が狭いB50はモデル1GBあたりのデコード速度が最も遅くなる。RTX 3090やRX 7900 XTXも24GBで収まり、帯域幅936 GB/s以上で理論上限は56 tok/sを超える。
市場価格とLinux環境、今後のコミュニティ測定
日本市場でのArc Pro B60定価や在庫は資料に記載がない。オーストラリア市場では2026年10月時点でASRock製が1,240豪ドル前後で取引されている。リポジトリはWindows 11を主力プラットフォームとしている。
Linux環境向けビルドスクリプトも公開済みだが、Arc GPU上でのエンドツーエンド動作確認は完了していない。写真では64Kコンテキスト時の24GB VRAM予算内訳が示され、モデル、KV cache、他アプリを割り当てた後の空白領域が確認できる。
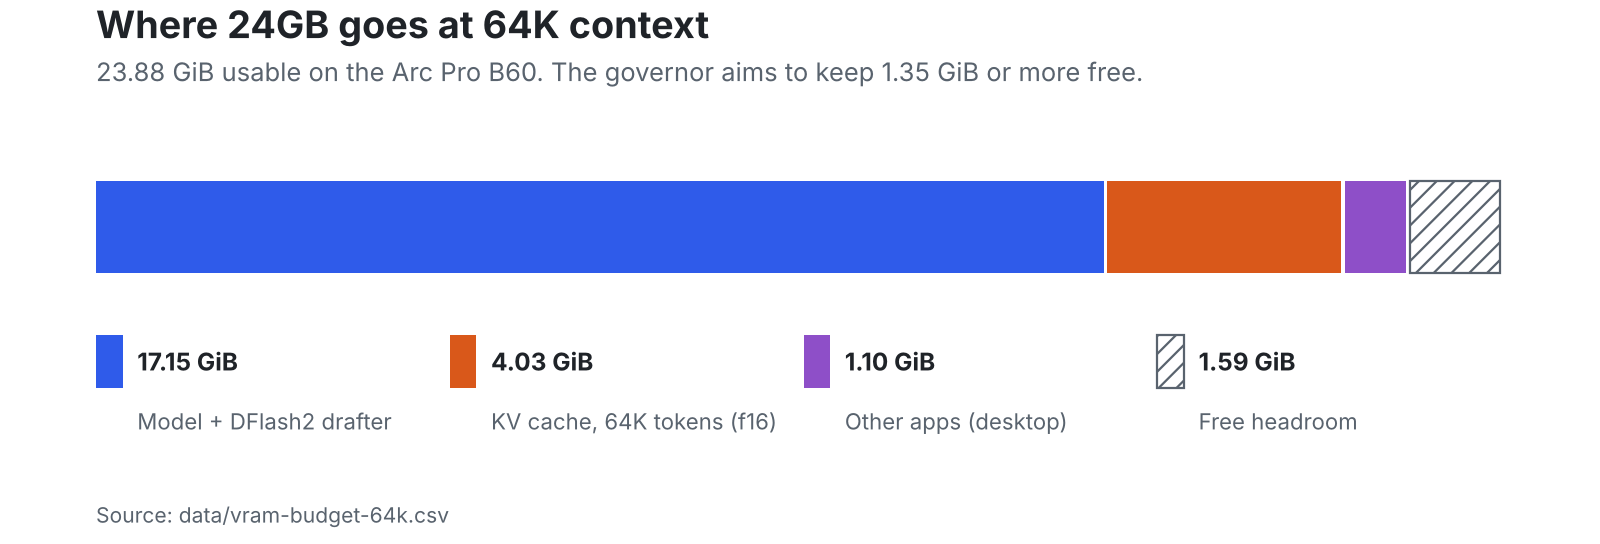
64Kコンテキスト時のVRAM使用量を下の図で確認できる。モデルとドラフトに17.15 GiB、KV cacheに4.03 GiB、他アプリに1.10 GiBを割り当てると残り1.59 GiBが空白領域として残る。auto-fitをオフにした場合の最適な空き容量閾値は確立されていない。
使用されたdriverは32.0.101.8976(2026年9月25日公開)だ。エージェントはclaude-qwenとcodex-qwenのラッパー経由で動作し、コンパクションはClaude CodeまたはCodexが実行する。10月10日公開のリポジトリは、未測定のB70や他GPU向けにコミュニティ測定を呼び掛けている。
用語の注釈
- VRAM
- GPUの専用メモリで、AIモデルの重みや推論データを保持する。容量が大きいほど大きいモデルをローカルで実行できる。(参考:VRAM(GPUメモリ)とは?不足時の症状や使用量の確認方法 ...)