Apple M4 Proで35B MoEコーディングモデルを110 tok/sで動作させるPureDriveランタイム公開
30秒でわかる内容解説
SerOv66がApple M4 Pro上で35B-A3B MoEコーディングモデルを110 tok/sで動作させるPureDriveランタイムをGitHubに公開した。モデル独自のMTPヘッドを用いた推論とカスタムMetalカーネルにより、出力精度を落とさず速度を向上させる。48 GBメモリを搭載したMacで2Kコンテキスト時に実用的な速度を実現し、ローカルAI環境の選択肢を広げる。独立した監査エージェントによる8回の記録更新を経て最適化された。
モデル独自のMTPヘッドで精度を落とさず高速化
PureDriveはoMLXとMLXのランタイムをパッチしたソフトウェアだ。Cyber-Tiel-Coder-35B-A3B-MLX-oQ6e-MTPという6ビット量子化のMoEモデルを動作させる。35B-A3BのアーキテクチャはQwen3.5系を基盤にしており、40層のネットワークを備える。
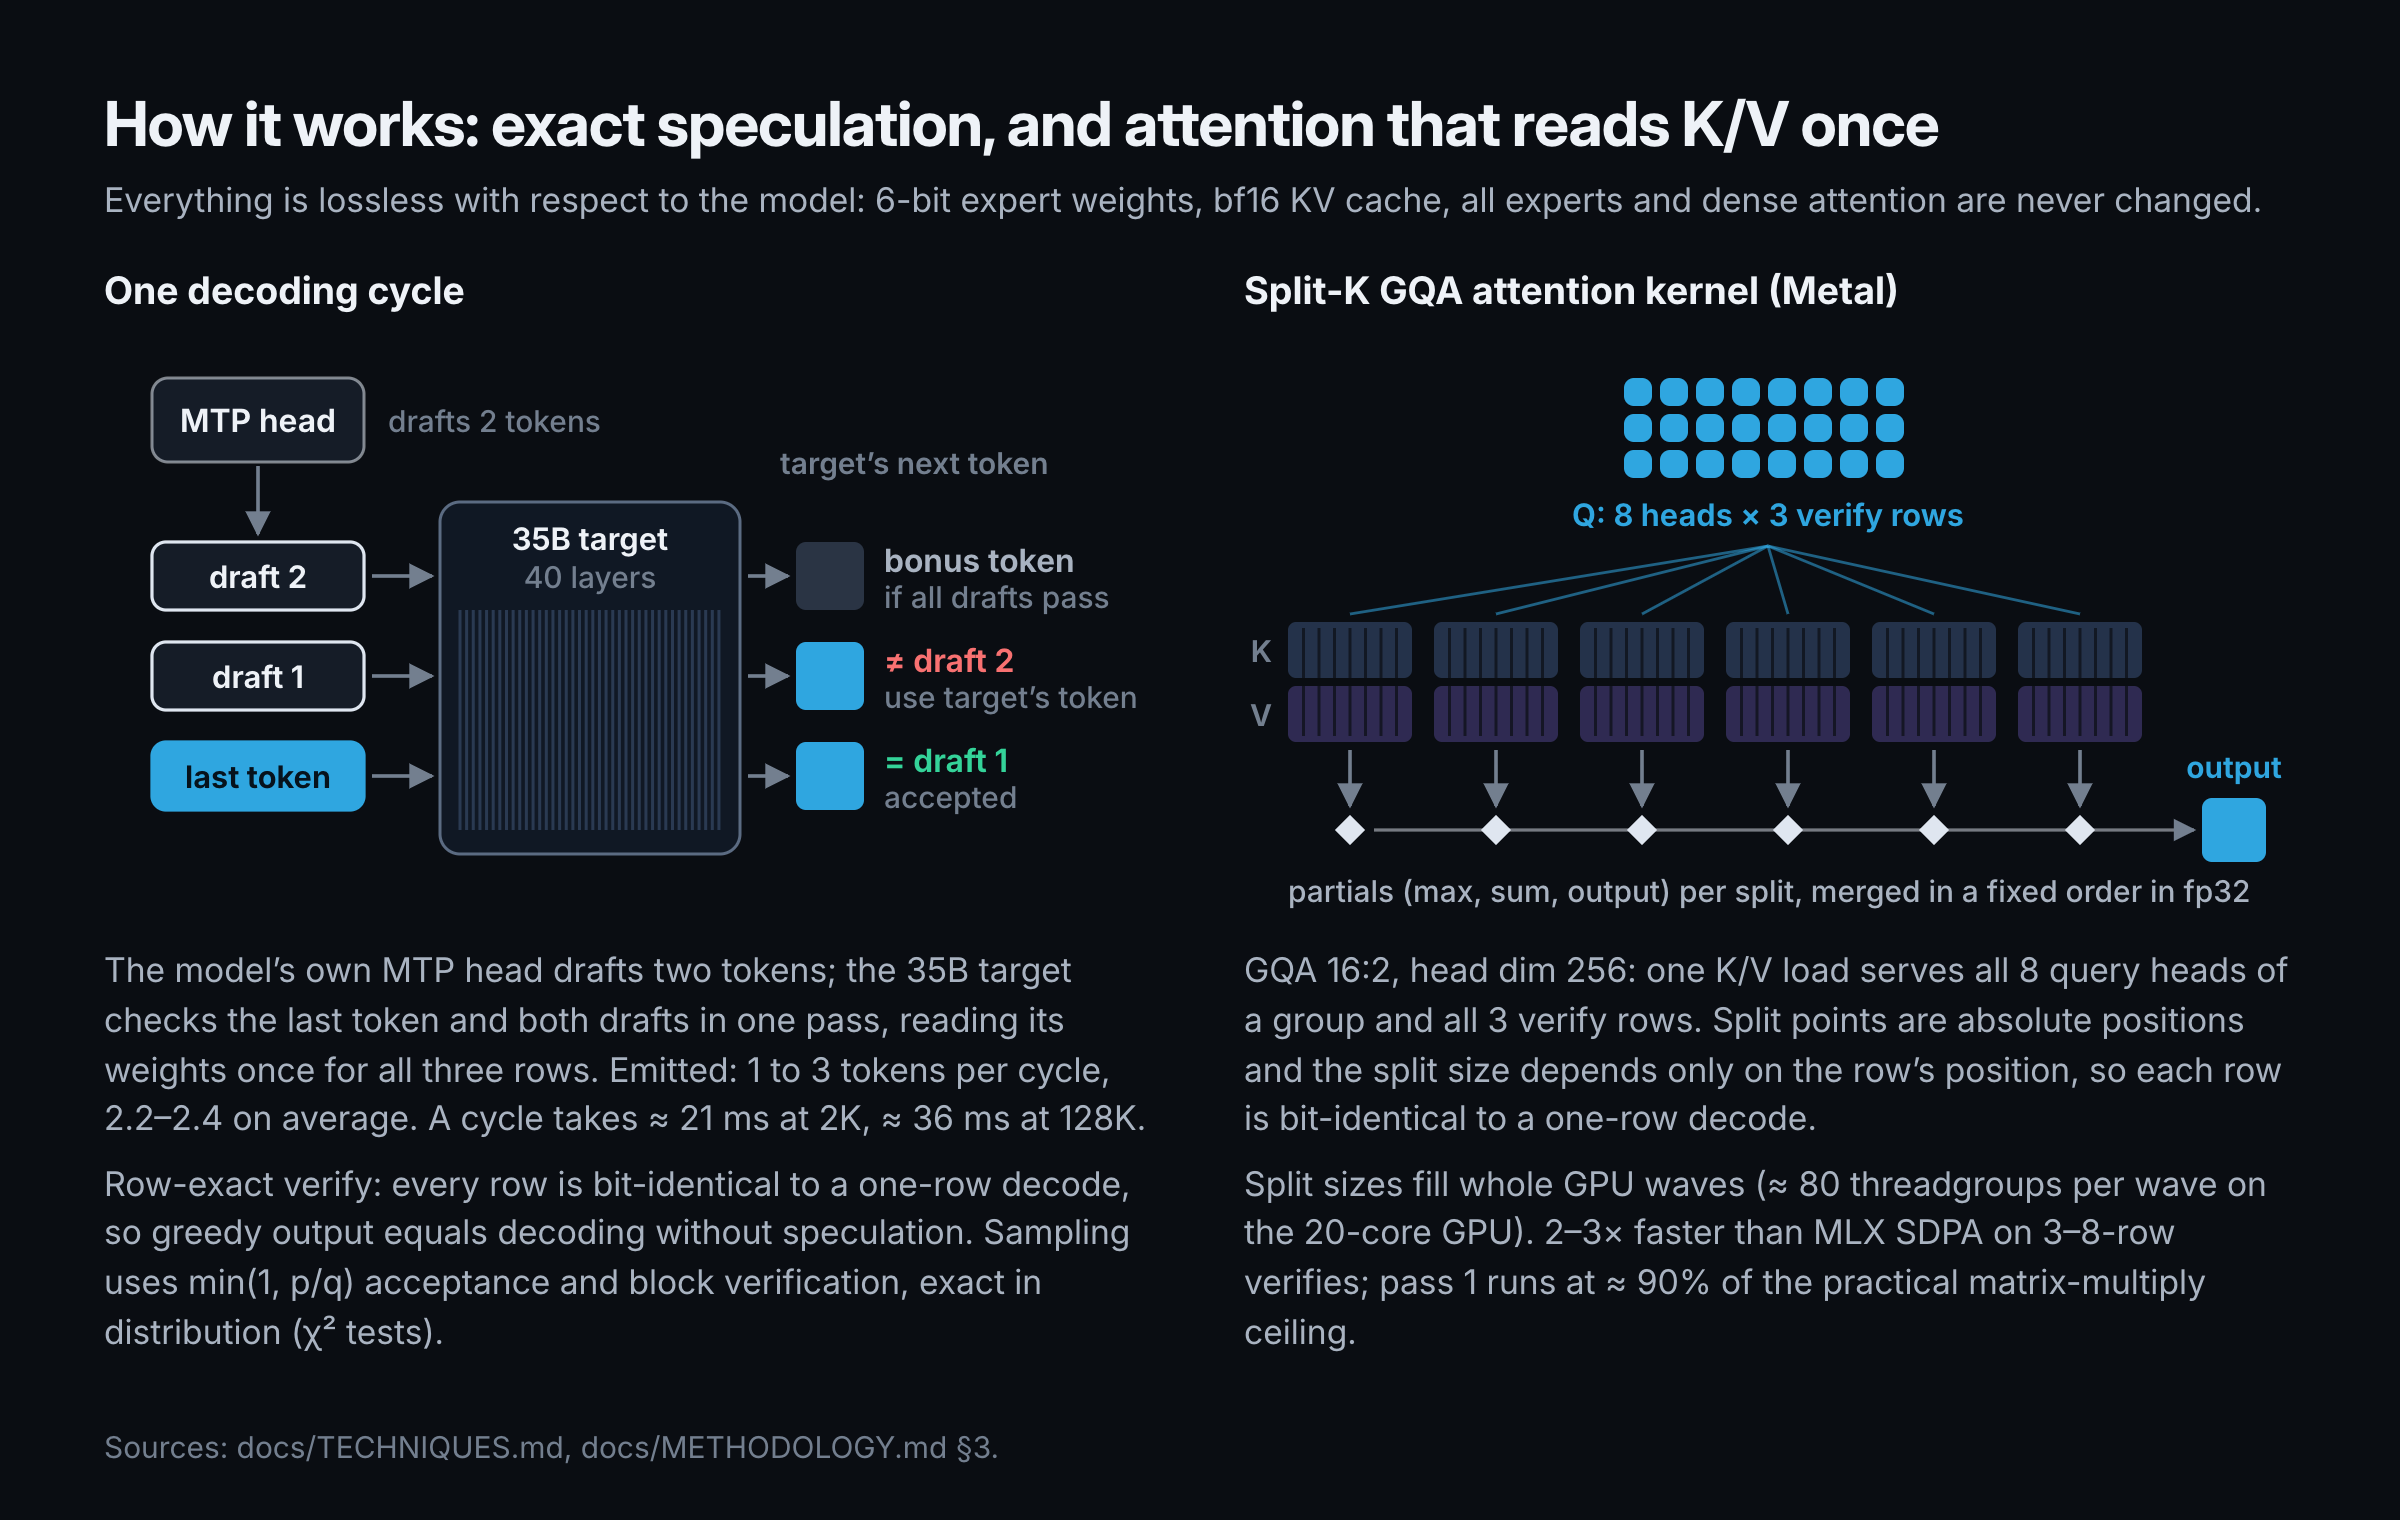
256のエキスパートが動作し、推論時に最大8つが選択される。従来の推論では速度と精度のトレードオフが付き物だった。PureDriveはモデルが持つMTPヘッド(マルチトークン予測ヘッド)を直接使い、推論を高速化する。
MTPヘッドは一度に複数のトークンを生成する機構だ。検証パスを行数ごとに厳密に行うrow-exact verifyにより、非推論時と同じ出力を再現する。速度向上の鍵はカスタムMetalカーネルにある。
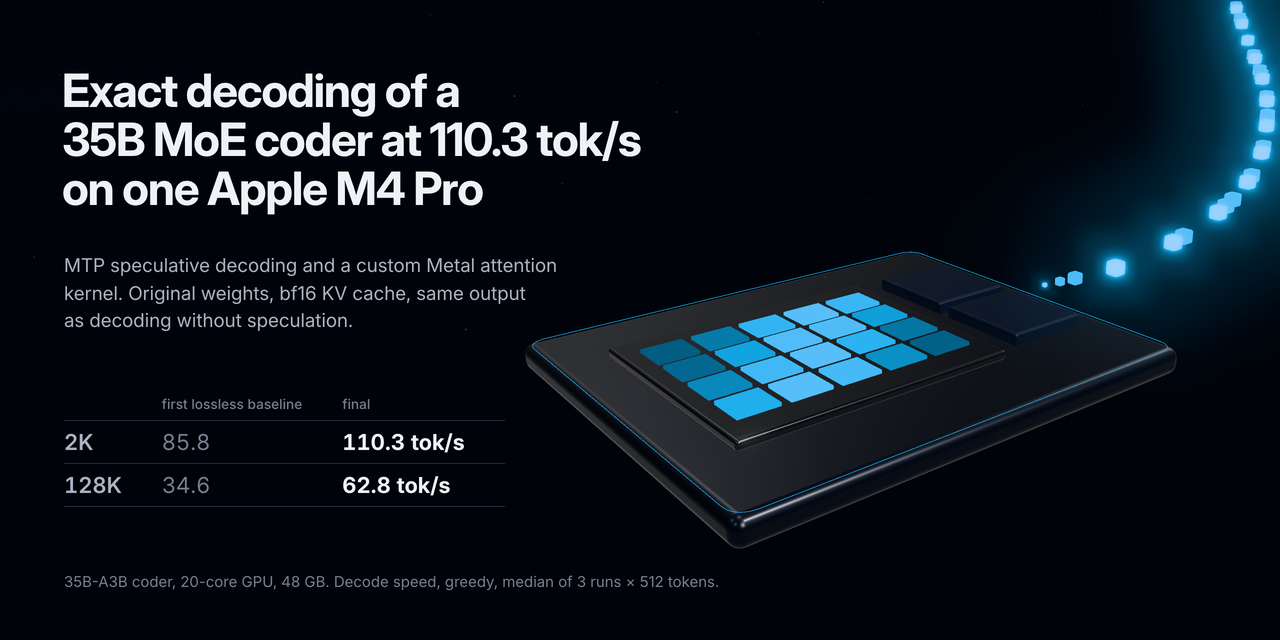
K/Vキャッシュ(直近の文脈情報を保持するメモリ)を1回だけ読み取るsplit-K GQA注意機構(グループ化クエリアテンションの高速化手法)を採用した。これによりGPUの待ち時間が削減される。2Kコンテキストでは110.3 tok/sを記録し、128Kでも62.8 tok/sを維持する。
独立した監査エージェントによる8回の記録更新を経て最適化された。EXP-110の最終記録で2Kコンテキストの110.3 tok/sが確定している。重みは元の精度を維持し、KVキャッシュはbf16形式を使う。
最初のlossless baselineと比較すると、2Kでは85.8 tok/sから110.3 tok/sへ、128Kでは34.6 tok/sから62.8 tok/sへ向上した。写真では35B-A3B MoE coder at 110.3 tok/s on one Apple M4 Pro, exact decoding とある。
MTP draftとrow-exact verifyの仕組み、K/Vキャッシュを1回読み取るsplit-K注意機構の写真では、それぞれの機構が示されている。
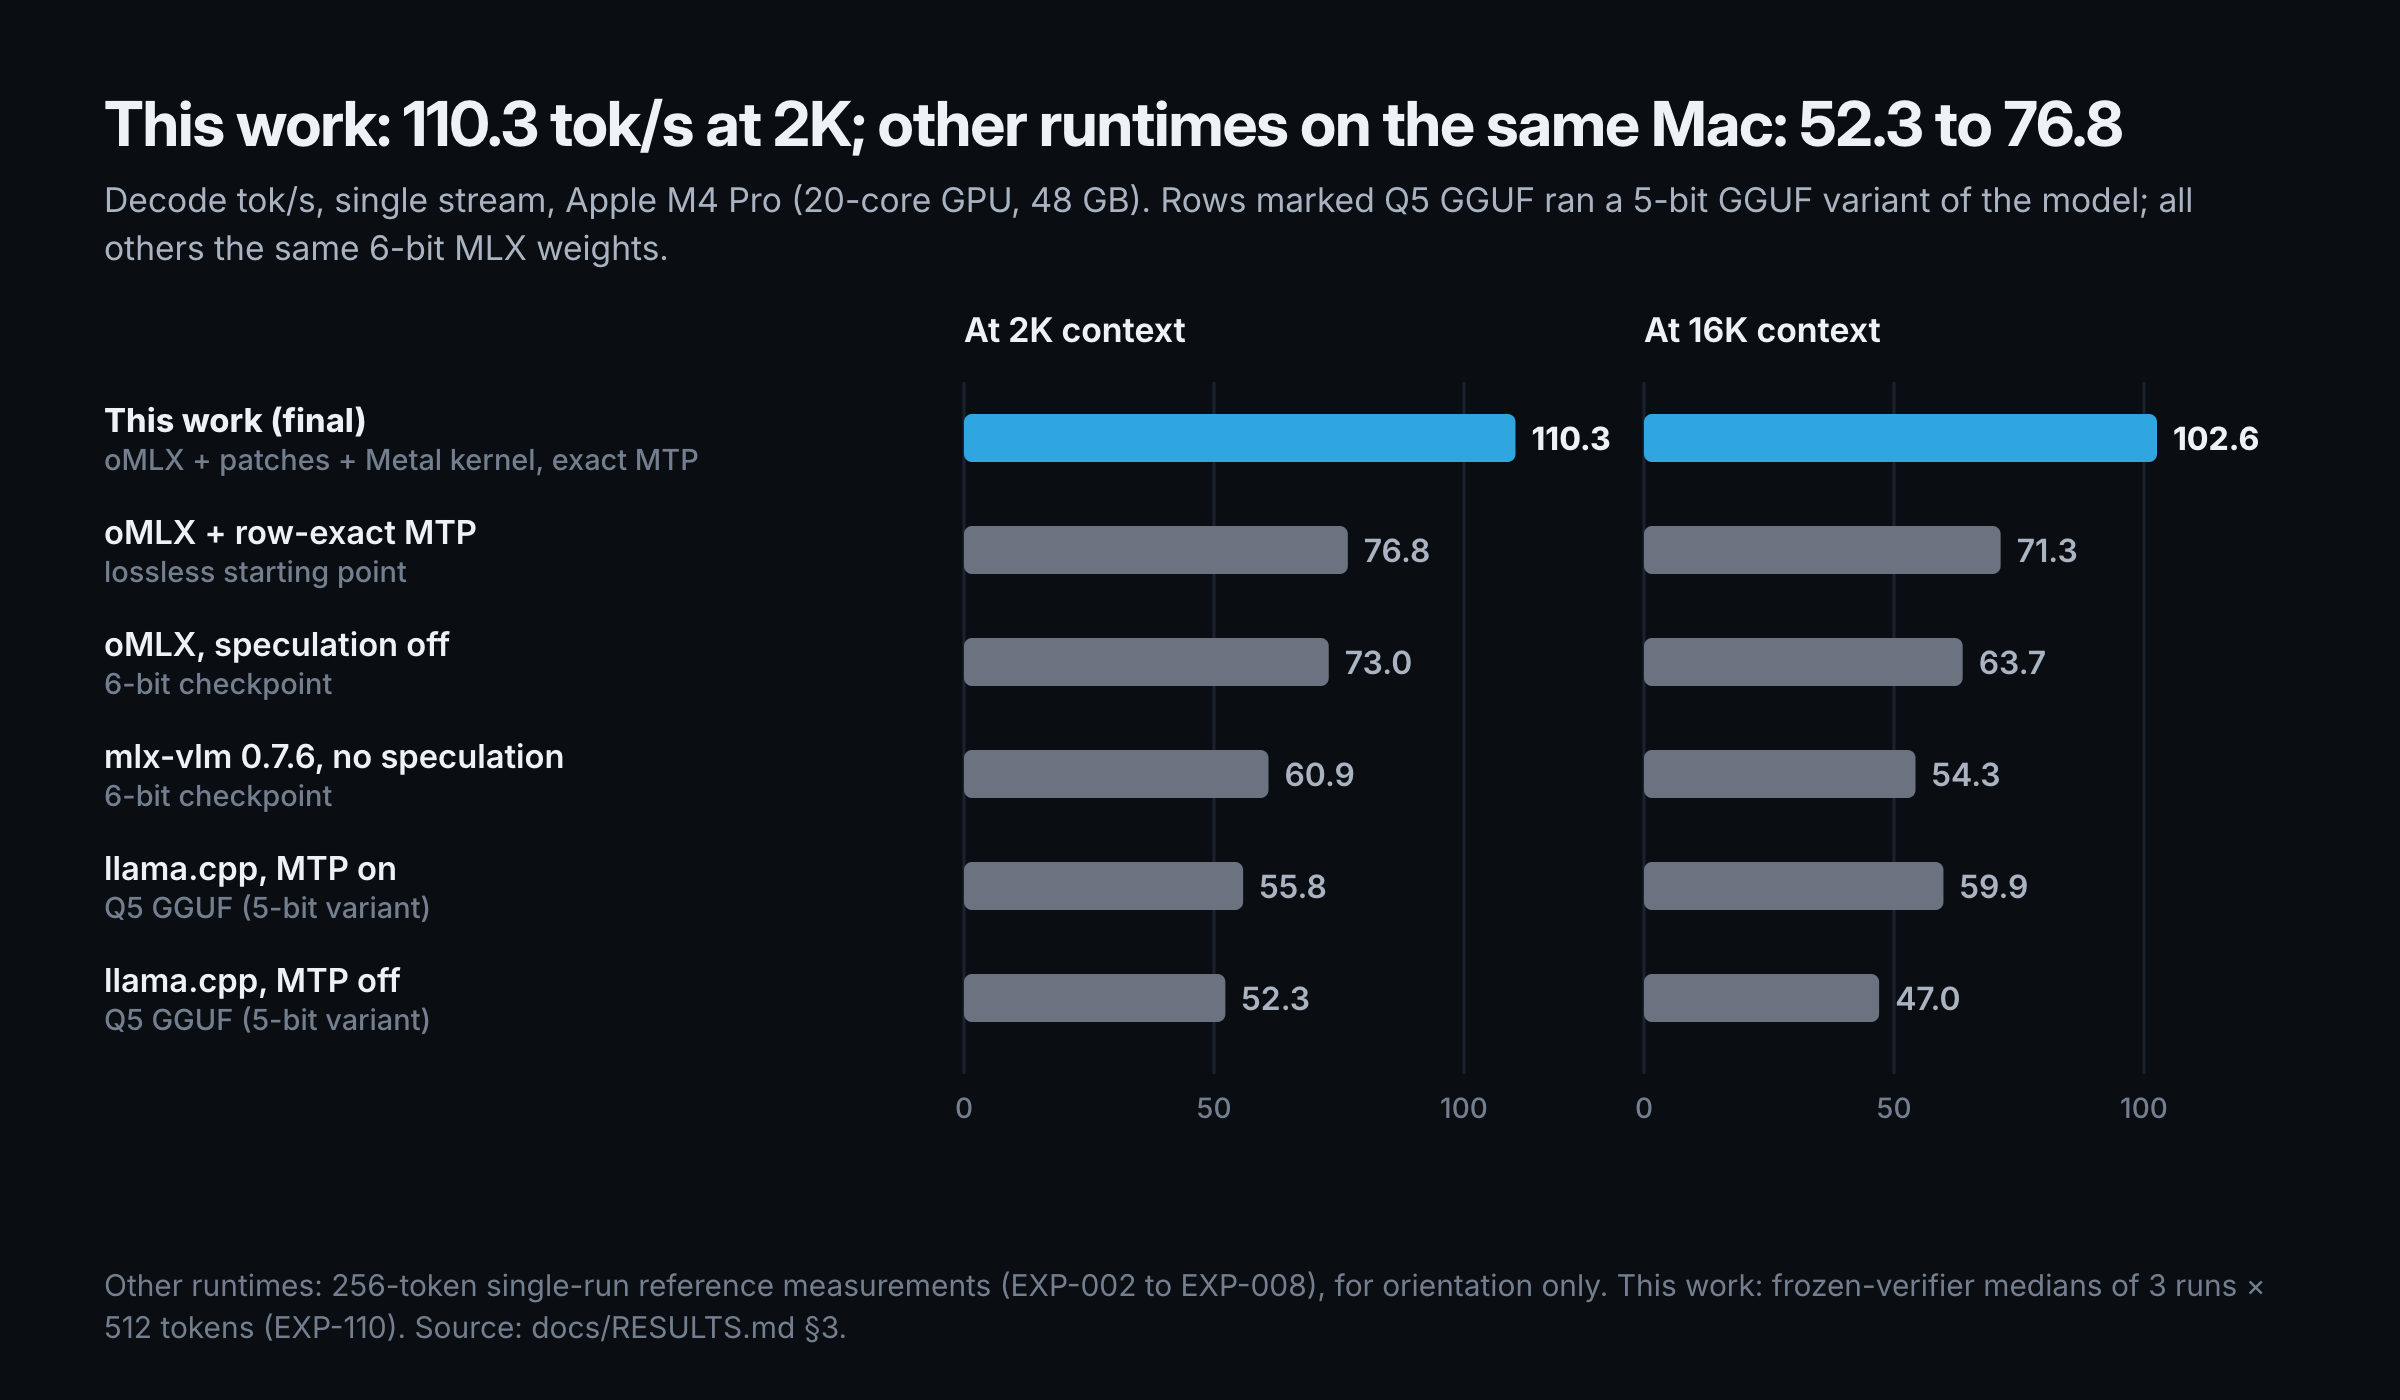
2Kと16Kコンテキストにおける他ランタイムとの速度比較が写真で示されている。
自律型エージェントによる最適化と正確性の証明
開発は自律型AIコーディングエージェントによって進められた。
仕様書に基づき作者エージェントが指示を出し、実行エージェントがコードを書き、監査エージェントが検証を行う。
このプロセスで8回の記録更新が行われた。
速度改善には複数の技術が組み合わされている。
verify pipeliningによりGPUの稼働率を85から97 percentに引き上げた。
pre-queued draftとcompiled draft samplerでホスト側の処理時間を非表示にした。
addとRMSNormを融合するbit-identical fusionsも採用された。
下の構成図はMTP draftとrow-exact verifyの仕組みを表している。
出力の正確性は統計テストで証明されている。
greedy推論では57件のコーディング問題でバイト単位の一致を確認した。
samplingモードではchi-square testでトークン分布が正確であることを確認している。
2026年10月10日に固定されたベンチマークハーネスで測定された。
コンテキスト長7パターンで実コードプロンプトを使い、各3回以上の実行から中央値を報告している。
禁止された最適化が含まれていない点もチェックされた。
独立した検証エージェントがコンテキストをリセットして再実行した。
top-k削減やKVキャッシュの削除などのショートカットは排除された。
| コンテキスト | 推論速度(greedy) |
|---|---|
| 2K | 110.3 tok/s |
| 4K | 107.3 tok/s |
| 16K | 102.6 tok/s |
| 128K | 62.8 tok/s |
Terminal-Bench 2.1で73.3 percentを獲得
ローカル環境での実用性を示すため、Terminal-Bench 2.1のサブセットで評価された。
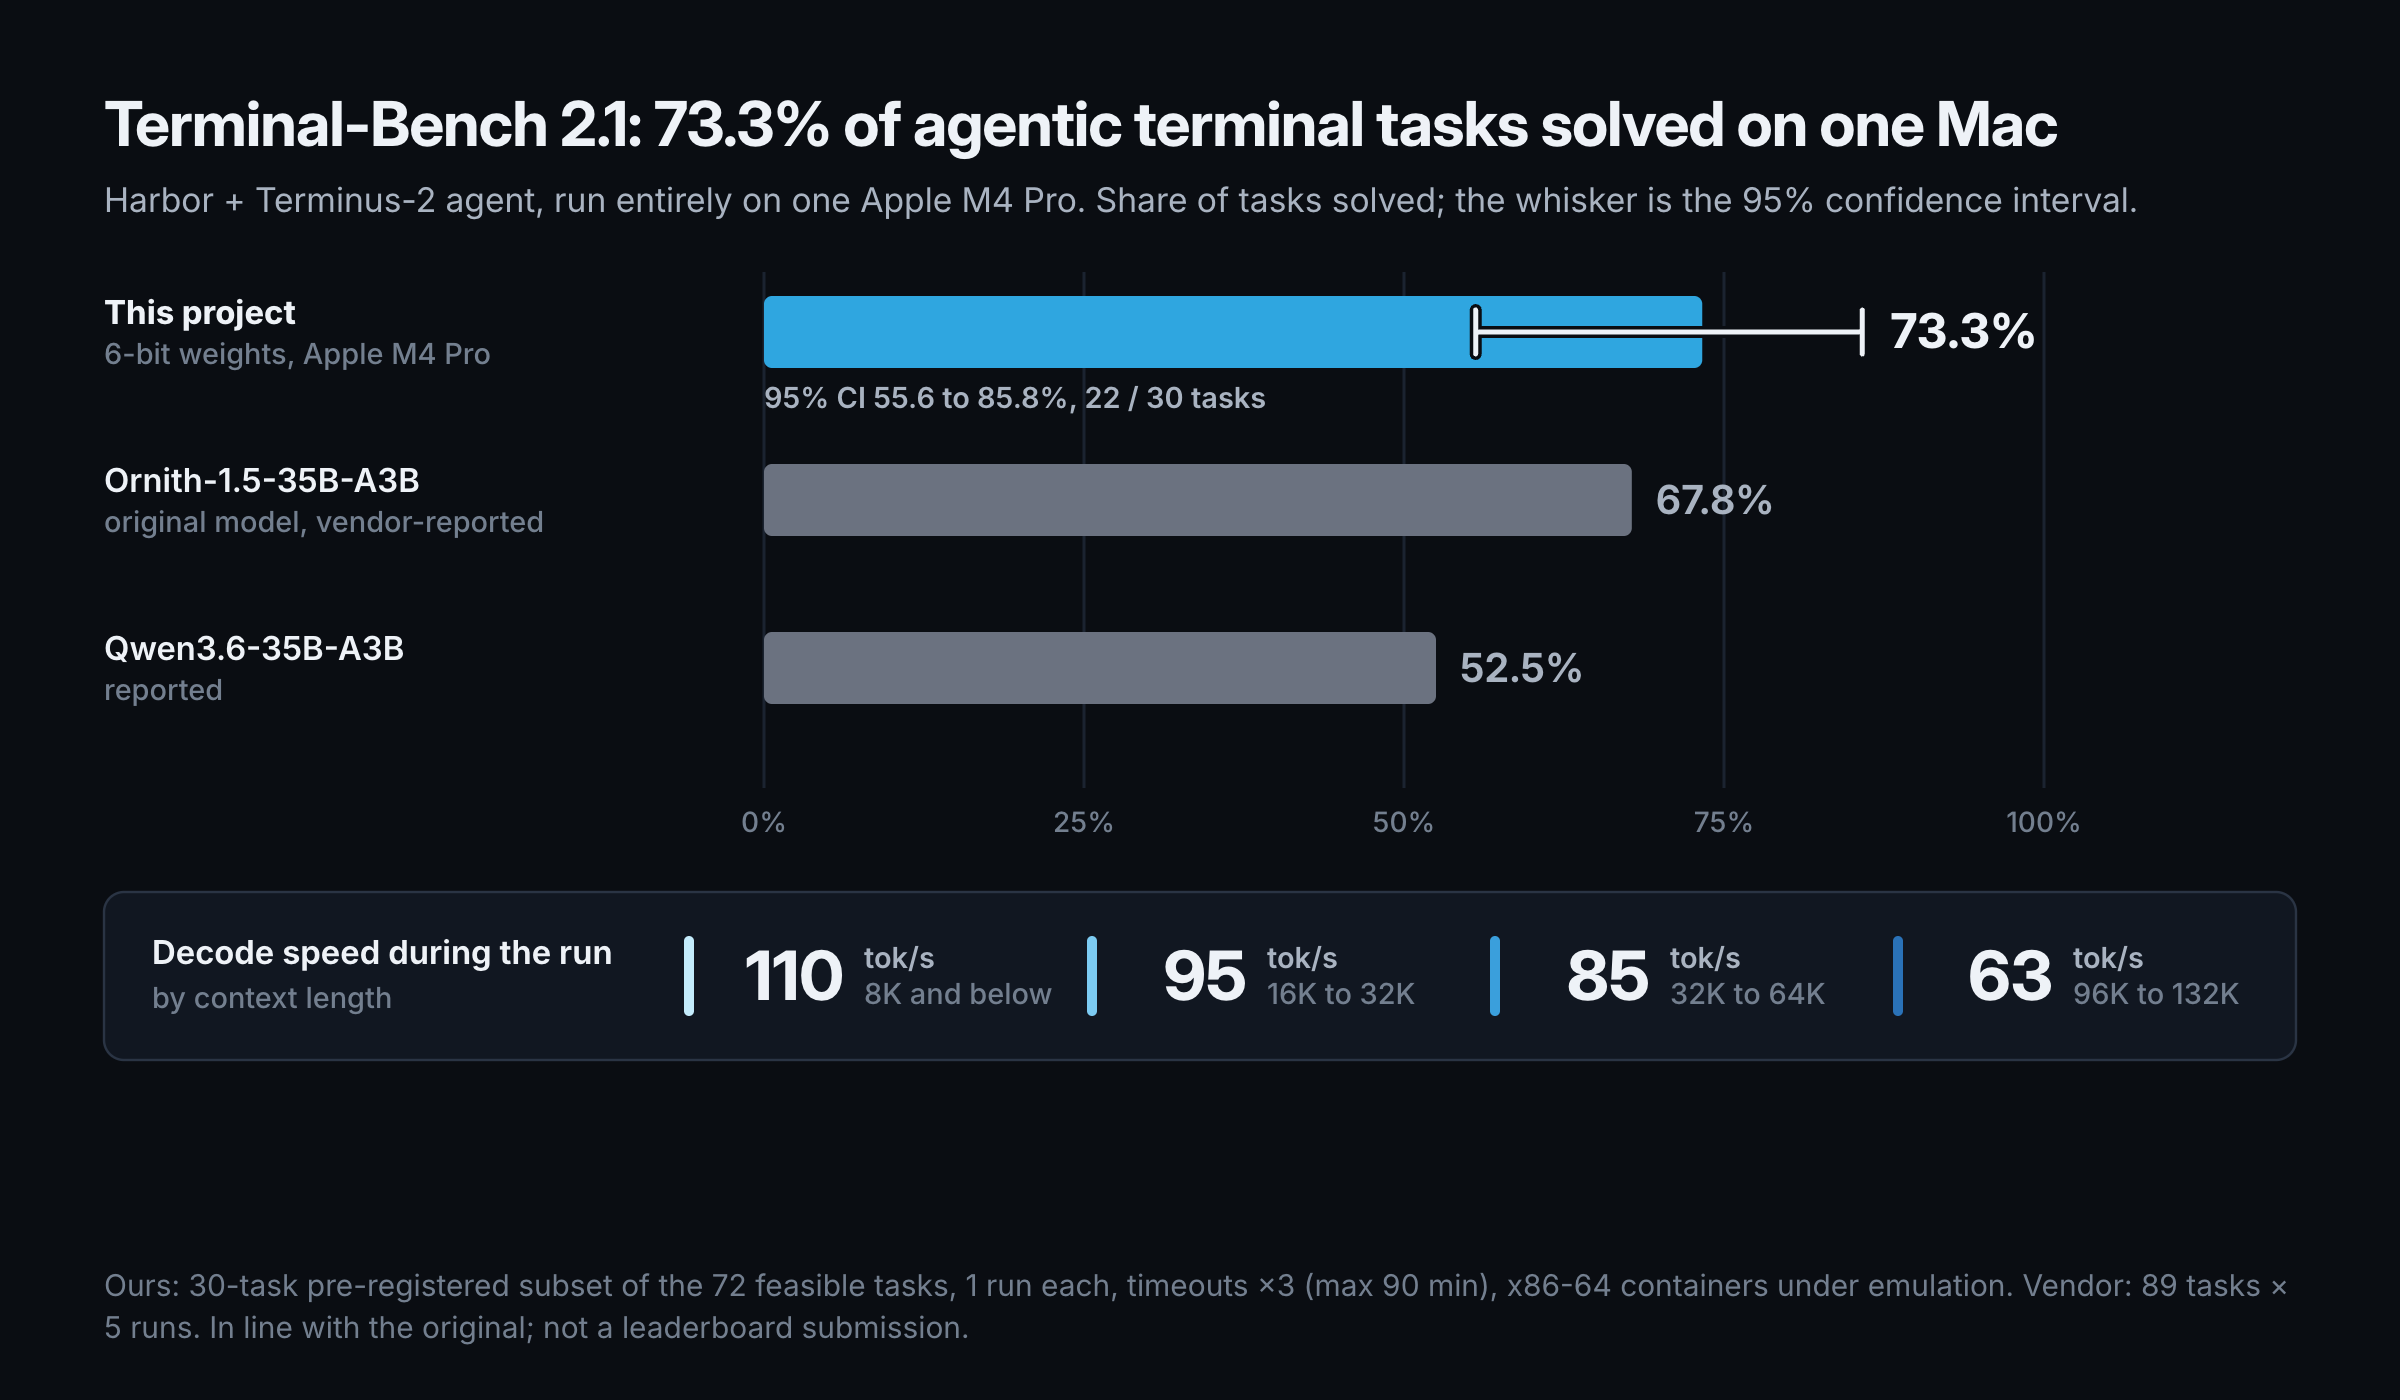
30件の事前登録タスクに対し73.3 percentの成功率を記録した。
これは95 percent信頼区間で55.6から85.8 percentの範囲に収まる。
下のグラフはベンチマークのスコア比較を示している。
元のモデルベンダーが報告した67.8 percentのスコアと同等の水準だ。
コンテキスト8K以下では110 tok/s、96から132Kでは63 tok/sの速度を維持しながら推論を行った。
この手法は特定のモデルに限定されない。
MTPヘッドを搭載したMoEモデル全般に適用可能だ。
Qwen3.6やOrnith-1.5などの同一アーキテクチャモデルはそのまま使用できる。
Qwen3-NextやDeepSeek-V3などの他モデルも、注意カーネルとMTP配線を変数するだけで対応できる。
Macのメモリ容量が48 GB以上あれば動作する。
M1からM5世代のMacが対象だ。
速度はメモリ帯域とGPUコア数に依存する。
2026年10月11日時点では256Kコンテキストの速度は45.9 tok/sと測定されている。
22件のタスクが成功した。
エージェントはツール呼び出しのエラーなく12件全てを完了させた。
DGX SparkとRyzen AI Maxへのポート予定
日本国内の技術者向けには、OpenAI互換のAPIサーバーとして提供される。
ローカルのAIコーディングエージェントにAGENTS.mdを読ませれば自動インストールできる。
2026年10月11日に公開されたGitHubリポジトリからモデル重みとランタイムを取得する。
既存のMacユーザーに加え、NVIDIA DGX SparkやAMD Ryzen AI Max 395などのユニファイドメモリ搭載マシンへのポートも予定されている。
これらはM4 Proと同クラスのメモリ帯域を持つ。
下の画像は他ランタイムとの速度比較を示している。
Apple Silicon向けのカスタムMetalカーネルは現在公開済みだ。
他のプラットフォームではCUDAやROCmへの移植が必要になる。
重みファイルは約28 GBのサイズでHugging Faceからダウンロードする。
macOS 15以降を搭載し、48 GB以上のメモリを搭載したMacで検証が完了している。
DGX SparkやStrix Halo向けのパッチ対応は現在進行中だ。
Piというコマンドラインエージェントで評価された。
平均待ち時間は1.8から3.1倍短縮された。