zai-orgが公開 GLM-5.3-Flash ローカル推論対応のハイブリッドアーキテクチャ
25秒でわかる内容解説
zai-orgが2026年10月12日、GLM-5シリーズ初のネイティブ多モーダルモデルGLM-5.3-Flashを公開した。320億総パラメータのうち18億のみが動くMixture of Experts構造を採用し、推論コストを従来比10分の1に抑えた。SGLangやvLLMなど6つのフレームワークでローカル展開に対応するため、自作PCやワークステーションで高機能AIを動かす日本人開発者にとって実用的な選択肢となる。
320億パラメータのMoEモデルとハイブリッド注意機構
GLM-5.3-FlashはGLM-5.2の主要ベンチマークをすべて上回る性能を発揮する。コーディングやエージェント系のタスクではClaude Opus 4.8に迫る結果を示している。モデルは320億の総パラメータを持つが、1回の推論で実際に計算するのは18億のみだ。これによりメモリ使用量を抑えつつ処理速度を維持している。
長文コンテキストの処理では、スパース注意機構と線形注意機構を組み合わせたハイブリッドアーキテクチャを採用した。これにより従来の線形モデルより精度を保ちながら、推論時の計算コストを削減した。 最新の30兆トークンを含む多モーダル事前学習コーパスで学習を進めた。これにより少ない計算資源でより高度な推論能力を獲得した。
以下のグラフでは、GLM-5.3-Flashが既存モデルを凌駕するスコアを記録しているのが確認できる。
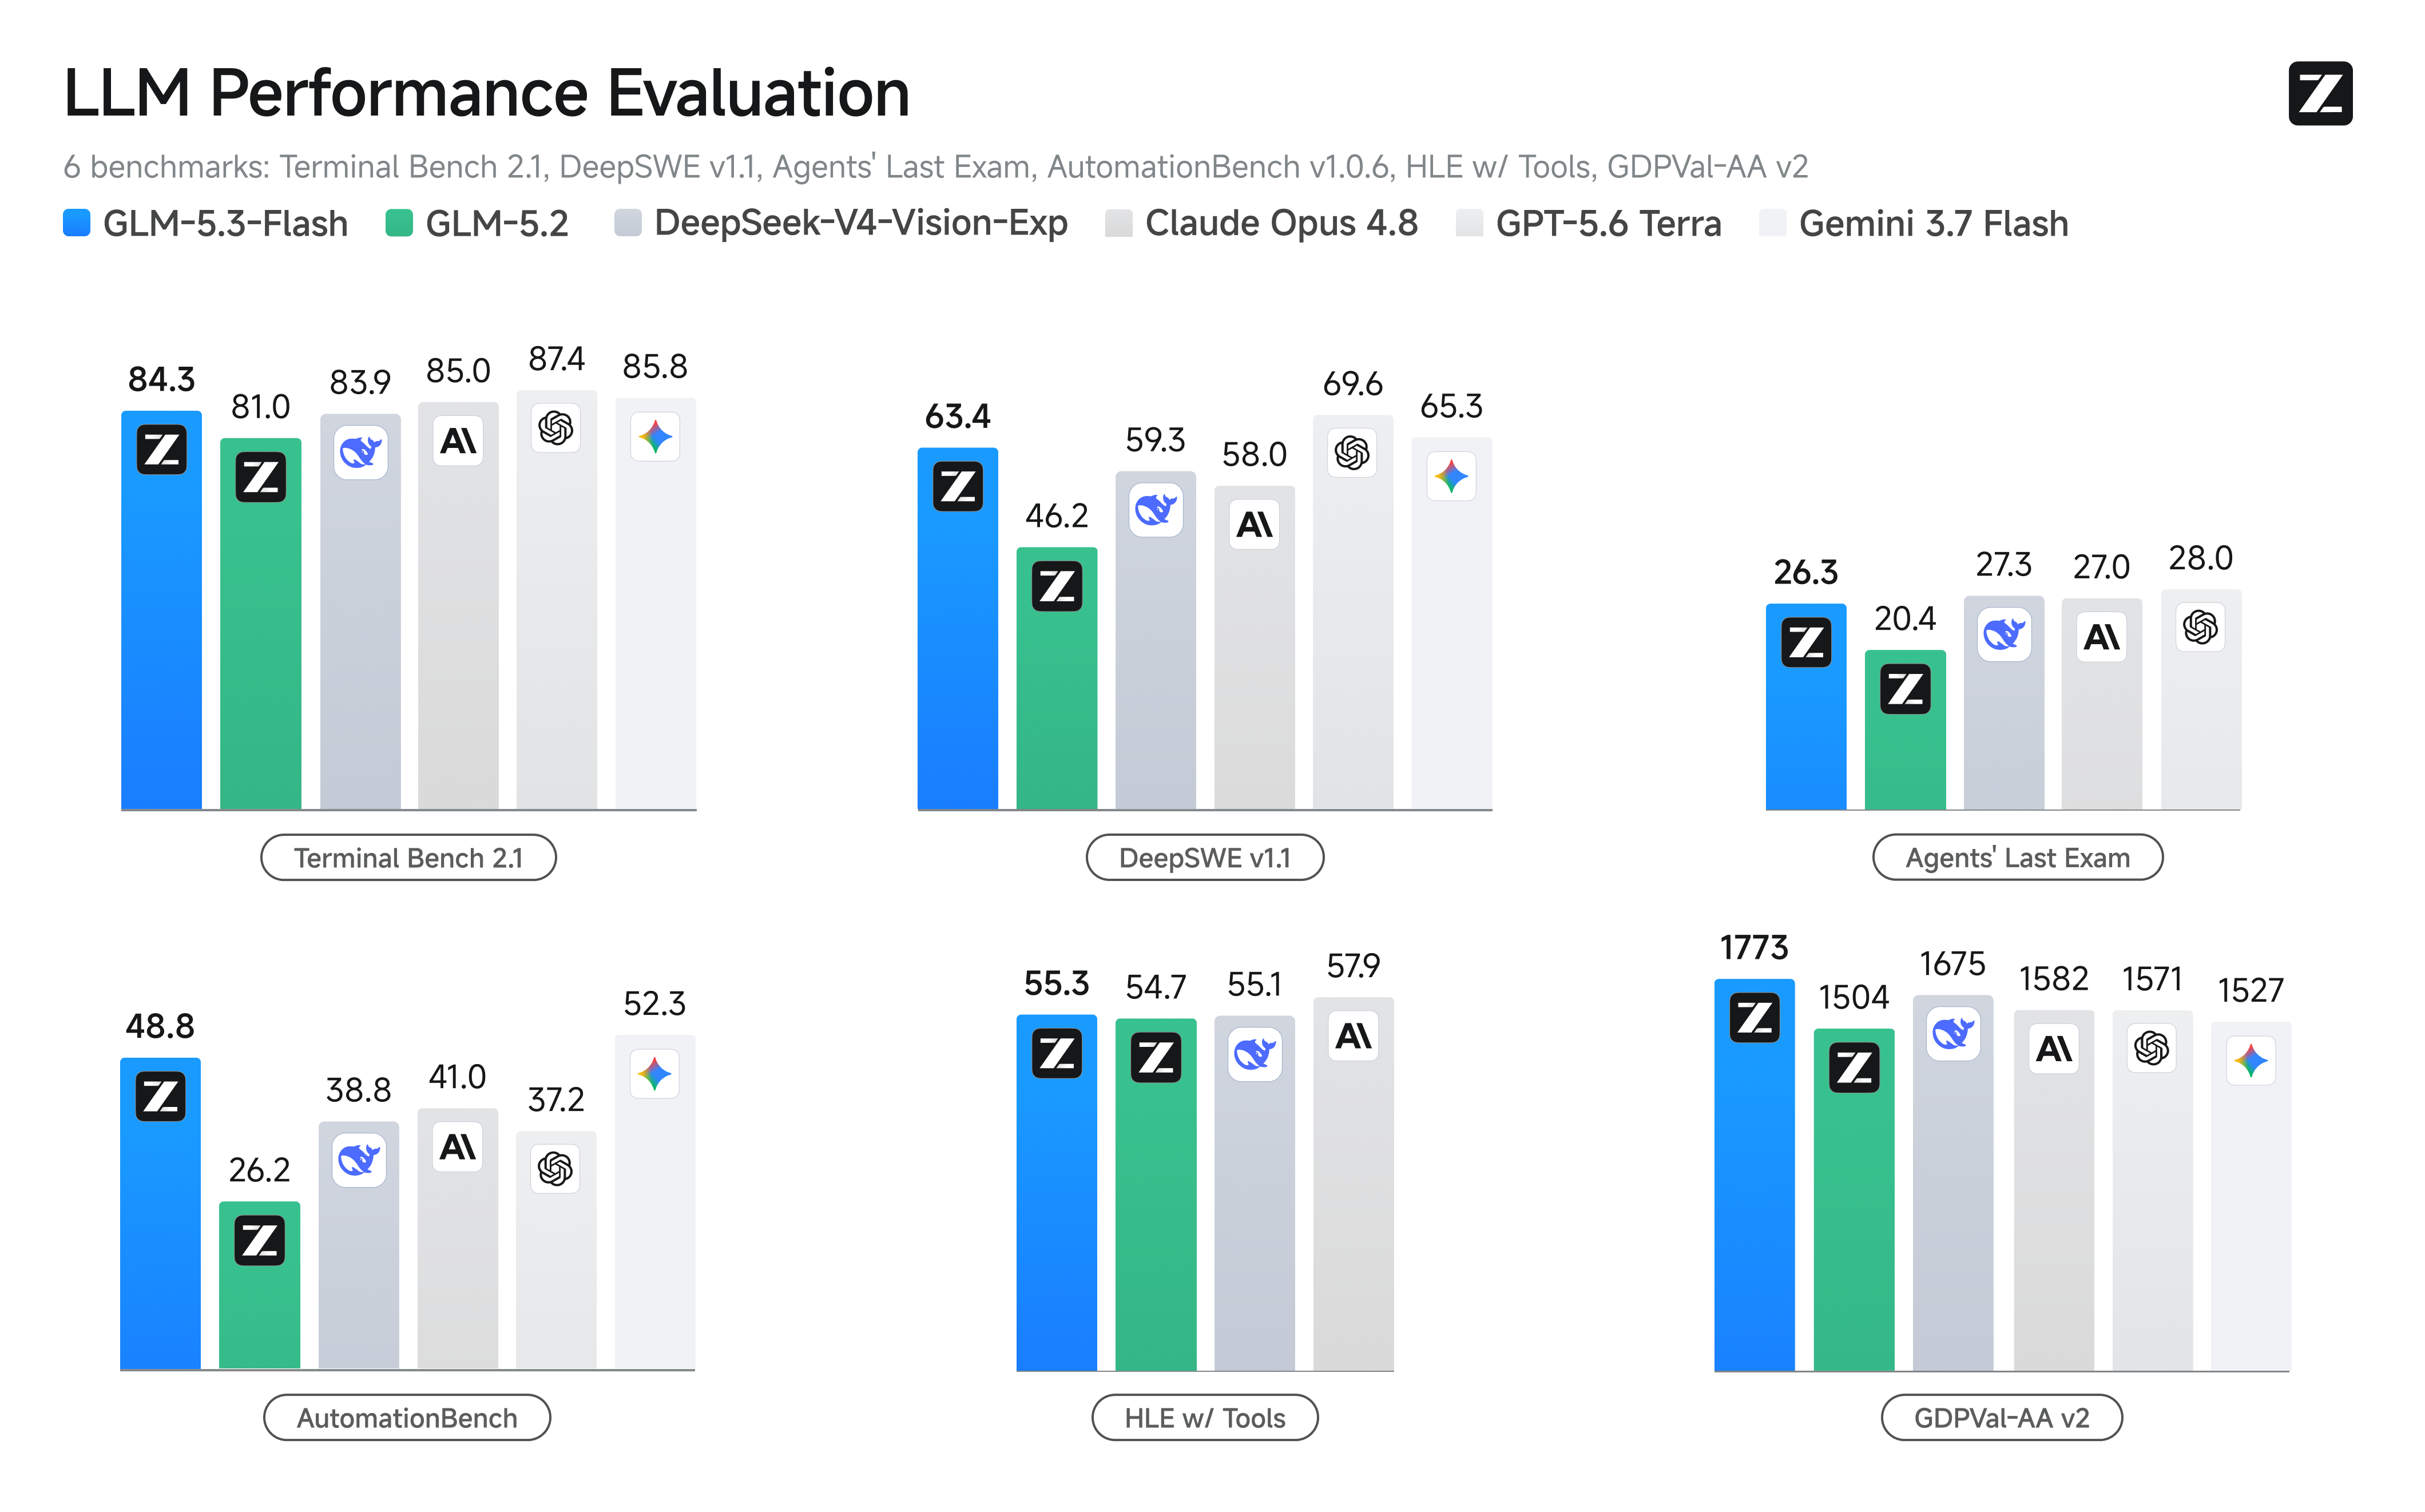
ベンチマーク評価では温度1.0、top_p 0.95の条件で最大16万3840トークンを生成した。評価用のコンテキスト長は30万トークンまで対応可能だ。GPT-5.6-lunaをジャッジモデルとして使用して性能を判定している。
計算効率を重視した再設計とMixture of Experts構造
このモデルは新しいベースモデルから学習を開始し、能力と効率の両立を軸にアーキテクチャと学習レシピを再設計した。パラメータの選択率を最適化するため、Manifold-Constrained Hyper-Connections(パラメータ間の接続を最適化する仕組み)を採用した。これによりモデルの拡張効率をさらに高めている。
画像とテキストを入力として受け取り、テキストを出力するimage-text-to-text形式(視覚情報と文章を混合して処理するパイプライン)に対応している。言語は英語と中国語で動作する。MITライセンスで公開されており、商用利用も可能だ。技術レポートは2026年2月にarXivに公開済みである。
推論フレームワークのサポート範囲も広げている。SGLang、vLLM、TokenSpeed、Transformers、KTransformers、Unslothの6つが公式に対応している。各プロジェクトのレシピやチュートリアルが公開されているため、好みの環境に組み込みやすい。ローカル環境で動作させる際、メモリ割り当てやカーネル最適化の設定が重要になる。
ローカル環境での検証とパラメータ制御仕様
Hugging Faceのtrendingページに掲載された直後から、ローカル環境での検証が進んでいる。6つの推論フレームワークに対応しているため、自作PCやワークステーションで手軽に試せる。SGLangのcookbookやvLLMのrecipesを参照すれば、初期設定から推論実行までスムーズに進められる。
推論時の思考予算を制御するreasoning_effortパラメータ(推論の思考予算を制御する設定)が用意されている。low、high、maxの3段階から選択でき、未指定時はmaxが適用される。チャット利用時はclear_thinkingパラメータをtrueに明示設定する仕様だ。ベンチマーク再現時はmaxを維持する必要がある。
実環境での推論コストとベンチマーク結果の一致度はまだ未詳だ。メモリ構成やGPUの組み合わせによって、実際の推論速度に差が生じる可能性がある。技術レポートの著者リストには多数の開発者が名を連ねており、コミュニティからのフィードバックがモデル改良に反映される見込みだ。
実環境でのコスト検証とローカル展開の見通し
公開日は2026年10月12日であり、本日現在では主要なローカル推論フレームワークへの対応が完了している。長文コンテキスト対応にスパースと線形注意機構を組み合わせるハイブリッドアーキテクチャが、ローカル環境でどの程度メモリ節約に寄与するかが今後の焦点となる。
画像解像度の調整やトークン数の上限設定によって、推論速度が変動する可能性がある。技術レポートのarXiv公開日は2026年2月であり、その後の改良履歴も追跡できる。ローカルAI愛好家は各フレームワークの更新履歴を確認しながら、最適な推論設定を探ることになる。
実環境での推論コストとベンチマーク結果の一致度はまだ未詳だ。メモリ構成やGPUの組み合わせによって、実際の推論速度に差が生じる可能性がある。技術レポートの著者リストには多数の開発者が名を連ねており、コミュニティからのフィードバックがモデル改良に反映される見込みだ。
出典
- zai-org/GLM-5.3-Flash (image-text-to-text)(Hugging Face trending) · 議論