H100上でのLLM推論パフォーマンスを七つの実験で解析した
30秒でわかる内容解説
richajoyが公開したGitHubリポジトリは、NVIDIA DynamoとvLLMを用いたH100 GPU上のLLM推論性能を七つのハンズオン実験で分析したものである。モデルの重み読み取りや演算に必要なバイト数とFLOPsから物理法則を導き、バッチサイズやKVキャッシュの配置を変えた時の遅延とスループットを測定している。ローカル環境で大規模言語モデルを動かす技術者にとって、帯域幅と演算容量のどちらがボトルネックになるかを知る手がかりになる。
帯域幅と演算容量の物理モデルでボトルネックを特定
2026年10月18日に公開されたプロジェクトは、Qwen3-8BモデルをH100 SXM 80GB上でサービングする環境を構築した。基盤としてKubernetes 1.34、NVIDIA Dynamo 1.5.1、vLLM 0.28.0を組み合わせた。七つの実験で負荷・ルーティング・分散・自動スケーリング・エンジン設定を一つずつ変え、初トークンまでの時間やトークン生成時間、スループットを計測した。
推論の物理法則が測定値を正確に予測する点が特徴だ。 バッチ化により重み読み取りを共有できるため、ユーザーを一人から六十四人に増やすとスループットは最大四十三倍向上する。一方で各ストリームの速度は三十一%低下する。
One constant (about two thirds, 66.5%, of the H100's peak bandwidth) predicts every measured decode step within 3%.
定数一つ(H100のピーク帯域幅の約三分の二、六十六・五%)が、三%以内の誤差で測定されたデコードステップをすべて予測する。
下図はQwen3-8BのRooflineを示している。
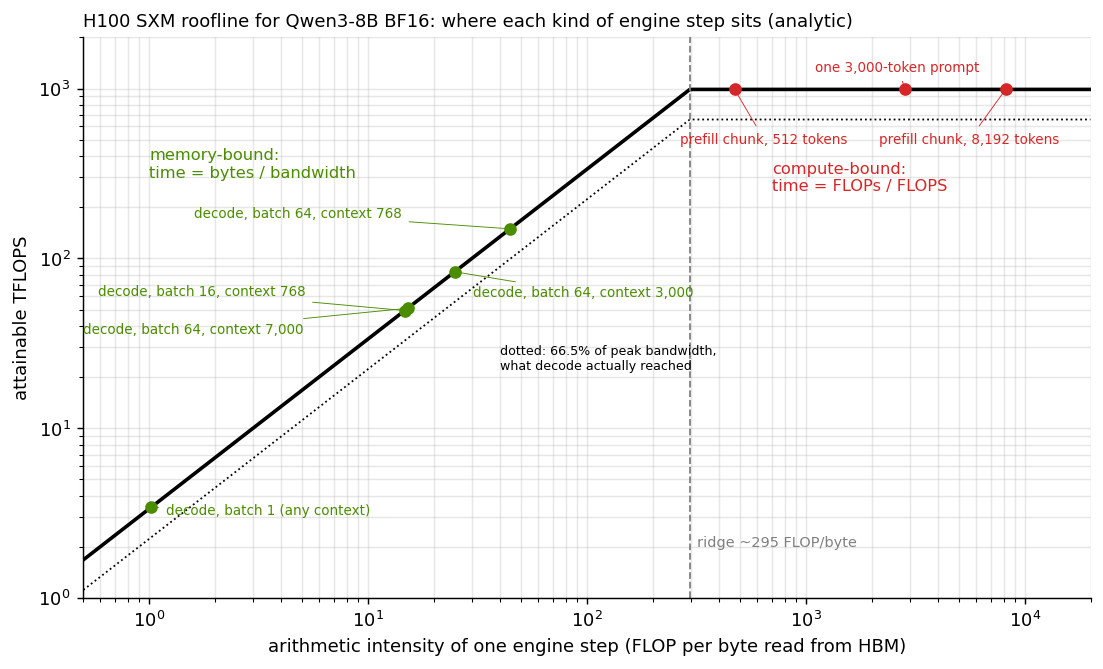
画像ではデコード処理がメモリ帯域幅に制限される傾斜線上に位置し、プリフィルが演算性能の平坦部に収まっている。この構造から、バッチ数を増やせばスループットは伸びるが、個々の応答速度は遅くなるトレードオフが明確になる。
長いプロンプトを含むリクエストが混在すると、他のストリームを阻害する。六十四件のリクエストでトークン間隔を測ると、大部分は十七ミリ秒だが、十分の一が約二百ミリ秒に延びた。
分散構成とFP8形式がもたらす性能の変化
構成要素はフロントエンドのDynamoルーターとバックエンドのvLLMエンジンに分かれる。KVキャッシュ(直前までの会話履歴を格納するキャッシュ)をGPU間で転送するにはNIXLとUCX(ハイパフォーマンスなネットワーク通信ライブラリ)を使う。
Disaggregation on a standard Kubernetes pod spec silently moves the KV cache over TCP, 370x slower than NVLink, and serves 18x less traffic.
標準のKubernetesポッド設定での分散は、KVキャッシュをNVLinkより三百七十倍遅いTCP経由で移動させ、非分散時と比べて十八分の一のトラフィックしか処理しない。
NVLink(GPU同士を高速に接続するインターフェース)環境では分散がトークン生成時間を半分にする。自動スケーリングはポッドの削除と冷間起動を繰り返すため、二から三分かかる。KV転送が遅いとプランナーは容量を誤った方向へ移動させる。
精度と帯域幅のバランスを取るFP8形式(演算精度を落とした軽量化形式)の効果も測定された。FP8重みを使えばトークン生成時間は約二十九%短縮される。FP8のKVキャッシュは長文コンテキストのスループットを三十七%向上させる。KVベースのルーティングは初期設定で接頭辞ヒット率が零点六九だったが、フラグ一つで零点九〇に改善した。
各パラメータが影響する指標は明確に区別できる。 表では主要な設定ノブが初トークン時間、トークン生成時間、スループットに与える影響をまとめている。FP8重みは帯域幅制約のデコードに有効で、FP8 KVキャッシュは長文の並列リクエストに適している。
| 設定ノブ | 改善される指標 |
|---|---|
| バッチ数増加 | スループット |
| chunk budget縮小 | 応答速度 |
| FP8重み | トークン生成時間 |
| FP8 KVキャッシュ | 長文スループット |
生データ公開による透明性と計測器の見落とし
公開直後は公式SNSや技術フォーラムで測定手法の透明性が評価された。生データと自動生成スクリプトを公開し、チャートや表を誰でも再生できる仕組みだ。作者自身も七つの実験中に計測器の誤差や負荷生成器の仕様見落としを四十七件中六十四件のリクエストで発見した。その修正点は文書の末尾に列挙されている。
実験の限界も明示されている。FP8精度の評価は実施されておらず、分散テストはプリフィルとデコードの一対一構成のみだ。RDMA(ネットワークを介さずにGPUメモリを直接読み書きする技術)やマルチノード転送は未テストで、飽和後のバースト挙動や実トラフィックにおけるプレフィックス再利用率、推論受け入れ率は測定されていない。
単一ノードの環境で閉ループ負荷をかけたため、開ループの到着パターンや実際のユーザー行動との乖離が想定される。しかし一貫した物理モデルに基づく七回の検証は、ローカル推論のボトルネックを特定する堅牢な基準を提供している。
マルチノード転送と開ループ負荷の次期検証計画
リポジトリには今後の測定予定が記載されている。飽和後のバースト挙動や実トラフィックにおけるプレフィックス再利用率、speculative decodingの受容率を計測する。マルチノード環境でのNVLinkやRDMA転送テストも計画されている。
現在公開されている七つの実験は、単一GPUでの動作を基盤にしている。今後は二台以上のH100を用いた分散構成や、異なるモデルサイズでの検証が追加される見込みだ。データとスクリプトはApache License 2.0で公開され、任意のLinuxノードで再現できる。
計画されている次のステップでは、閉ループ負荷に加え開ループ到着テストを実施する。実文テキストでの推論受け入れ率を測定し、バースト時の挙動を把握する。二〇二六年十月以降、リポジトリのドキュメントとベンチマークデータが順次追加される。