llama.cpp v0.7.0ベースの高速8ビット推論ビルド「VelociQ8」が公開
25秒でわかる内容解説
開発者dhaernが、CPU向けに高速化された8ビット重みフォーマットQ8A64を搭載した推論ビルド「VelociQ8」を公開した。llama.cpp v0.7.0をベースに作られており、既存のクライアントやAPIをそのまま使える。Arm環境ではメモリ使用量が約半分になり、プロンプト処理速度は最大約2倍向上する。ローカルPCやサーバーでLLMや埋め込みモデルを動かす技術者にとって、コストと速度の両立を狙える選択肢が増えた。
独自8ビットフォーマットと互換性を維持
VelociQ8は、llama.cpp v0.7.0をフォークした独自ビルドである。主な特徴は、Q8A64と呼ばれる8ビット重みフォーマット(8ビットで重みを圧縮する形式)と、Armおよびx86-64向けに最適化されたCPUカーネルの追加だ。
Arm向けにはdotprod命令(ベクトル内積演算命令)を、x86-64向けにはAVX2とFMA命令(並列演算命令)を利用する。ツール類はllama-serverやllama-cliなどをそのまま使い、OpenAI互換HTTP APIも維持される。既存のクライアントは設定を変更せずに接続できる。
llama-embeddingやllama-benchなどの標準ツールも同一のオプションで動作する。llama-serverのOpenAI互換エンドポイントもそのまま利用できる。モデル読み込み時は、BF16やF16、F32のGGUFファイル(llama.cppで標準的に使用されるモデル重みデータファイル)を指定するだけで、起動中にQ8A64形式に変換される。
v1.1以降はllama-quantizeコマンドで独自に変換したファイルも保存可能になった。EmbeddingモデルやDense LLM(単一構造の言語モデル)に加え、MoE(複数のサブモデルから選択して処理する仕組み)モデルもサポートする。Hybridアーキテクチャのgranite-4.0-hやLFM2.5でも動作を確認している。
linuxとwindowsのバイナリに加え、Dockerイメージも提供される。Linux版はglibc 2.28以上が必要で、Windows版はDLL依存のない静的リンクとなっている。
Arm環境で高速化とメモリ削減が確認
性能測定の結果、Arm環境での恩恵が特に大きい。Oracle Cloud A1上のEmbeddingGemma 300Mでは、処理時間が634ミリ秒から339ミリ秒に短縮された。
AMD Ryzen 9 5950Xでも1209ミリ秒から909ミリ秒へと25パーセントの節約になった。LLMのプロンプト処理では、Llama-3.2-1BにおいてArm環境で1.56倍、x86環境で1.82倍の速度向上を確認している。写真ではArm環境におけるEmbeddingGemma 300Mのベンチマーク結果が示されている。
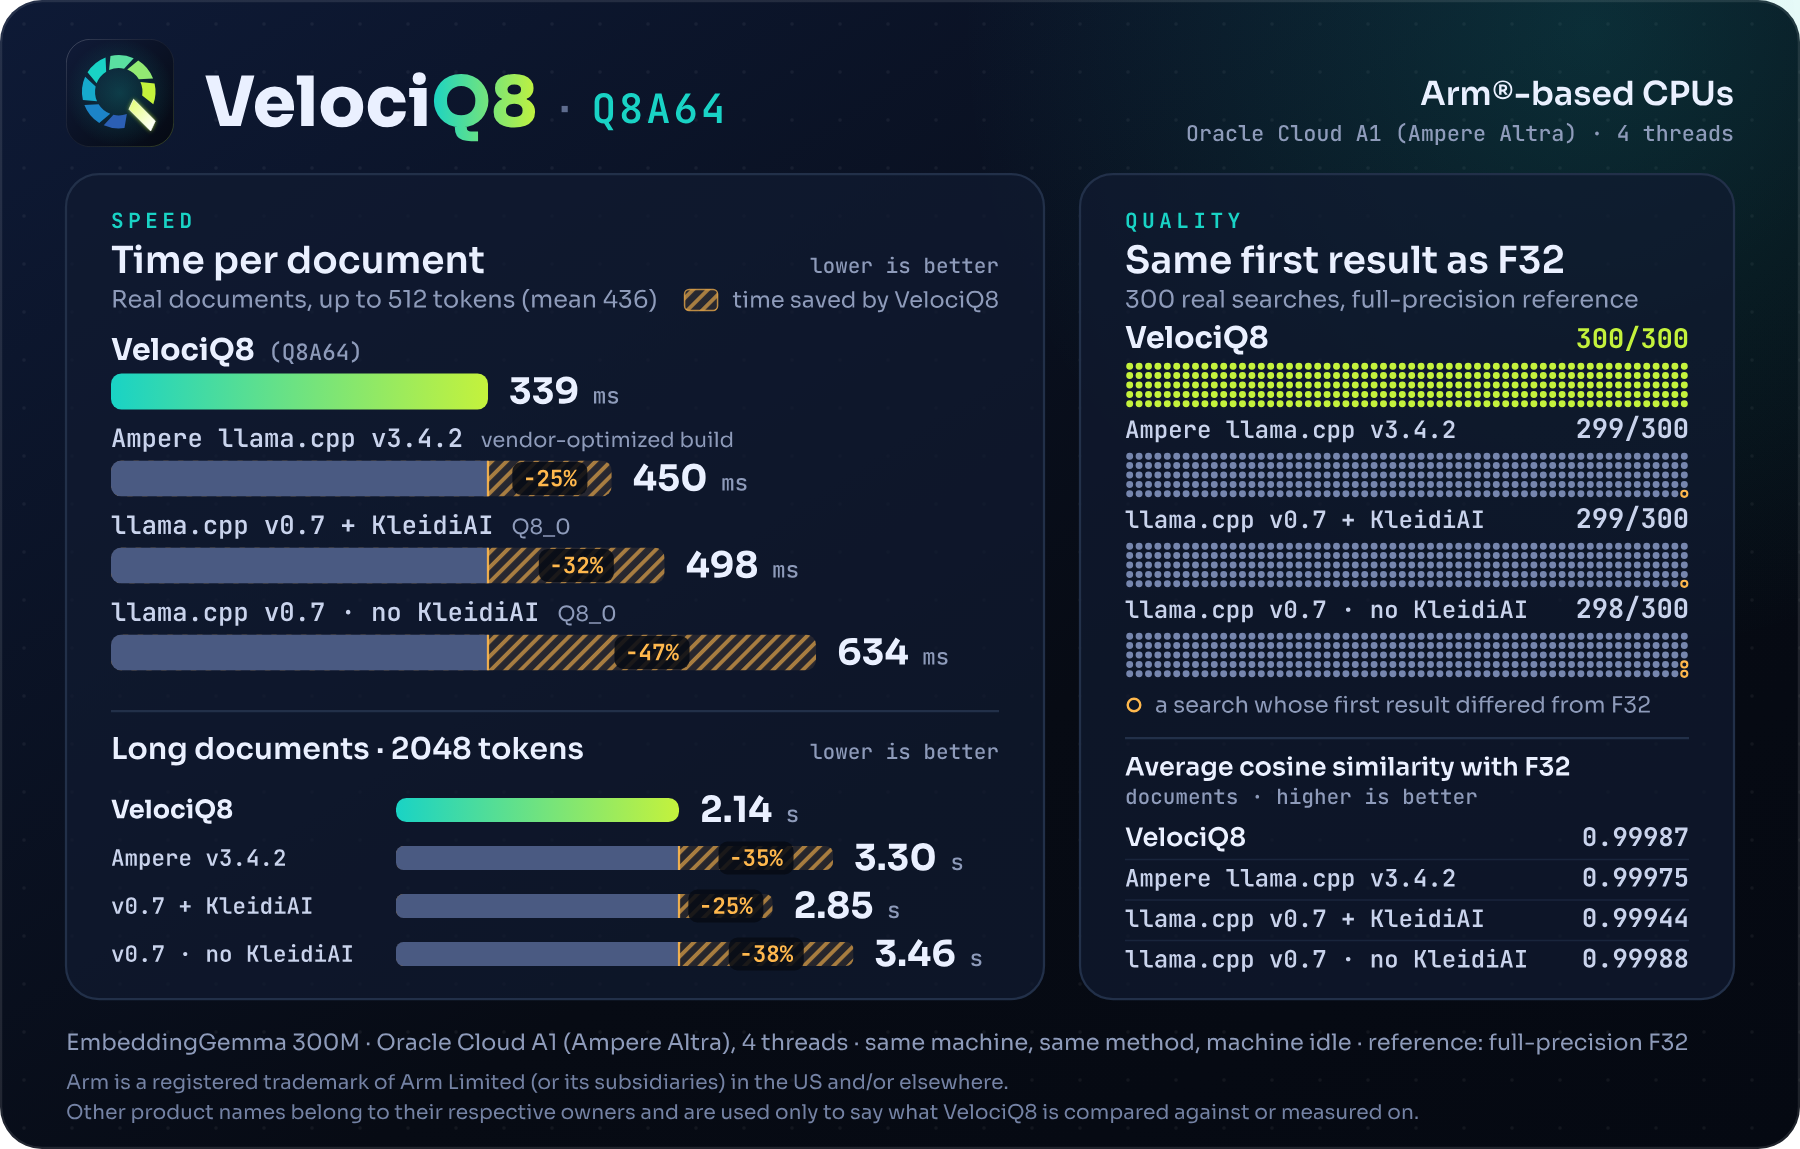
下の画像はEmbeddingGemma 300Mのベンチマーク結果を示す。Armサーバー上での速度比較が明確に記録されている。
メモリ使用量もArm環境で約半分になった。OLMoE-1B-7Bの例では、VelociQ8が6.9ギガバイトに対し、従来のQ8_0形式(llama.cppの標準8ビット量子化形式)は13.6ギガバイトを必要とした。
これはVelociQ8がQ8A64ファイルを直接読み込むのに対し、llama.cppが内部で再パッキングしたコピーを保持するためだ。精度面では、wikiテキスト2でのKL divergence(精度の誤差を示す指標)を測定した。9モデル中7モデルでQ8_0より値が小さくなり、2モデルで同等だった。
Llama-3.2-1Bでは誤差が0.001未満に収まっている。gemma-3-1bを含む他モデルでもQ8_0より値が小さくなり、精度が高いことが示された。300件の実検索でも、Arm環境ではF32フル精度モデルと同じ結果を返している。
商用利用無料と事前変換モデルの公開
公開から2日が経過した現在、公式リポジトリへのコメントはまだ付いていない。ただし、ダウンロード可能なアーカイブはLinuxとWindows、Dockerに対応しており、すぐに試せる環境が整っている。
ライセンスはVelociQ8 Software License Agreementに基づく独自のもので、個人利用も商用利用も無料だ。ただし再配布や改変、逆コンパイルは禁止されている。llama.cpp本体はMITライセンスを維持しており、third-partyコンポーネントもそれぞれのライセンスを継承する。
Hugging FaceにはQ8A64形式の事前変換済みモデルが公開されており、それらはVelociQ8専用で読み込まれる。開発者はベンチマークカードを公開し、MoEモデルの性能比較を示している。x86-64環境でも1.5倍から1.8倍の高速化が記録された。
Dockerイメージはghcr.io/dhaern/velociq8:1.1として提供される。ベンチマークカードにはgranite-3.1-1b-a400mとOLMoE-1B-7Bの比較が含まれる。
i8mm命令対応とアーカイブの拡充
開発者は次期リリースでi8mm行列命令(8ビット整数演算を高速化する命令)のサポートを強化し、Linux Arm向けにマルチアーキテクチャ対応のアーカイブを提供している。起動時にCPUの種類を判定して最適なカーネルを選ぶ仕組みだ。
テキスト生成速度は既存ビルドと同等か、わずかに高速になる傾向にある。Arm環境でKleidiAIビルド(Arm環境向けに最適化されたllama.cppビルド)を使うとDense LLMの処理が16パーセント速くなるが、出力の精度ドリフトが10倍から18倍大きくなる点に注意が必要だ。
linux-arm64-multiアーカイブはNeoverse N1以降やAWS Graviton2に対応する。Intel HaswellやAMD Zen以降のx86-64 CPU向けバイナリも同時に公開された。
今後の予定として、v1.1以降のリリースノートやベンチマーク詳細がGitHub上に公開されている。2026年10月21日に公開された今回のビルドは、ローカル推論のCPU最適化路線をさらに細分化する動きを示している。
llama-quantizeを用いれば自作のQ8A64ファイルを作成できる。v1.1以降のアーカイブは2026年10月21日に公開され、今後もCPU最適化の改良が続けられる予定だ。
用語の注釈
- MoE
- LLMで採用される仕組みで、複数のサブモデル(エキスパート)から選択して処理する技術である。(参考:LLM の「Mixture of Experts (MoE)」を完全に理解する:なぜ ...)
- GGUF
- llama.cppで標準的に使用されるモデルファイル形式で、量子化された重みデータやアーキテクチャ情報を保存する。(参考:GGUF量子化ってなんだ?〜ローカルLLMを爆速で動かすための ...)