ローカルAIニュース:Mistral Large 4公開、16GB向けloaiほか
15秒でわかる今日のニュース
- Mistral Large 4公開、1兆パラメータのMoEモデル
- 428Bモデルを256GB Macで動作、EXL3量子化
- 16GB RAM向けコーディングエージェントloai公開
- Ollama駆動の8Bブラウザエージェントを公開
- 完全オフラインの12人仮想開発チームを公開
Mistral Large 4公開、1兆MoE
Mistral AIは2026年10月29日、総数約1兆パラメータのMoEモデル「Mistral Large 4」をHugging Faceで公開した。MoEは専門家ネットワークを切り替える仕組みで、トークンあたり約490億がアクティブ、埋め込みと出力層を含めると520億になる。テキストと画像を受け取り、テキストを返すマルチモーダル構成で、100万トークンのコンテキスト長を持つ。

推論モードはlow、medium、highをリクエストごとに切り替えられ、コーディングやエージェント用途向けの関数呼び出し、厳密なJSON出力も備える。Artificial AnalysisのCoding Agent Indexでは48%を記録した。GLM-5.3とほぼ並みながら、タスクあたり平均で47%少ないトークン数にとどまった。
ローカルではvLLMやSGLang(推論ライブラリ)、transformers、llama.cpp(ローカル推論エンジン)で動かせる。Blackwell GPU向けのNVFP4量子化版も出ており、同じ性能でメモリ使用量を抑えつつ推論を速める。ライセンスはMITを改変したもので、モデル提供サービスには別途契約が必要になる。なお、チェックポイントにはDSpark(推測デコーディング用ドラフトヘッド)が同梱されている。
256GB Macで428B MoE動作
BobClawblawは2026年10月29日、MiniMax-M3.1-Flashを1台の256GB Mac Studio(M5 Ultra)で動かすレシピを公開した。対象は428B-A23BのMoEモデルで、Mia-AiLabがEXL3(量子化形式)に変換した3.06 bpw(重み1個あたり平均3.06ビット)パックを使う。
TensorFold(推論エンジン)のMetal(Apple GPU向けAPI)エンジンで、パックの重みをそのまま読み込む。
品質面では、元のリリースに対するKLダイバージェンス(出力分布の差)が0.076、トップ1一致率が90.4%と報告されている。その代償として速度は抑えられ、デコードは約25.4トークン/秒、プロンプト読み込みは約500トークン/秒にとどまった。
重み復号の演算がボトルネックになり、1トークンで約240億個の重みに触れるという。提供されるコンテキストは262,144トークンで、重みは約158.9GiBを使う。このビルドでは品質スイートが未実行で、動画推論は未対応、既定では262,144トークン超は提供されない。
16GB RAMとiGPU向けloai公開
kagurasumusunは2026年10月29日、ローカルコーディングエージェント「loai」を公開した。16GB RAMとIntel iGPU(内蔵GPU)のIris Xeを積むWindows 11 PCが対象だ。既存ツールが重い環境で、モデル選定から量子化、llama.cpp(ローカル推論エンジン)の起動設定、エージェントの文脈管理までを個別に調整する。
主力のQwen3-8B Q4_K_M(量子化形式)はファイルが4.7GB、メモリ使用見込みが約6.1GBだ。コーディング特化のQwen2.5-Coder-7B Q4_K_Mは4.4GB、約5.1GBとされる。KVキャッシュ(推論時の中間状態)をq8_0/q4_0に量子化し、Flash Attention(高速化機能)を有効化する。Vulkan(GPU API)でIntel iGPUへ自動オフロードする仕組みを持つ。
エージェントは7つのツールを持ち、ファイル変更とコマンド実行では差分プレビュー付きの承認を要求する。依存はRust(プログラミング言語)のライブラリ10個だけで、単一バイナリを出力するが、VS Code拡張やSYCLバックエンドの自動ベンチは未実装だ。会話履歴の永続化、並列エージェントも、ロードマップに未実装として残っている。
Ollamaで動く8Bブラウザエージェント
zhangwei-ai-labは2026年10月29日、ブラウザを操作する「LocalManus-BrowserAgent」を公開した。Ollama(ローカルモデル実行基盤)上の8Bモデルだけで、クラウドAPIキーを使わずに動く。ファイル書き込みやUI(画面)状態管理は端末内で行い、ウェブサイト閲覧もローカルモデルで駆動する。
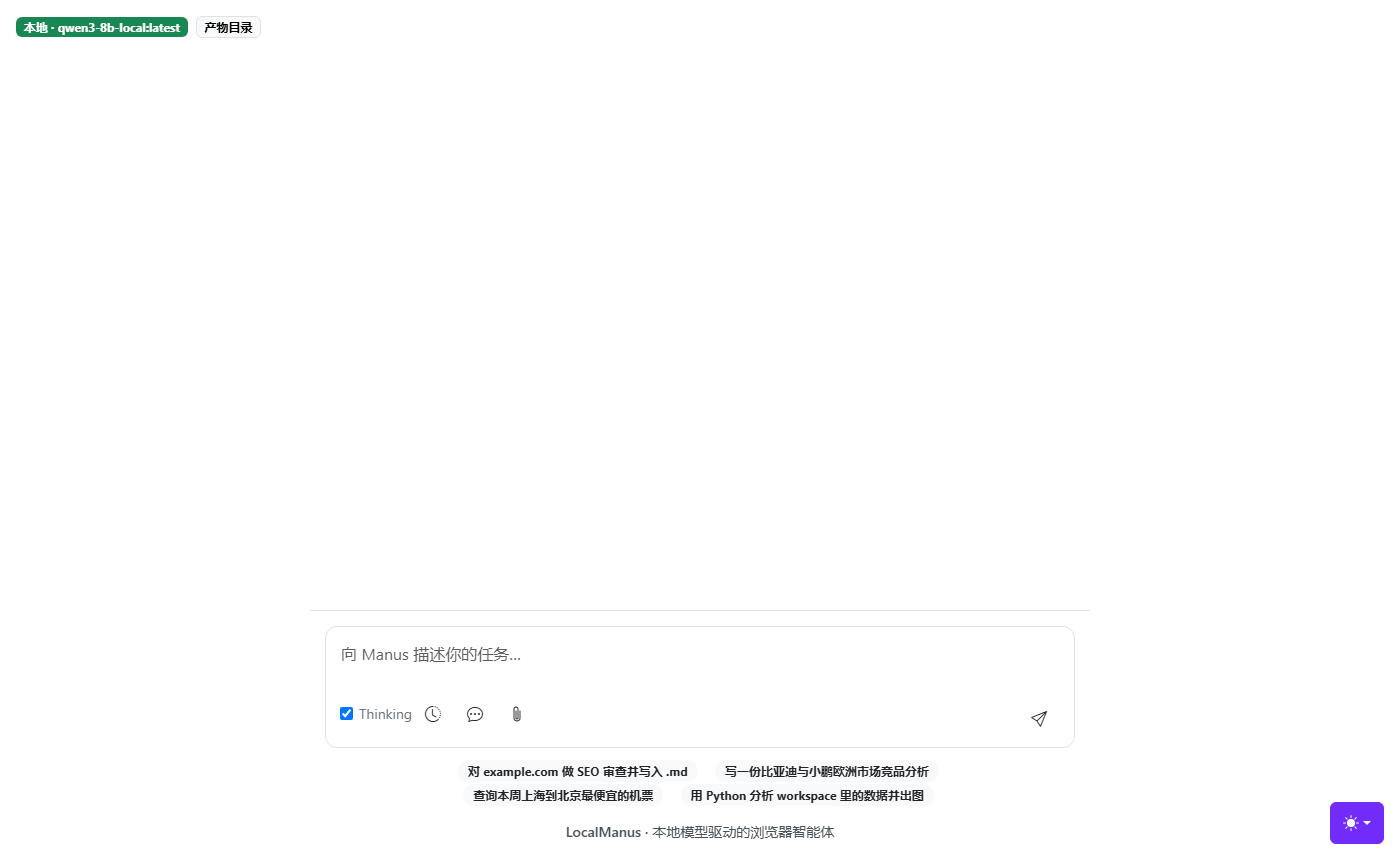
検証では、qwen3-8b-local(8.2B、Q4_K_M、40960トークン、ツール呼び出し対応)を使う。ファイル書き込みを2ステップ15秒、ブラウザ操作を4ステップ49.3秒で完了した。基盤にはOpenManus(エージェント用フレームワーク)を使い、モデル適応層、プロンプト(指示文)契約、ループ保護など8つの層を独自に追加した。
連続実行対策として、同じ動作の連打にソフト制限3回、ハード制限5回を設ける。ブラウザではスクリーンショットを捨て、要素リストと1200文字のページ本文を渡す純テキストモードを採用する。Chromiumの残留プロセスは、PID(プロセスID)スナップショットで精密に回収する。
完全オフラインの12人開発フレームワーク
Wei-Chi Chenは2026年10月29日、完全オフラインのソフトウェア開発フレームワーク「ai_enterprise」をGitHubで公開した。Ollama(ローカルモデル実行基盤)を前提に、複数の役割を持つAIを連携させるマルチエージェント型を掲げる。標準構成は12人の仮想スタッフで、スタッフ数、役割、モデル、メモリ予算、並行タスク枠を自由に設定できる。
コードは生成して終わりにせず、ExecutionSandbox(実行用隔離環境)でテストを走らせる。失敗時は14Bモデルの審査役、32Bモデルの技術責任者、32Bモデルの最終裁定役が段階的に修正する。既定モデルにはqwen2.5:32b、qwen2.5-coder:32b、qwen2.5-coder:14bを挙げる。llava、llama3.1:8b、qwen2.5:7bも既定構成に含まれる。
主な動作対象はWindows 10/11 x64で、LinuxとmacOS向けコードは残るが未検証だ。ローカル推論は遅く、単一タスクが10〜30分かかる場合があり、メモリ逼迫時はデータ退避(スワップ)による遅延が起きる。ロードマップには、Docker(コンテナ技術)化と外部AIへの自律的なフォールバックが予定されている。
出典
- mistralai/Mistral-Large-4-1T-A52B (image-text-to-text)(Hugging Face trending) · 議論
- BobClawblaw/minimax-m31-flash-exl3-m5-ultra: MiniMax-M3.1-Flash as Mia-AiLab's EXL3 pack (3.06 bpw, as published) on one M5 Ultra Mac with TensorFold's native Metal engine: KL 0.076 vs the release, 25 tok/s, vision, tools, 256k context(GitHub topic llm-inference)
- kagurasumusun/loai: 極限最適化ローカルコーディングエージェント — 16GB RAM + Intel iGPU (Iris Xe) 向け llama.cpp + 量子化モデル + 自律エージェント(GitHub topic local-llm)
- zhangwei-ai-lab/LocalManus-BrowserAgent: 本地模型(Ollama)驱动的浏览器智能体,不依赖云端 API Key(GitHub topic local-llm)
- wei-chi-chen/ai_enterprise: Fully local, offline autonomous multi-agent software enterprise framework powered by Ollama.(GitHub topic local-llm)