ローカルAIニュース:Jetson ThorでDeepSeek高速推論
20秒でわかる今日のニュース
- Jetson ThorでDeepSeek推論サーバー公開、最大40.2 tok/s
- AppleのPersonal Knowledge Graph悪用実験が公開
- Pika LabsがMiniMax-H3ベース動画生成モデル公開
- ATDEVがvLLMプラグイン公開、A100でQwen最大14.2倍
- iQuantizeがLLM量子化デスクトップアプリ公開
Jetson ThorでDeepSeek高速推論サーバー
GitHubユーザーpatrickbdevaneyは2026年10月30日、NVIDIAのJetson AGX Thor向けの推論サーバーを公開した。NVIDIA GPU向けの処理基盤CUDAだけを使い、リクエスト経路にPythonを置かない。対象はDeepSeek-V4.1-Flash-1017である。
REAP法で、モデル内の専門家ネットワークを384から192に剪定し、量子化している。OpenAI互換API、つまりOpenAIの形式で使えるAPIを提供する。2026年10月30日の計測では、デコード速度、つまり生成速度が最大40.2 tok/sだった。
プレフィル速度、つまり入力プロンプトの読み込み速度は最大739 tok/sだった。既定では分岐予測デコード、つまり候補をまとめて検証する手法が有効だ。モデル自身のDSpark drafter、つまり候補生成モデルが3トークンを提案し、本体が一度で検証する。
貪欲デコード、つまり毎回最も確率の高いトークンを選ぶ出力では従来比1.345倍の速度で、トークン列は完全一致した。コンテキスト、つまり入力と生成の総量は既定32Kだが、長文状態も試されている。1,048,576トークンの状態割り当ては、2026年10月25日に旧エンジンで通った。
64Kトークンプレフィル後のデコードも、同じ日に確認済みだ。コードとウェイトはMITライセンスで、サーバーはテキスト専用であり、リクエストは一度に1つだけ処理する。
Appleの知識グラフ悪用実験公開
Eighth Rankは2026年10月29日、思考実験を公開した。Apple IntelligenceがMac上に構築する個人関連の知識ベースPersonal Knowledge GraphをLLMに与えた場合の悪用可能性を扱った。対象はmacOS 13以上で動くIntelおよびApple silicon搭載Macである。
Personal Knowledge Graphは、家族関係や通信、予定などを推定している。数MB規模のSQLiteファイル、つまり軽量なデータベースファイルとして、ほぼ同じスキーマで保存される。実験ではmacOS 26.6.2上の個人用Knowledge Graphを抽出し、安全制限を外したLLMへ渡した。
その結果、家族構成と予定から監禁・恐喝の計画を自動生成し、削除済みデータを用いたZersetzung型のキャンペーンも作成した。Zersetzungは、旧東ドイツの秘密警察が用いた関係者への小細工による分断手法である。通信ログには過去1年分の600名、6,542件の相互作用が残っていた。
削除操作は行を削除せず、期限切れテーブルへ移すだけだ。キャプチャ時点では51の人間関係と2,420のイベントを含む2,471行が残っていたが、保持期間については明確でない。
出典:Hacker News
Pika H3 Flexで音声付き動画生成
Pika Labsは2026年10月29日、動画生成モデルPika H3 Flexを公開した。ローカル推論を想定する。モデル共有基盤Hugging Faceで手に入る。

基本モデルはMiniMaxAIのMiniMax-H3で、配布はMiniMax H3 Community License Agreementに従う。モデルカードでは、ライブラリにdiffusers、画像から動画へ変換するパイプラインimage-to-videoが指定されている。参照入力機能Ref2VAは画像9枚、動画3本、音声3本を最大12件の参照入力として受け付ける。
ローカルでは480pと768pのネイティブ解像度で、混合ステレオ音声付きの動画を生成する。API経由では最大4Kまで対応する。公開ページには、画像や動画、音声の参照を組み合わせた例が並ぶ。
A100でQwen推論14.2倍のプラグイン
ATDEVは2026年10月30日、LLM推論基盤vLLM 0.31.0に組み込むプラグインatdev-serveをGitHubで公開した。単一のNVIDIA A100 80GB上でQwen3.8-27Bの推論を高速化し、既存のOpenAI互換サーバーをそのまま使う。
単一ユーザーのデコードでは、標準的なvLLMのbf16基準が28.9 tok/sだった。bf16は16ビット浮動小数点形式である。atdev-serveは408.9 tok/sへ、最大14.2倍向上した。
32並列リクエストでは合計2,730.9 tok/sを出し、bf16基準の4.1倍、最も速い標準vLLM設定の1.55倍となった。高速化にはカスタムCUDAカーネル、木構造推測デコーディング、つまり候補木をまとめて検証する手法、量子化、スケジューリング改善を使う。
精度検証では数学推論ベンチマークGSM8Kが標準vLLMとの差1ポイント以内、長文検索が36/36だった。対応環境はLinux、NVIDIA A100 80GB、CUDA 13.0、Python 3.12、vLLM 0.31.0である。
iQuantizeでGGUF量子化をGUI化
FazminとiQuantize貢献者は2026年10月30日、デスクトップアプリiQuantizeをGitHubで公開した。LLMをモデル形式GGUF、MLX、ONNXへ、モデルの重みを低ビットに圧縮する量子化で変換する。Rust、つまりメモリ安全なシステム言語と、デスクトップアプリ基盤Tauri v2で構築した。モデルの探索から量子化、比較、Hugging Face公開までをアプリ全体で進める。
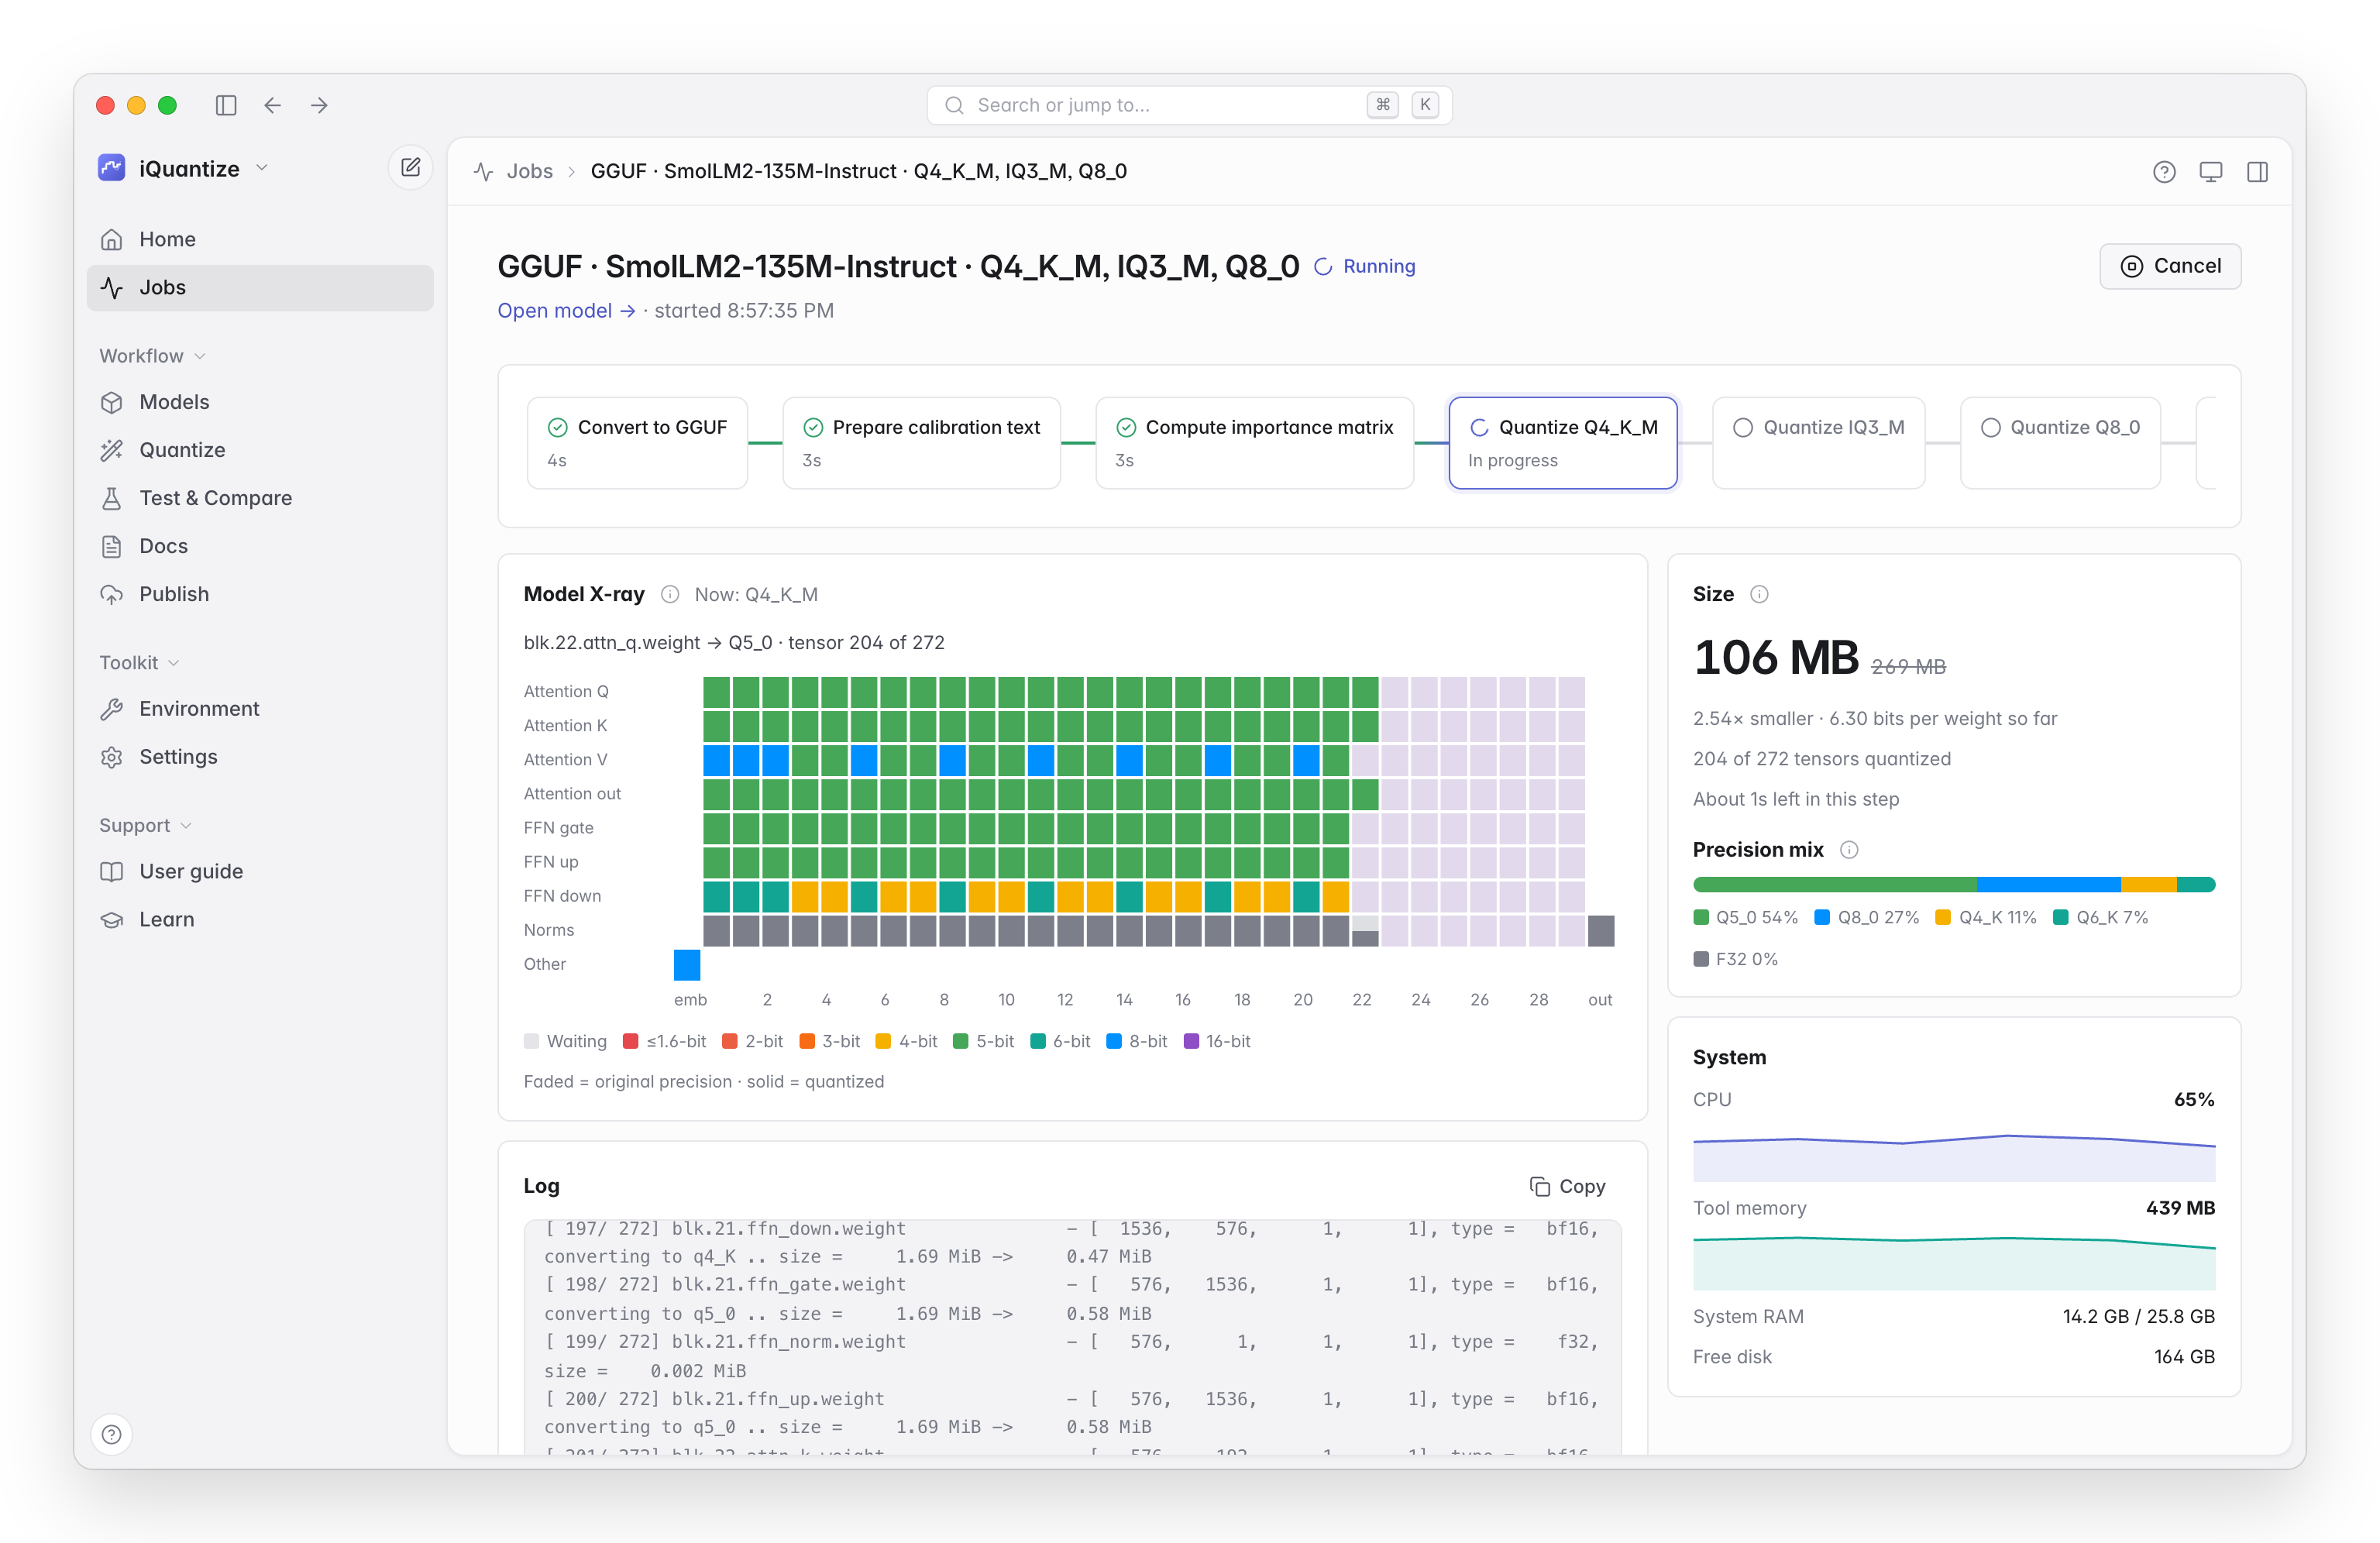
アプリはuv、つまりPython環境管理ツールをダウンロードし、専用Python 3.12と形式ごとに隔離した環境を作る。推論基盤llama.cppの検証済みビルドも取得し、Metal、CUDA、Vulkan、ROCm、CPUのバックエンドから選べる。量子化中はテンソル、つまり重み行列単位の変化、サイズ減少、ビット幅の割合、評価ログをライブ表示する。
比較機能では、元モデルとのチャット、完全一致率、ROUGE-L、つまりテキスト類似度、速度を並べて確認できる。さらにパープレキシティ、つまりテキスト予測の指標とKLダイバージェンス、つまり分布のずれを測る。
Apple Silicon搭載macOSは完全検証済みだ。WindowsとLinuxはCI、つまり継続的インテグレーションでビルドされるが、実機手動実行が必要だ。MLXは、Apple Silicon以外の環境ではUI、つまり操作画面が機能を無効化して理由を表示する。
出典
- patrickbdevaney/deepseek-v4.1-flash-cuda-server: Pure-CUDA OpenAI-compatible server for DeepSeek-V4.1-Flash-1017 REAP-192 on Jetson AGX Thor: 25 tok/s decode, 740 tok/s prefill, Engram read from NVMe, deterministic greedy, every speedup id-exact(GitHub topic llm-inference)
- Organizing a kidnap using Apple's personal knowledge graph (and an LLM)(Hacker News) · 議論
- Pika-Labs/Pika-H3-Flex (image-to-video)(Hugging Face trending) · 議論
- atdev-company/atdev-serve: Up to 14.2x faster Qwen3.8-27B inference on a single A100 - a drop-in plugin for vLLM 0.31.0. Models: huggingface.co/atdev-company(GitHub topic llm-inference)
- Fazmin/iQuantize: Desktop workspace for quantizing LLMs to GGUF, MLX and ONNX. Watch every tensor change, compare against the original, and publish to Hugging Face with an auto-written model card.(GitHub topic local-llm)