ローカルAIニュース:GLM-5.3を単一GB300で約140トークン毎秒
20秒でわかる今日のニュース
- Hecateが753B GLM-5.3のDGX向け推論基盤を公開
- AMD RX 7900 XTXでQwen3.8-27B手順を公開
- DeepSeek-V4.1-Flash拒否除去版がHugging Faceに公開
- Audio8-TTS-Realistic-0.6BがHugging Faceに公開
- TarnがApple Silicon向けローカルAIアプリを公開
GLM-5.3を単一GB300で約140トークン毎秒
chronarionは2026年11月1日、GitHubでHecateを公開した。753BパラメータのGLM-5.3を単一のNVIDIA DGX Station GB300で動かすためのハイブリッド推論ランタイムだ。ExLlamaV3とTabbyAPIを基盤に、OpenAI互換サーバーを1つのコンテナで提供する。
モデルはどのメモリにも収まらないため、MoE(混合専門家)層を3つのプロセッサへ同時に分割する。GB300のHBM3e、RTX PRO 6000 BlackwellのGDDR7、Grace CPUのLPDDR5Xが使われる。その結果、コンカレンシー1(同時実行1件)のデコード速度は約140トークン毎秒に達した。16Kから128Kのコンテキスト長では、116から119トークン毎秒の速度を保った。
BF16(bfloat16形式)モデルとのKLダイバージェンス(分布の近さを示す指標)は0.0740で、公開済み3bit EXL3量子化の0.1013より低い。デフォルトは2×256Kコンテキストで、長文コンテキスト設定なら単一会話で最大100万トークンに対応する。
評価では、コンカレンシー4以上でMTP(多段推測)ドラフトが削減され、単一測定は生成テキストにより上下10%ほど変動する。KL比較も評価窓が異なる初期段階の数値であり、同一プロトコルでの再評価が予定されている。
RX 7900 XTXでQwen3.8-27BをROCm実行
thefahienは2026年11月1日、GitHubでRX 7900 XTX向けのQwen3.8-27B実行レシピを公開した。構成はEXL3 4.00bpw(1重みあたり4.00ビット)量子化と、DFlash2の推測推論ドラフト(軽い候補モデル)の組み合わせだ。exllamav3-rocm(ExLlamaV3のROCm移植)とTabbyAPIを介してAMD GPU上で動かすための手順だ。
公開物にはROCm 7.2.4向けのビルド修正と、ドラフト重みを読み込むための修正が含まれる。
ベンチマークでは思考オフでコード推論が約177トークン毎秒、文章推論が約75トークン毎秒、プリフィル(入力処理)が約1100トークン毎秒だった。同一カードのllama.cpp比でコードが約2倍(ただし重みは異なる)、RTX 3090上のCUDA版elpisの約70%に相当する。
30分間の連続負荷テストでは198リクエストと191kトークンを処理し、エラーはゼロで、最初と最後の5往復の差は0.5%以内だった。Q8 KVキャッシュ(推論中間状態)で131kトークンに対応し、122kプロンプト時の最大VRAMは22.45 GiBだった。ROCm側は7トークン鎖の検証とQ8/FP16のみ対応のため、CUDA版との差はエンジン側の機能差として説明されている。
DeepSeek-V4.1-Flash拒否除去版を公開
AtomicChatは2026年10月31日、Hugging Faceでモデルを公開した。名称はDeepSeek-V4.1-Flash-1017-Uncensored-GSQ-RCO-GGUFだ。ISTA-DASLabのGSQ-RCO量子化を基盤に、DeepSeekの拒否方向を密な残差書き込み層から投影除去したモデルだ。
384エクスパートを持つ763BパラメータのMoE(混合専門家)モデルとして構成されている。ルーターで選択される専門家側は、元の量子化データをバイト単位で完全に保持する。
実測では、IQ2_XXSでJailbreakBench英語の拒否率が85.2%から0.0%へ下がった。XSTestの安全質問に対する拒否率も測定結果では7.6%から0.0%へ下がった。一方、GPQA-Diamondは83.3%で同等、AIME25は76.7%から80.0%へ上がったが、30問での差はノイズ範囲内とされる。
実行にはStrataを使い、本体をシステムメモリに置き、110 GBのEngramテーブル(検索表)をSSDからストリームする。単一12 GB GPUで動作するが、ファイル合計は249 GB級であり、高速SSDが前提になる。拒否分類器は回答冒頭だけを見るため、回答途中のソフト拒否を通過させる可能性がある。
Audio8-TTS-Realistic-0.6Bを公開
Edge0は2026年11月1日、Hugging Faceで音声合成モデルAudio8-TTS-Realistic-0.6Bを公開した。本体はDualAR(2つの自己回帰を組み合わせる)の601,159,424パラメータで、44.1 kHzニューラルオーディオコーデックスは別カウントだ。Preview版の11言語から12言語を増やし、日本語を含む23言語へ対応を広げた。
参照音声から話者を再現するゼロショット音声クローニングと、参照音声なしの生成を使い分けられる。コードと重みはApache License 2.0で公開された。SGLang Omniアダプター(推論サーバー向け拡張)はページドアテンション(ページ単位メモリ管理)と動的バッチ、OpenAI互換の音声APIを提供する。ただし検証はNVIDIA H20でBF16の実行確認にとどまり、スループットとストリーミングは未ベンチマークだ。
評価ではSeed-TTS英語と中国語の平均エラー1.25%を報告した。CV3 9言語平均4.86%、MiniMax 24言語平均5.89%だった。日本語はCV3でCER(文字エラー率)7.511%、話者類似度0.6659が測定された。言語別の音声品質にばらつきがあり、参照音声はクリーンで、文字起こしは音声と一致している必要がある。
TarnがMac向けローカルAIアプリ公開
Rishab87は2026年11月1日、GitHubでApple Silicon Mac向けのローカルAIアプリTarnを公開した。TarnはmacOS 26以降、M1以降、メモリ8 GB以上を動作要件にしている。チップとメモリ容量を自動判定し、RAMの半分を空けたまま動作する最も高性能なオープンモデルをインストールする。
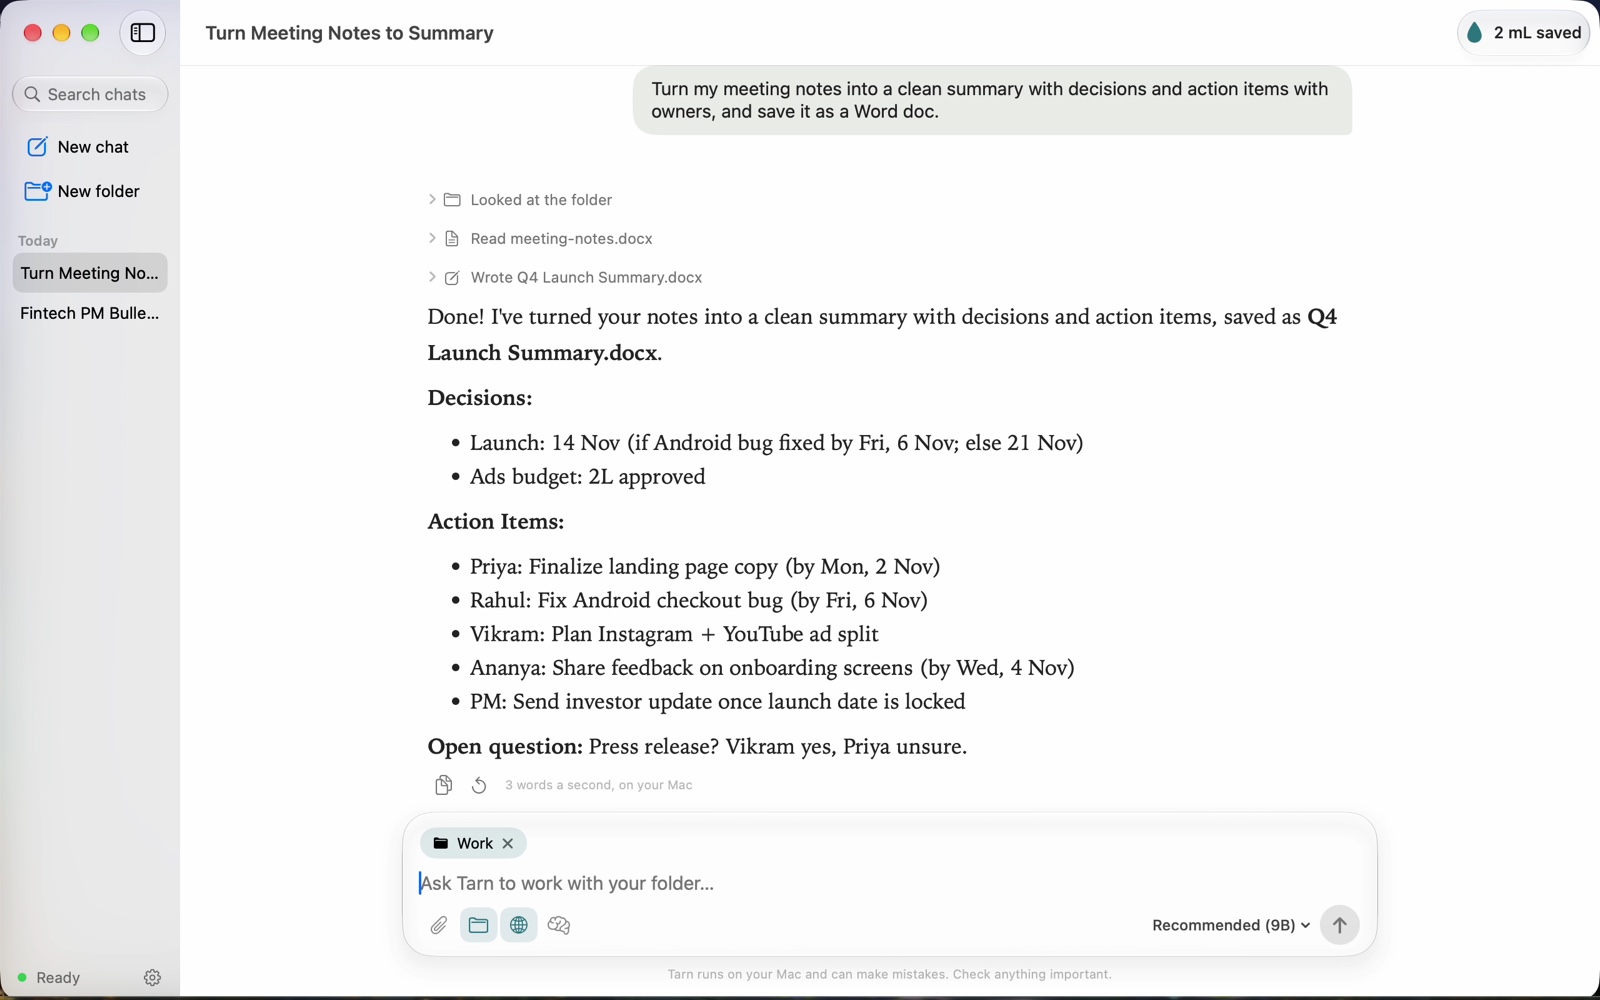
アプリはllama.cpp(ローカル推論エンジン)のllama-serverを内部エンジンとして使う。エンジンサーバーは127.0.0.1にランダムキーでバインドし、アプリ終了時は監視プロセスがサーバーを停止する。アプリは会話記憶、画像入力、DuckDuckGo検索、フォルダ操作、MCP(モデル接続プロトコル)コネクタ、Claude互換のスキルに対応する。
公開ビルドは現時点でNotarized(Appleの公証)が済んでいない。初回起動時にSystem SettingsのPrivacy & SecurityでOpen Anywayを選ぶ必要がある。Rishab87は、データセンターで処理されない回答1件あたり約1.1 mLの節水効果として表示する機能も挙げている。
出典
- chronarion/hecate: Hecate: GLM-5.3 (753B MoE) on one NVIDIA DGX Station GB300 (GB300 + RTX PRO 6000 + Grace), ~138 tok/s at concurrency 1. Hybrid inference and quantization on ExLlamaV3 + TabbyAPI.(GitHub topic llm-inference)
- thefahien/elpis-on-7900xtx: Qwen3.8-27B EXL3 + DFlash2 speculative decoding on an AMD RX 7900 XTX (exllamav3-rocm): recipe, patches, benchmarks(GitHub topic llm-inference)
- AtomicChat/DeepSeek-V4.1-Flash-1017-Uncensored-GSQ-RCO-GGUF (text-generation)(Hugging Face trending) · 議論
- Edge0/Audio8-TTS-Realistic-0.6b (text-to-speech)(Hugging Face trending) · 議論
- Rishab87/tarn: A private AI that lives on your Mac. Native SwiftUI app running open models locally with llama.cpp: memory, web search, images, files, MCP connectors and skills. No account, no cloud.(GitHub topic local-llm)