ローカルAIニュース:40MBのGPUWorks公開ほか
20秒でわかる今日のニュース
- GPUWorksがGitHubで公開、異種GPUを一元管理
- RTX 5090二枚でQwen3.8-27B投機デコード実測
- Ampere向けGLM-5.3-Flash FP8 KVキャッシュ公開
- MiniMax-H3基盤P-H3-ImageのComfyUI版公開
- 24GB GPUでQwen3.8-Flash-Nextの長文脈推論を評価
40MBのGPUクラスター管理
flitai-ioは2026年11月4日、GPUクラスター管理の「GPUWorks」をGitHubで公開した。Kubernetesを必要としない。MaaS、すなわちモデルをサービスとして提供する仕組みだ。
制御プレーンはWeb UIを含めて40MBである。サーバーとエージェントはそれぞれ単一の静的バイナリとして配布される。
NVIDIA、AMD InstinctとRyzen AI Max、Huawei Ascendが同一クラスターで扱える。T-Head PPU、Hygon DCU、Apple Siliconも同じプールで動く。公式カタログには392モデル向けに1,235種類の起動設定がある。
Alibaba Cloudでの検証では、1台のサーバーで7リージョンの1,003台のレンタルGPUマシンを管理し、4分で500以上のレプリカを起動した。ライセンスはApache License 2.0で、Go 1.26とNode.jsが必要になる。
KubernetesクラスターとSlurmパーティションの対応は今後の予定である。
出典:Hacker News
RTX 5090二枚で投機デコード実測
GitHubユーザーlichen9240-creatorは2026年11月4日、実験を公開した。RTX 5090を2枚使い、Qwen3.8-27B-FP8を動かした。385回の実リクエスト負荷試験で5経路を比較した。
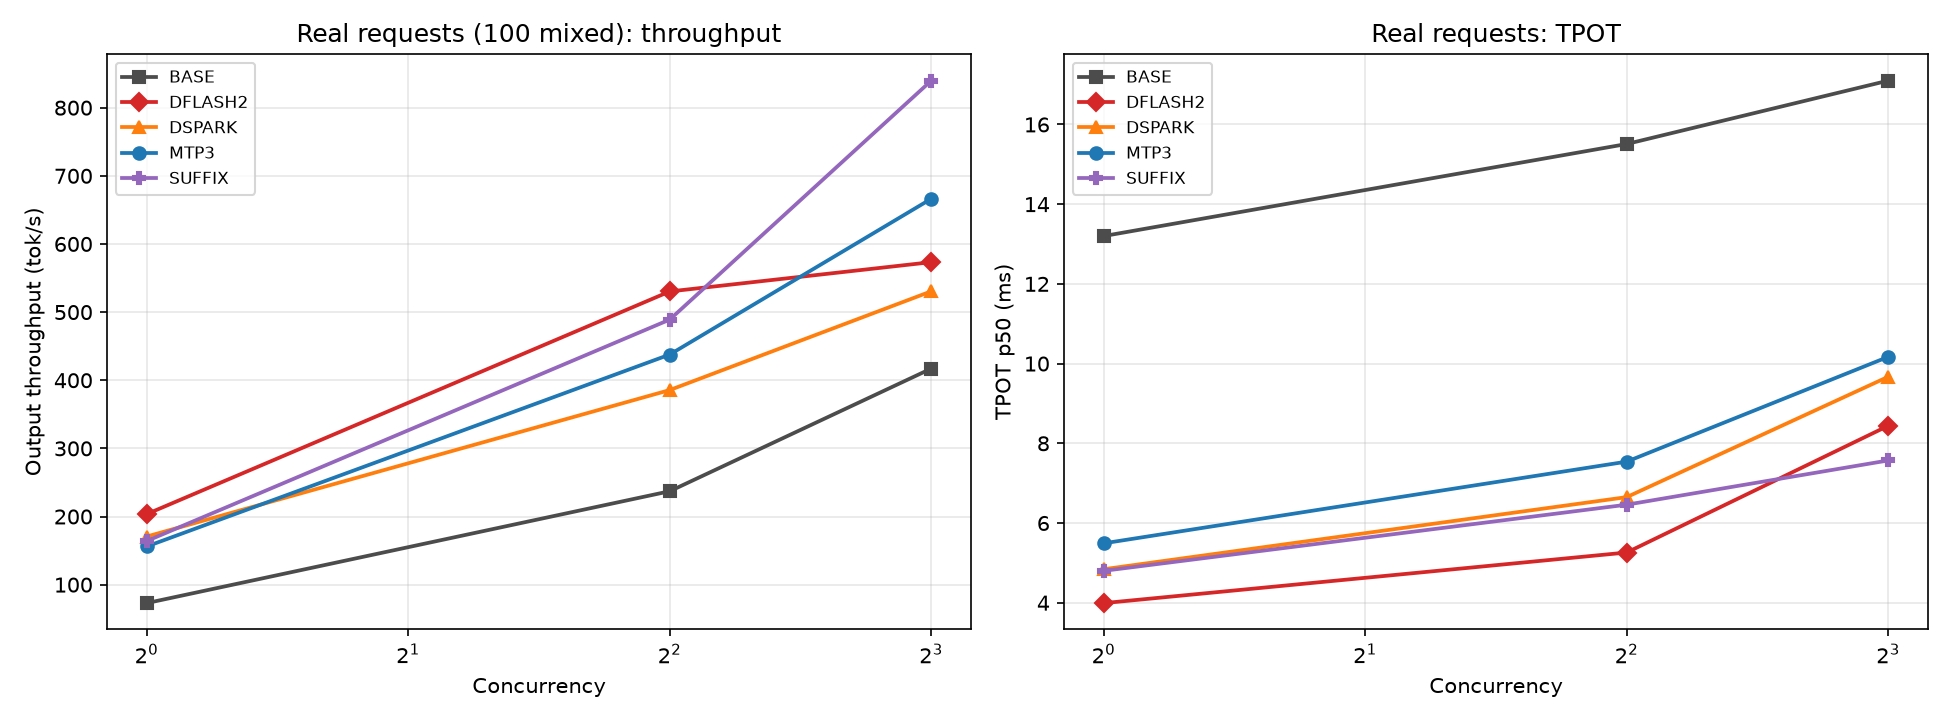
投機的デコーディングは候補トークンを先に生成し、本体モデルで検証して速度を上げる手法だ。環境はvLLM 0.32.0とCUDA 13.0で、NVLinkのないテンソル並列2構成である。
低並列ではDFlash2 K=6が203.5 tok/sで基準の2.79倍となった。TPOT(トークン生成間隔)は3.99msだった。高並列ではMTP3が666.3 tok/sで最も安定していた。
SUFFIXは初回実行で1.14倍にとどまり、繰り返すと同じ出力がキャッシュされ2.25倍に見える。推論中間状態のKVプール容量は基準207kトークンからDFlash2では58kへ減る。EAGLE-4は二つの経路で動作せず、性能値は示されていない。
候補採用率はタスク種類で0.381〜0.828に変わり、高速化の差はK値やエンジンよりタスク種類に依存する。
AmpereでGLM-5.3-Flash FP8 KV
SheridanLuは2026年11月4日、GLM-5.3-Flash向けのFP8 KVキャッシュ実装をGitHubで公開した。FP8 KVキャッシュは推論中間状態を8ビット浮動小数点で保持する仕組みだ。
モデルは320BパラメータのMoE、つまり専門家を集めた疎な構成を持つ。Ampere世代ではfp8e4nv命令がない。TritonはGPUカーネル記述言語であり、そのカーネル内で整数ビット演算によりFP8を復元する。
ページは1層あたり1トークン528バイトで、BF16の1024バイトより小さい。KVプールは955,759トークンから1,771,693トークンへ1.85倍に増えた。512Kトークンの同時リクエスト能力は1.82倍から3.38倍へ向上した。
文書中に埋めた情報を探すニードル検索は、8Kから400Kトークンで12件すべて正答した。単一ストリーム速度は107〜110tok/sで測定ノイズ範囲内だった。実運用ではBF16時にプールが99.7%埋まり、共通接頭辞を再利用するプレフィックスキャッシュのヒット率が1〜7%へ低下していた。
同一プロンプトでのBF16とFP8の精度比較は未実施で、合成データでの誤差測定にとどまる。
P-H3-ImageのComfyUI版公開
PrunaAIは2026年11月3日、P-H3-ImageのComfyUI対応ファイルをHugging Faceに公開した。P-H3-ImageはMiniMax-H3を基盤とする画像生成・編集モデルである。

ComfyUIはノードを組んで拡散モデルを動かすツールで、このモデルは独自のノードを必要としない。量子化形式はbf16、int8、w4a8が用意される。int8は8ビット量子化、w4a8は4ビット重みと8ビット有効値を使う形式だ。
最小セットは20GBのダウンロードで、8メガピクセル画像を最大21GBのVRAM、つまりGPUメモリで生成できる。8ステップでCFG(classifier-free guidance)を使わずに描き、最大8枚の入力画像を使った編集もできる。
プロンプトのアップサンプリングにはQwen3.5-9Bベースのモデルを用いる。ライセンスはMiniMax H3 Community Licenseで、欧州連合、英国、韓国、米国では別途ライセンスが必要になる。
ComfyUIの安定版への統合は次のリリース以降で、現時点ではmasterブランチまたはnightly版を使う。
24GB GPUで256K推論を測定
GitHubユーザーAdam90aは2026年11月4日、長文脈推論を評価した結果を公開した。RTX PRO 4000 Blackwellと128GBメモリを備えた環境で、llama.cppを使った。
Qwen3.8-Flash-NextのUnsloth UD-Q4_K_XL GGUFを使った。これはllama.cpp向け重み形式である。256K超の262,169〜262,376トークンで10回連続合格した。毎回13/13で、検索、集約、文脈横断の推論、常時指示の検査を通過した。
同一の262Kプロンプトでは、Qwen Q4、Claude Opus 5.5、MiniMax-M3がすべて13/13だった。AIME 2026の数学推論では15問中14問正解し、Opus 5.5は15/15だった。512Kでも2回とも13/13を達成し、約1Mトークンは窓に収まらなかった。
MTP推測デコードは複数トークン予測による投機的実行で、短文脈では31%高速化するが、262Kでは15%低下するため、長文脈では無効化する。llama.cppは2026年11月2日時点のコミットでビルドされ、CUDA 13と12の混在による環境問題も報告されている。
出典
- Show HN: GPUWorks – A 40 MB GPU cluster manager for vLLM/SGLang, no K8s needed(Hacker News) · 議論
- lichen9240-creator/qwen27b-spec-decode-2x5090: Qwen3.8-27B 双 RTX 5090 投机解码实测:vLLM 0.32.0 + TP=2,MTP/DFlash2/DSpark/SUFFIX/EAGLE-4 五条路径 × 385 次真实请求压测,含完整数据、脚本与免 GPU 的可复现校验(GitHub topic llm-inference)
- SheridanLu/glm53-flash-a40-fp8kv: GLM-5.3-Flash AWQ on 8xA40 (sm_86): NoPE FP8 KV cache port (528 B/token, 1.85x KV), patch dry-run notes, concurrent canary monitor, tests + raw logs. Experimental.(GitHub topic llm-inference)
- PrunaAI/P-H3-Image-Comfy (text-to-image)(Hugging Face trending) · 議論
- Adam90a/local-256k-reasoning: Which open-weight model reasons reliably over 256K+ tokens on one 24 GB GPU? Measured: Qwen3.8-Flash-Next passes 10/10 strict-256K runs on an RTX PRO 4000, on par with Claude Opus 5.5 on identical prompts.(GitHub topic local-llm)