Qwen3.8-Flash-Next公開、UnslothがGGUF量子化版をローカル提供
20秒でわかる内容解説
Qwenは2026年11月5日、実験的モデル「Qwen3.8-Flash-Next」をオープンウェイト(重み公開)で公開した。大きな総パラメータのうち一部だけ活性化する設計で、長文と学習効率の両立を掲げる。Unslothはローカル推論向けの量子化版を公開し、自分のPCで試す入口を用意した。自分のPCで動かす人は、実行環境とライセンスを確認してから試せる。
Qwen3.8-Flash-Nextの層構成とパラメータ配分
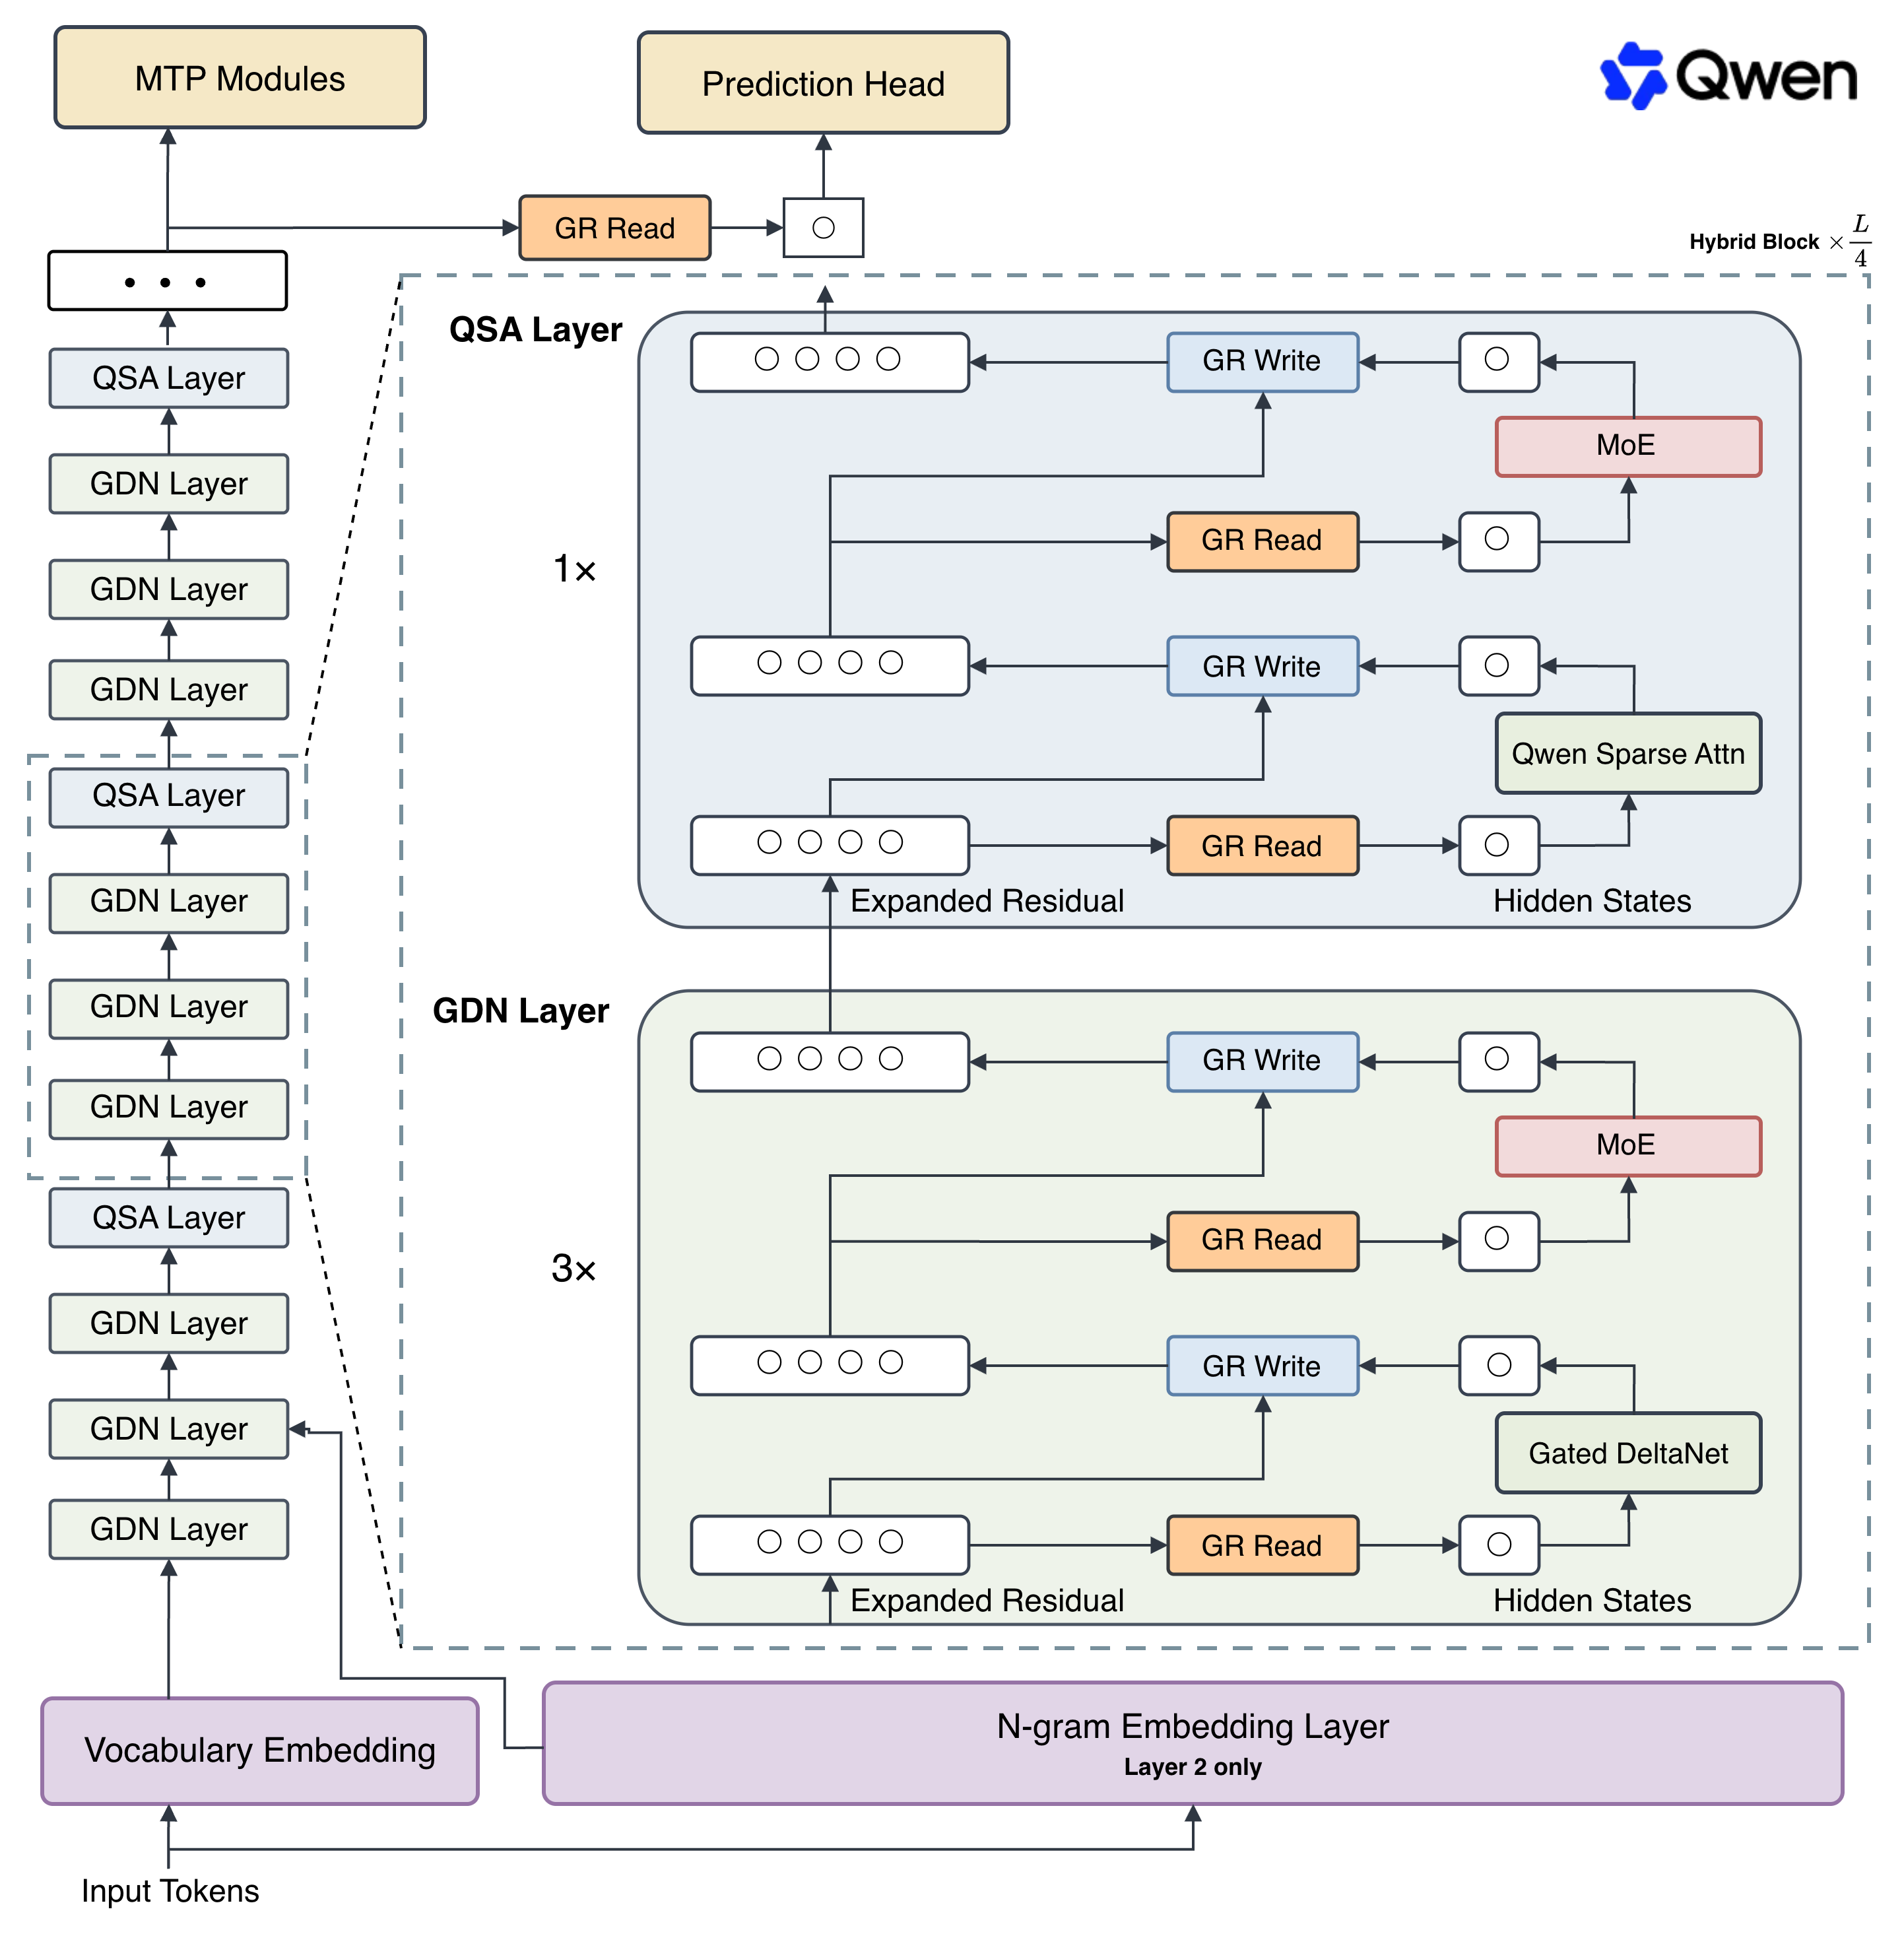
Qwen3.8-Flash-Nextは、言語と画像を受け取る因果言語モデルとして公開された。層の配置は、Gated DeltaNetとMoEを3回、Qwen Sparse AttentionとMoEを1回、その組み合わせを12回繰り返す。この配置は、線形アテンションと疎なアテンションを交互に置き、計算量と品質のバランスを狙う。
下の画像は公開されたアーキテクチャの構成図で、層の並びと各ブロックの役割を視覚的に示している。
| 項目 | 値 |
|---|---|
| 総パラメータ | 125B |
| 活性化パラメータ | 6B |
| 語組み合わせ埋め込み | 51B |
| MTPパラメータ | 4B |
| 層数 | 48 |
| コンテキスト長 | 262,144トークン(拡張で1,000,000トークン) |
| ライセンス | Qwenコミュニティ版1.0 |
MoEは512個の専門家から10個のルーティングと1個の共有を活性化する仕組みである。N-gram埋め込みは20,000,000個の2語と3語の手がかりを2層目に置く。この埋め込みはMoEより計算が軽く、メモリ外へ退避しやすい点が挙げられている。MTPは1層で多段学習される補助的な仕組みで、推論の高速化に使えると説明されている。
隠れ次元は2560で、トークン埋め込みと出力は248320にパディングされている。QSAの予算は512ブロックまたは2048トークンに設定されている。Gated DeltaNetはV向けに48個、QK向けに16個の線形アテンション頭を持ち、頭次元は128である。QSAのQ頭は24個、KV頭は2個で、頭次元は256、回転位置埋め込み次元は64である。Gated Residualは4本の枝とボトルネック次元320を持つ。
Qwen4を見据えたアテンションと学習の工夫
このモデルは、Qwen4の基盤となるアーキテクチャの実験的プレビューとして位置づけられている。Qwenは、大規模言語モデルの主要部品が規模の拡大時にどう相互作用するかを根本から考え直す狙いを示す。
従来のGated Attentionは、Qwen Sparse Attentionに置き換わった。Gated DeltaNetはそのまま使われ、QSAと組み合わせる新しい形になる。QSAは個別トークンではなくマイクロブロック単位で選択する。
Gated Residualは、正規化を伴う残差接続に読み込みゲートと書き込みゲートを加える。データに応じて情報を調整し、層をまたいだ表現力を高めながら学習の安定と推論の低負荷を両立させる。
訓練ではMuonとAdamWを特定の重みカテゴリに分けて適用し、バッチサイズのウォームアップを省いて目標バッチから開始する。その結果、最適化ステップを減らしつつ大きな学習率で安定した収束を狙う設計になっている。
ベンチマークでは、エージェント型コーディングのDeepSWE 1.1では58.7を記録し、Qwen3.8-27Bの42.2を上回った。Qwen3.7-Plusの16.5とDeepSeek-V4-Flash-0731の54.4も上回る。数値はHugging Faceの公開ページにある表に基づく公式の比較として載っている。
Unslothが示す量子化精度と高速化
Unslothは2026年11月4日、ローカル推論向けにDynamic v3.1 GGUF版を公開した。GGUFはローカル実行向けのモデルファイル形式で、量子化によりメモリ使用量を抑えながら動かせる。同社はこの版について、他の最先端量子化より精度が15%高く、Terminal BenchやDeepSWEなどで最高得点を出したと主張する。
下の画像はUnslothが公開したDynamic v3.1のベンチマーク比較で、量子化版がどの評価で先行量子化を上回ったかを示している。画像では、複数の評価項目でDynamic v3.1が先行する量子化と並べられている。

同社はMTPをUnslothで利用すると推論が1.3倍から1.7倍速くなると説明する。実行にはllama.cpp、またはUnsloth Desktopを使う方法が案内されており、実行ガイドも用意されている。ローカルで試す人は、実行環境の対応状況とライセンス本文を個別に確認することができる。MTPのガイドも同社のドキュメントに置かれており、有効化の手順が案内されている。
Qwen4を見据えた実験的プレビューとライセンス
実験的プレビューとして公開されたFlash-Nextとは別に、Qwen3.8-Flashは本番向け機能を加えた公式版として示されている。この公式版は、既定で1Mコンテキストを扱い、公式の組み込みツールを持つとされる。Qwen3.8-Flash Overviewのページに、公式版の概要が置かれている。
Qwen Cloudは、インフラを維持せずに大規模推論を使うための公式APIサービスとして案内されている。自分のPCで動かさない場合の選択肢でもあるが、公開された重みとは別枠で案内されている。Hugging Faceのページには、vLLMやSGLang、TokenSpeedとの互換性も書かれている。公開された重みは、Hugging Face Transformers形式の重みと設定ファイルを含む。
ライセンス名はqwen-community-1.0で、詳細はLICENSEへのリンクから確認する。技術報告はGitHubのリポジトリに置かれ、ブログはqwen.aiに公開されている。Qwenは、このアーキテクチャの次の章を共に進めるとして、フィードバックを歓迎している。
出典
- Qwen/Qwen3.8-Flash-Next (image-text-to-text)(Hugging Face trending) · 議論
- unsloth/Qwen3.8-Flash-Next-GGUF (image-text-to-text)(Hugging Face trending) · 議論