ローカルAIニュース:llama-modchipが284Bモデルを64GB RAMでCPU動作
20秒でわかる今日のニュース
- llama-modchipが独自量子化で284Bモデルを64GB RAMで動作
- offline-aiがWindows無専用GPU向け推論セットアップ公開
- TokiRecurがKVキャッシュ再利用で推論速度を大幅向上
- nf12がBF16重みを12ビット圧縮しGPU推論を高速化
- DGX Spark Agent Stationが2台構成で748Bモデルを運用
独自量子化Fractal-64で284BモデルをCPUのみで動作
開発者のsynchopateは独自量子化Fractal-64を採用したCLIツールllama-modchipを公開した。この技術により284B規模のDeepSeek-V4-Flashモデルを64GB RAMのCPUのみで動作させることに成功している。圧縮後のモデルサイズは56.56 GiBとなり、256Kコンテキスト維持時でもVmRSSは57.61から58.9 GiBに収まる。
多段キャッシュタイルリングとレジスタ最適化を組み合わせることで、GPUなしでも44.36 tok/sのprefillと9.1から14.7 tok/sのデコード速度を達成している。また30B級MoEモデルでは16コアZen 5上で25.0から60.4 tok/sの生成速度を記録した。
./modchipコマンドでチャットやベンチマーク、量子化処理を一元管理できるため運用が簡素化されている。非標準のGGML_TYPE_Q2_0形式を採用しているため、公式llama.cppやOllamaではそのまま動作せず専用バイナリが必要となる。
コミュニティからはQ2_0における出力品質への関心が寄せられ、実測値の公開が待ち望まれている。一方で極端な量子化による出力劣化やREADMEの表記に関する指摘も確認されている。異なるCPUアーキテクチャ間の速度比較標準化は引き続き未確定の状態が続く。
Windows無専用GPU向け推論セットアップ公開
GitHubユーザーedrin09はWindows 11環境向けに専用GPUなしでMoEアーキテクチャの30B規模コードモデルを動作させるセットアップリポジトリoffline-aiを公開した。推論エンジンにはik_llama.cppを採用し、公式llama.cppと比較して2から3倍の高速化を実現している。
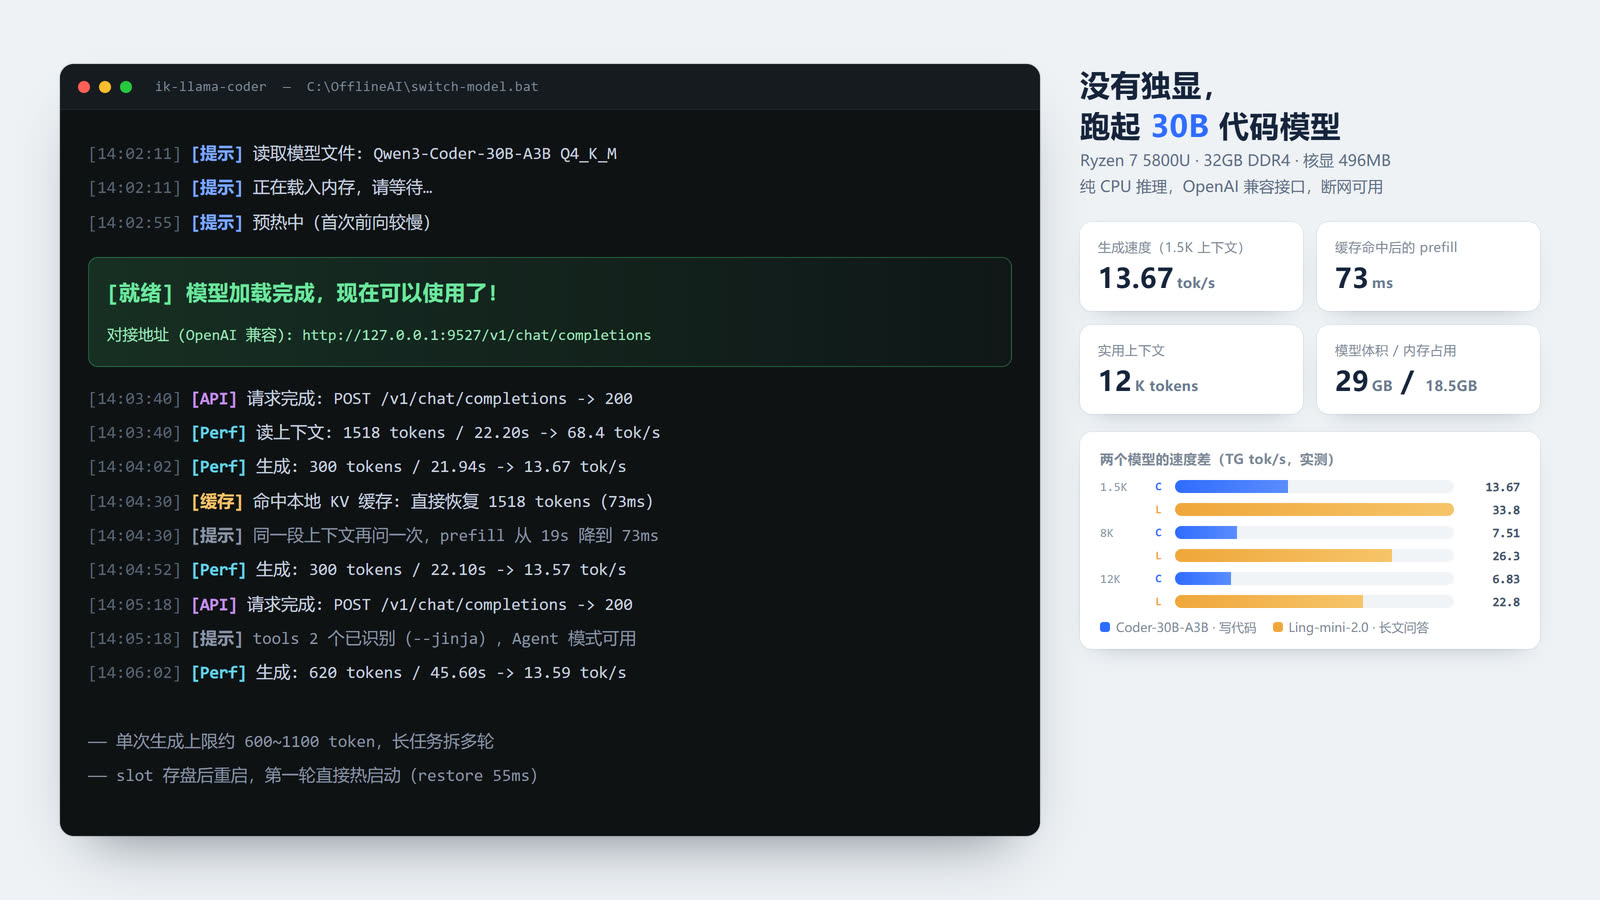
実機テストではRyzen 7 5800Uと32GB RAMのノートPCで13.67 tok/sの生成速度を達成した。プロンプトキャッシュを活用すれば二次質問時のprefill処理が19秒から73msに短縮され、計算の99.6%を省略できる。
実用的なコンテキスト長は12K tokenに設定されており、15Kを超えるとメモリページ回収が発生して速度が急落する。クラウドAPI利用費用は月額¥0であり、電気代のみで長期運用が可能である。
単一インスタンスの直列処理となるため複数ユーザーの同時利用には不向きだが、コード不出機環境でのローカル推論実用化を具体化した事例となっている。
TokiRecurがKVキャッシュ再利用で推論速度を大幅向上
Luke Hadzicはllama-serverのフロントエンドとして動作するLLMランチャーTokiRecurを公開した。プロンプトの正確なプレフィックス一致によりKVキャッシュを再利用し、推論速度を大幅向上させる仕組みを採用している。
ベンチマークでは9つのワークロードと4つのモデルでTTFTが62から96%、prefillスループットが410から1280%改善した。最大規模のMoEモデルほど推論効果が高まっている。
キャッシュはメモリ上で動作しており、ディスク永続化は精度劣化により削除されている。LinuxとmacOSは安定版、Windowsはベータ段階でリアルハードウェア検証中である。
キャッシュヒット判定には最低10トークンの再利用が必要であり、システムプロンプトの先頭1トークンが変化するとプレフィックスが無効化される。MITライセンスで公開されており、285以上のユニットテストとCI環境を備えている。
出典:Hacker News
NF12がBF16重みを12ビット圧縮しGPU推論を高速化
Together AIの研究者らとGitHubユーザーdphnAIはBF16形式のLLM重みを無損圧縮するライブラリnf12を公開した。AmpereからBlackwell世代のNVIDIA GPUで動作する12ビット固定長エンコーディングを採用している。
メモリ削減量に比例して推論速度が向上するベンチマークが公開されている。Qwen3-8Bのメモリ使用量は15.27 GiBから11.49 GiBへ、Qwen3-30B-A3Bは56.88 GiBから42.80 GiBへ削減された。
NF12層のレイテンシはH200で23.2µs、B200で18.9µsをそれぞれ記録した。いずれも従来パスと比較して1.37倍と1.48倍の高速化を示す結果となった。
圧縮前のBF16重みと復元値は一致するが、GEMM出力の順序差によりprefill結果は多少異なる。Greedy出力の差異はモデル正確性の結果ではないとされている。
出典:Hacker News
2台構成DGX Sparkで748Bモデルをエージェント運用
Tiggy-Chanは748BパラメータのDeepSeek-V4.1-Flashモデルを2台のNVIDIA DGX Sparkで高速推論するTurnkeyキットDGX Spark Agent Stationを公開した。2台のGB10で構成され、256GBの統一メモリを共有する仕様である。
Claude CodeやCursor向けに最適化され、1Mトークンコンテキストでキャッシュを活用したマルチターン推論が1.2秒で完了した。5.3倍の高速化を実現した結果となっている。
コード生成では104.1 tok/s、複雑な推論では78.7 tok/sをそれぞれ記録した。データセンター向けSM100の制約を回避するため、GB10向けにZig 0.17.0とCUDA 13.0でカスタムカーネルをコンパイルしている。
内部推論トークンを2048に制限するTHINKING_BUDGET機能も組み込まれている。EXL3 2.9bpw量子化されたアンセンサードモデルとEngram条件テーブルをデプロイする仕様である。
出典
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU(Hacker News) · 議論
- edrin09/offline-ai: 无独显笔记本跑 30B 代码模型:ik_llama.cpp + MoE 量化,纯 CPU 13.67 tok/s,OpenAI 兼容、断网可用、零 API 费用 | CPU-only local LLM on Windows, no GPU needed(GitHub topic local-llm)
- TokiRecur – llama.cpp LLM launcher with KV-cache recycling(Hacker News) · 議論
- Lossless compression of LLMs to 12-bits(Hacker News) · 議論
- Tiggy-Chan/dgx-spark-agent-station: Turnkey DeepSeek-V4.1-Flash (748B, Uncensored) & Claude Code Agent Station on Dual NVIDIA DGX Sparks (2x GB10)(GitHub topic llm-inference)