Linux向け完全ローカル音声AIアシスタントUltronが公開
30秒でわかる内容解説
開発者Nitin YadavがGitHubにLinux向け100%ローカル音声AIアシスタントUltronを公開した。NVIDIA GTX 1650などのコンシューマーGPUで動作し、画面認識とブラウザ操作を統合する。クラウド依存の音声ラッパーと違い、マイク入力からテキスト読み上げまで全工程をPC内で完結させるため、ネットワーク環境を選ばずにプライバシーを守りながらデスクトップを音声で制御できる。655件の自動テストに合格している安定性も魅力だ。
全工程をローカルで完結する音声パイプライン
Ultronは2026年11月9日にGitHubで公開されたシステムエンジニアリングプロジェクトである。開発はPhase 10で一旦停止しているが、655件の自動テストに合格している。 音声パイプラインはDynamic AGC GuardとSilero VADを備え、マイク入力のノイズフロアを自動適応させる。
Ultron is an active, ongoing systems-engineering project and is NOT yet a finished consumer release.
Ultronは活発なシステムエンジニアリングプロジェクトであり、完成した消費者向けリリースではない。
音声認識にはfaster-whisperのsmall.enモデルを採用し、CPUのint8量子化で動作させる。言語モデルはLFM3-1.7B-Q6_K.ggufをllama.cppのサーバー経由でGPUオフロードして実行する。画面認識機能は3層の構造になっており、GNOME ShellのWayland D-Bus経由でウィンドウ情報を取得する。
AT-SPI2のアクセシビリティツリーでUI要素をマッピングするため、複雑な画面レイアウトでも正確な認識が可能だ。ブラウザのDOM同期にはBraveやFirefox用のWebExtension Bridgeを利用する。デスクトップ操作はydotoolでキーボードとポインタを合成し、wl-copyでクリップボードを即時書き換える。
音声再生時には4層のエコー保護が働き、Piper TTSの再生中にハードウェアマイクをミュートする。再生終了後350ミリ秒待ってから解除するため、周囲の環境音が誤検知されることを防ぐ。この間、550ミリ秒分のバッファをフラッシュするため、自身の声が入ることを防いでいる。
visionOS風の空間UIとFedora Wayland環境
操作インターフェースはApple visionOSを意識したGlassy Dashboard V18だ。ローカルサーバーのポート9932にアクセスすると、半透明のガラス風ウィンドウが表示される。左側にナビゲーションレールを配置し、中央にステータスやグラフを並べる。
右側には音声波形やGPU VRAMの使用量を示すパネルを常駐させる。動作環境はFedora WorkstationのGNOME Waylandを前提としている。システム要件ではNVIDIA GTX 1650の4GB VRAMと16GB RAMで動作確認が済んでいる。
インストールにはPython 3.14の仮想環境を構築し、at-spi2-coreやydotoolなどの依存パッケージをインストールする必要がある。写真では半透明のウィンドウが複数重なる空間UIが確認でき、 視覚的に情報を整理しやすいレイアウトになっている。ウィンドウのインタンスはgnome-shellのintrospect設定を有効にすることでWaylandのUIツリーを取得可能にする。
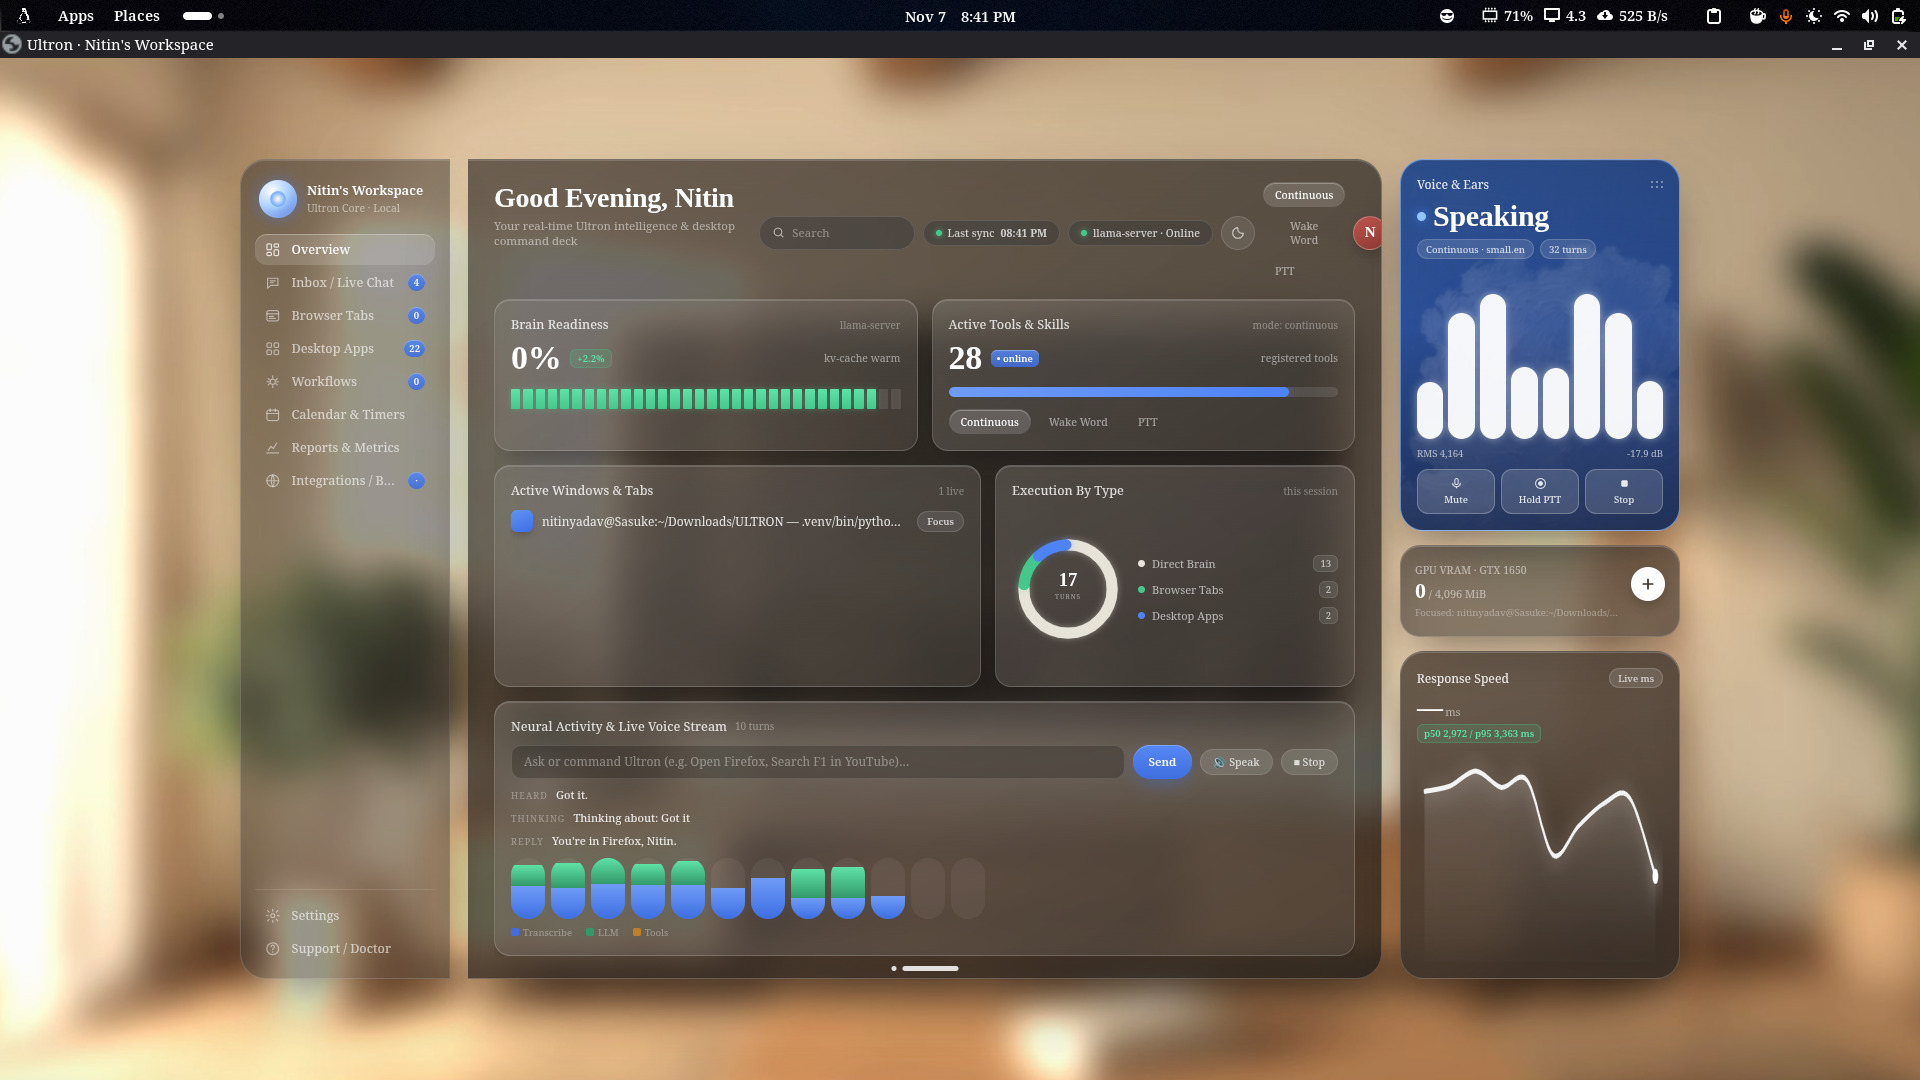
uinputデバイスへの権限付与により、一般ユーザー権限でキー入力とマウス操作をエミュレートできる。
ベンチマーク合格とブラウザ連携の実装
公開直後はコミュニティからのコメントは確認できていないが、25コマンドの自動ルーティングベンチマークでは25/25の成功を記録している。ターミナルからはlistenモードでハンズフリーの音声リスナーを起動でき、chatモードで対話形式のチャットも可能だ。ブラウザ内検索機能は既存のタブを操作する方式を採用している。
Ctrl+Lでアドレスバーへ移動後、wl-copyで検索クエリを貼り付けEnterキーを押すことでGoogleやYouTubeの検索結果へ遷移する。WhatsAppやGmailなどのWebアプリでもDOM要素の同期が機能するため、Webブラウザ上で完結するタスクを音声で進められる。開発者は現在、Personal LoRA Fine-Tuningの計画を進めている。
ユーザーが修正したheard, did, wantedのログをultron_finetune_chatml.jsonlとして出力し、UnslothやTRLを用いてカスタムGGUFモデルを構築する予定だ。
深層画面理解と長期記憶エンジンの実装予定
Phase 10以降の開発再開時にはリアルタイムマイク調整と深層画面理解の実装が予定されている。現在のread_screenはウィンドウやタブのメタデータに依存するが、ビジョン支援のグラウンディングにより複雑なWebアプリを操作できる仕組みへ拡張される。長期記憶エンジンにはSQLiteのWALモードを採用する設計で、セッションやイベント、事実、エンティティを記録する。
FTS5による全文検索を可能にするため、過去の会話内容からキーワードを即座に引き出せる。Lettaスタイルの睡眠時統合機能により、メモリ内の情報を定期的に圧縮・整理する。ソース取り込みパイプラインではWhatsApp WebやGmailのタブ、YouTubeの字幕、ローカルのドキュメントフォルダを自動でインポートする。
出所を追跡しながら会話履歴に統合する機能も実装スケジュールに含まれている。
用語の注釈
- GGUF
- llama.cppで使用されるモデルファイル形式で、量子化により低スペックPCでも大規模モデルを高速に動作させる。(参考:GGUF量子化ってなんだ?〜ローカルLLMを爆速で動かすための ...)
- LoRA
- 大規模言語モデルの重みを固定し、小さな追加行列のみを更新して低負荷でカスタマイズする軽量化ファインチューニング手法。(参考:【徹底解説】LoRAとは?仕組みや作り方まで完全ガイド | AI導入 ...)
- VAD
- 音声の開始・終了を検出し、ほぼ全ての音声AIシステムの最初のステップとして機能する処理。(参考:[AI基礎解説]VAD(Voice Activity Detection)ってなんだ ...)