100MパラメータのトランスフォーマーがARC-AGI 2で37.08%を達成
25秒でわかる内容解説
著者Vakdeが公開した自己回帰型トランスフォーマーmdlARC第3版は、外部テキストや大規模言語モデルを使わずにARCパズルのみで学習し、ARC-AGI 2コンペティションで37.08%のスコアを記録した。パラメータ数は約100Mに抑えられ、前年優勝の4B QwenモデルやLLMフリーの次点記録を大きく引き離す。中間層をループさせる設計で計算コストを抑えつつ推論精度を向上させた。
ループ構造による計算深さの拡張
mdlARCはARCパズルの入力グリッドと出力グリッドのペアを文脈として読み込み、テスト用の入力に対して出力セルを1つずつ生成する自己回帰型(autoregressive)のアーキテクチャを採用している。Vakdeは2026年11月11日付のブログ記事で、第3版の最終提出物がKaggleの公開リーダーボードで37.08%を達成したと明かした。
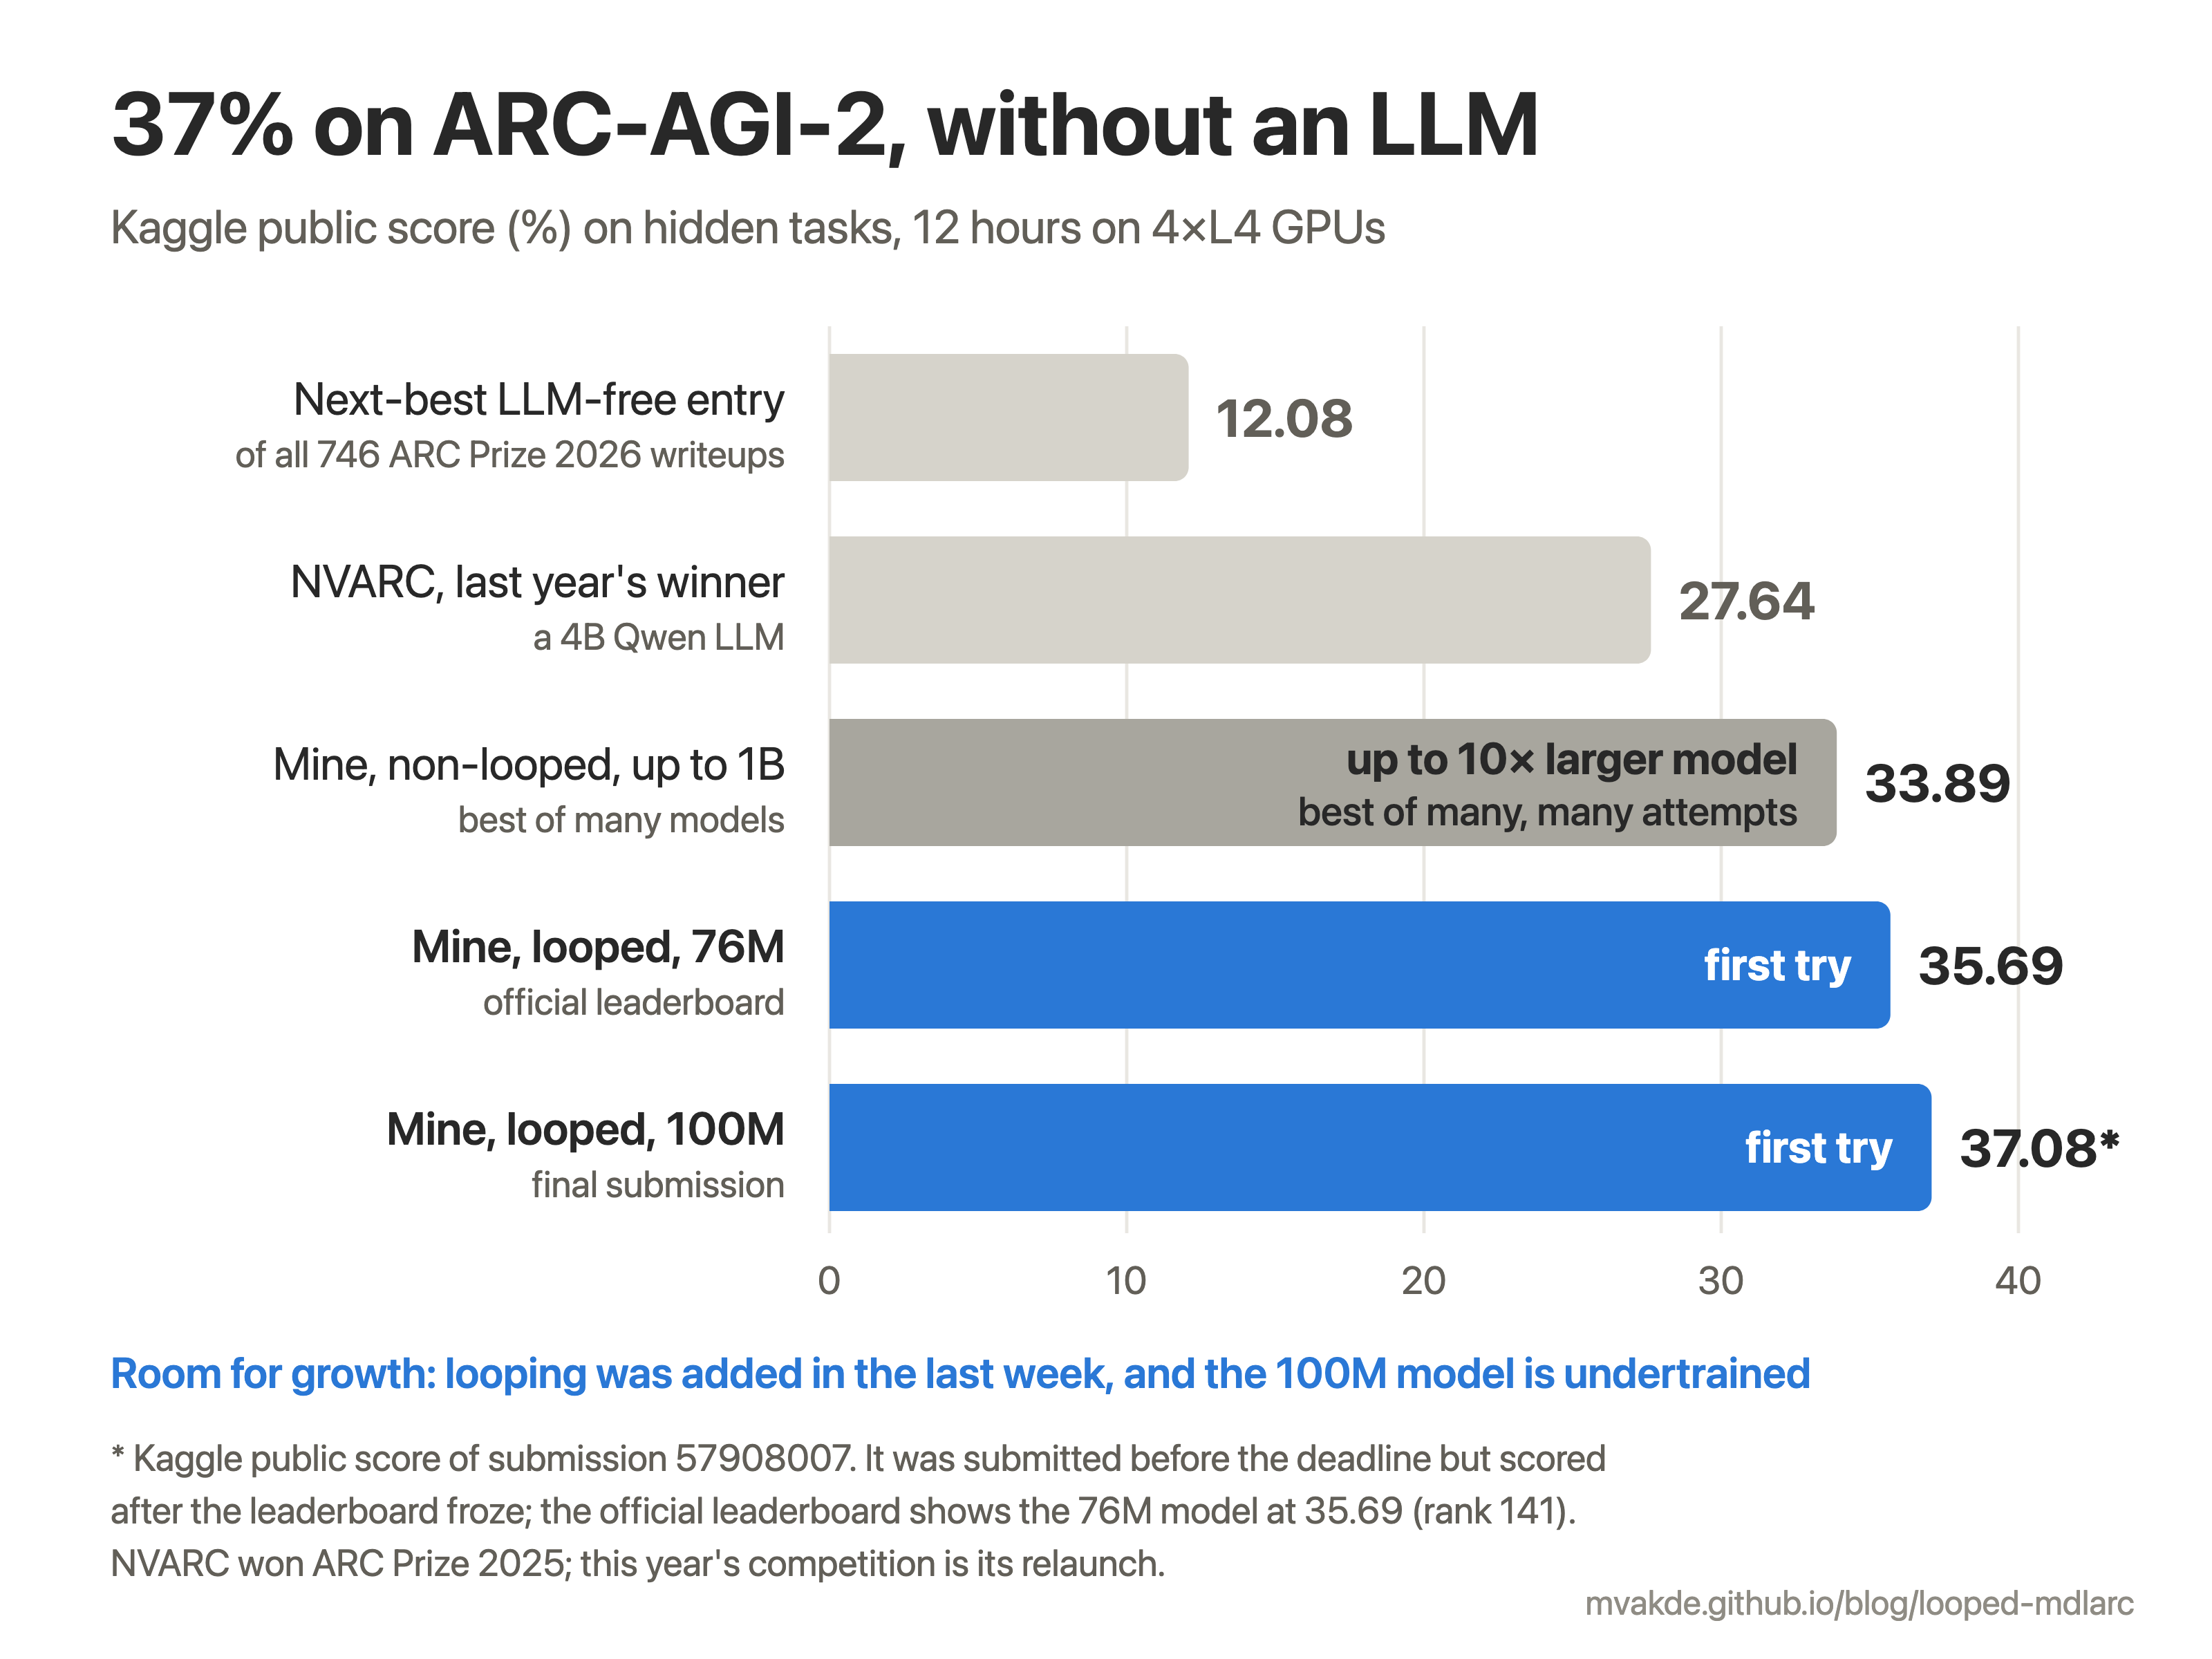
このスコアはARC-AGI 2の非公開評価セットに基づいて算出されたもので、提出期限後にスコアが確定したため公式記録では35.69%として表示されている。
同モデルは約100Mパラメータという小型設計でありながら、ARC Prize 2026の全746エントリーの中でLLMを使用しないモデルの最高記録を更新した。次に高いLLMフリーのスコアは12.08%であり、mdlARCはこれを約3倍に引き上げた。前年の優勝者であるNVARCが生成パズルで微調整した4B Qwenモデルの27.64%をも上回る結果となった。
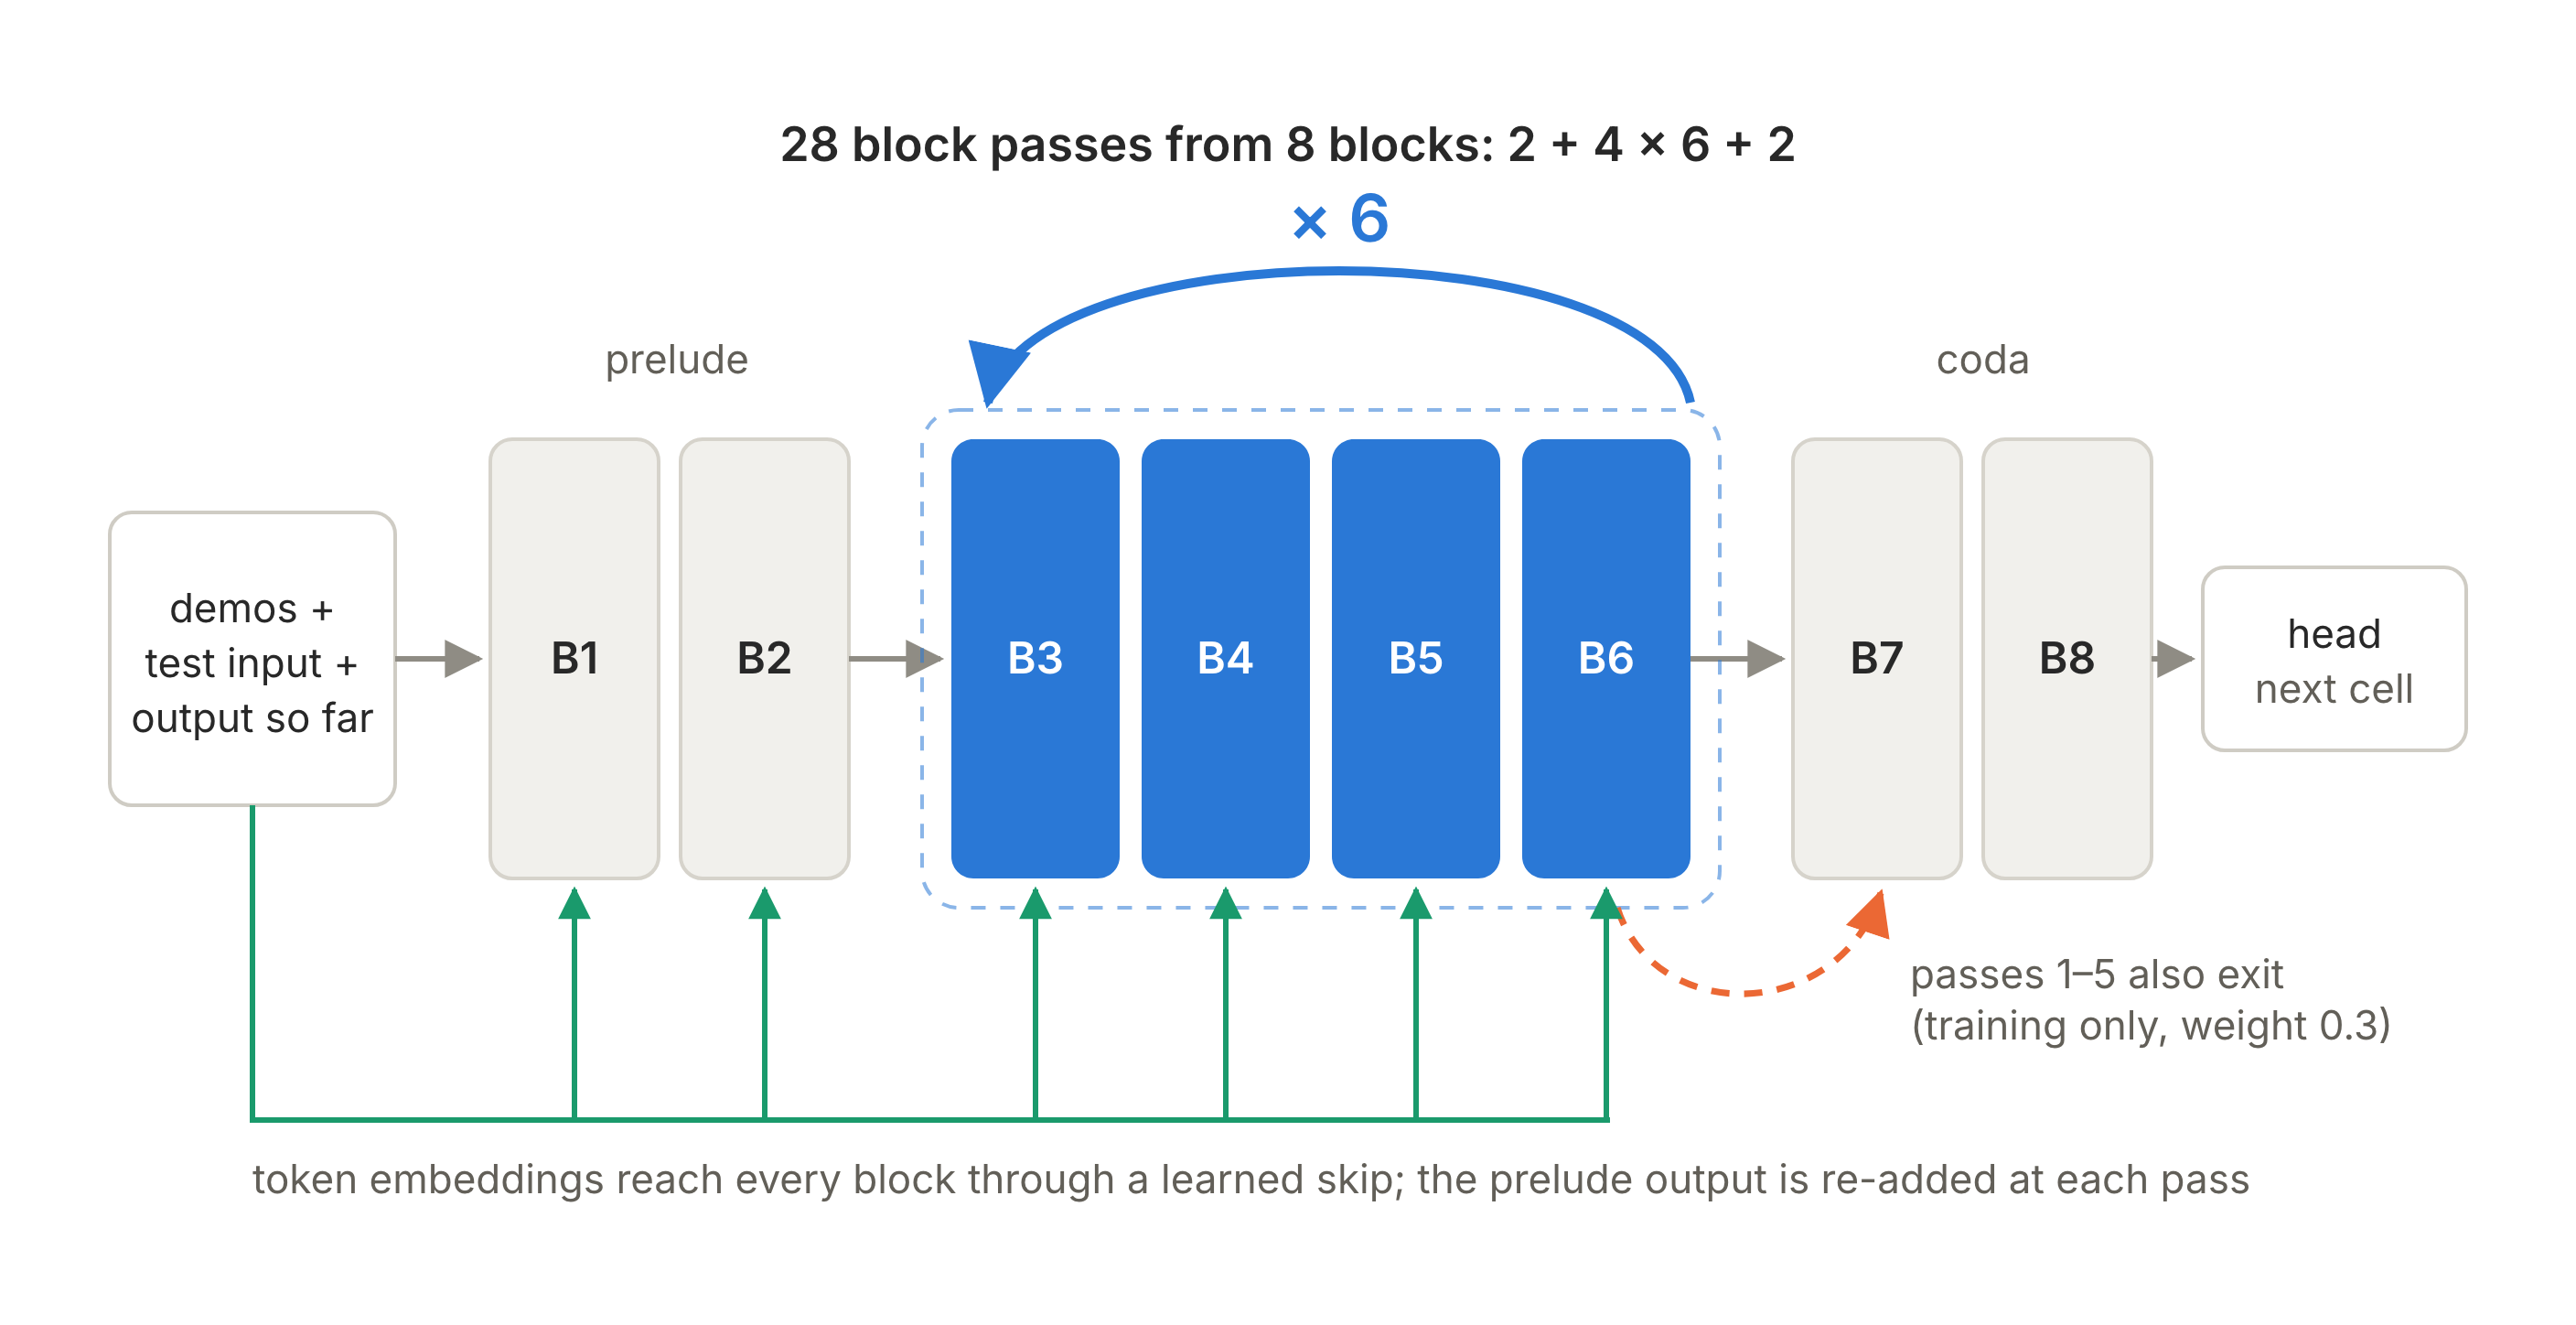
性能向上の主要因は、中間の4層を6回ループさせる構造にあり、パラメータ数を増やさずに推論時の層の深さを28段に拡張してスコアを最大約19ポイント改善させた。このループ処理は、出力グリッド全体を修正する従来の手法とは異なり、次に生成するセルの内部状態を逐次洗練させる方式で動作する。1Mパラメータのループモデルも、以前の76Mモデルを上回る49.00%を記録している。写真では8ブロックから28回の処理パスを構築するループ構造が示されている。
最小記述長原理に基づく設計思想
大規模言語モデルがARCデータセットを大量に学習している現状において、サンプル効率を測る目的で外部テキストを排除した。モデルは最小記述長原理(MDL)に基づき、自身のサイズとデータ説明に必要なビットの合計が最小になるように設計された。ループを用いることで、独自の層を追加せずに計算深さを稼げるため、データが限られる環境ではパラメータ数の削減が汎化性能に直結する。
以前の実装ではタスクごとに学習可能な埋め込みベクトルを追加していた。第3版ではパズルを1つのシーケンスにまとめ、タスク固有のパラメータを削除した。これにより、モデルは各パズルのルールを提示例から直接読み取る必要が生じ、ループによる精度向上効果が約半分になることを確認した。
推論時の計算負荷を軽減するため、ハブ・アンド・スポーク注意機構(sparse attention variant)を採用した。各提示ペアがハブとなるテスト入力にのみ注意を向け、テスト入力がすべての提示ペアを参照する構造だ。これにより提示ペアの数が増えても計算コストが線形に増加し、4枚のL4 GPUを搭載したKaggleの制限環境で12時間以内の推論を可能にした。
3次元の回転位置エンコーディング(3D RoPE)を用いて行列の位置関係を明示し、深層監督によって各ループで中間出力を評価する仕組みも組み込まれている。
コミュニティの評価とスコア比較
技術コミュニティではHacker Newsで詳細なレビューが進んでいる。Vakdeはループ回数が6回で頭打ちになる理由や、シード変更による約4点の結果ばらつきについて未解明としている。ベースラインとなる非ループモデルのチューニング時間が不足していたため、公平な比較は今後行う予定だ。
学習コストの安さも技術コミュニティの関心を集めている。ARC-AGI 1の公開評価セットで70%前後のスコアを達成するオフライン学習は、約3.7 H200時間で済んだ。
Because I care about sample efficiency, and LLMs are trained on so much data, (including ARC puzzles), that it can't be measured.
サンプル効率を重視しており、大規模言語モデルはARCパズルを含む大量のデータで学習するため、その効果が測定できないからだ。
既存のLLMフリー手法が別パズルごとの埋め込みテーブルを保持するのに対し、mdlARCは純粋な重みだけで動作する。
Looping gives extraordinary gains.
ループ処理は並外れた精度向上をもたらす。
19MパラメータのループモデルはARC-AGI 1で70.25%、RE-ARCデータを加えると81.38%を記録した。これはTRMやHRMと同様の評価条件で、最大4倍のパラメータ数を持つ独自層モデルを2.3から7.6ポイント上回る。
| モデル | パラメータ数 | ARC-AGI 2スコア |
|---|---|---|
| mdlARC v3 | 約100M | 37.08% |
| NVARC Qwen | 4B | 27.64% |
| LLMフリー次点 | — | 12.08% |
Kaggleの公開グラフでは、LLMフリーエントリーのスコア分布が明確に示されている。mdlARCが最上位に位置し、その下のスコアとの差が一目で確認できる。
新ベンチマークと今後の最適化予定
著者はループ処理の仕組みがARC固有のものではないと指摘し、他のドメインへの適用も視野に入れている。今後はARC Data Squeezeという新ベンチマークを立ち上げ、チューニング済みのベースラインモデルとの比較を本格化する。このベンチマークでは評価セットの提示例を学習データとして使用し、タスク固有の埋め込みベクトルを追加できるルールを採用している。
今後の課題としては、正解が生成されているにもかかわらず最終回答として選択されないケースが9から14ポイントの差を生んでいる点だ。マルチトークンヘッドを用いた推測推論やスケール拡張を組み合わせることで、さらにスコアを伸ばす余地がある。
最終的な最適化とスコア更新は2026年11月中に完了する予定だ。
出典
- 37% on ARC-AGI 2 without an LLM(Hacker News) · 議論