llama.cpp v1.0リリースとRTX 30シリーズ環境での推論速度変化
25秒でわかる内容解説
ggml-orgが2026年11月13日にllama.cppのバージョン1.0を正式リリースした。このアップデートはRTX 30シリーズ以降のNVIDIA GPUを搭載する自作PC環境において、並列リクエスト処理やスペキュラティブデコーディングの速度を最大55%向上させる。単一リクエストでの推論速度は従来どおりだが、複数のクライアントから同時にアクセスする自宅サーバーや、大規模モデルを利用する愛好家にとって実用的な改善となっている。
並列処理とスペキュラティブデコーディングの高速化
リリースされたv1.0.0はビルド番号12359に相当し、C言語ベースの推論エンジンとしての基盤を安定させた。最大の技術的変更は、RTX 30シリーズ以降のGPU向けに実装された新しいCUDAカーネルである。このカーネルは一度に2トークンから24トークンを並列で処理できるため、複数のリクエストを同時に実行する際のパフォーマンスが顕著に向上した。
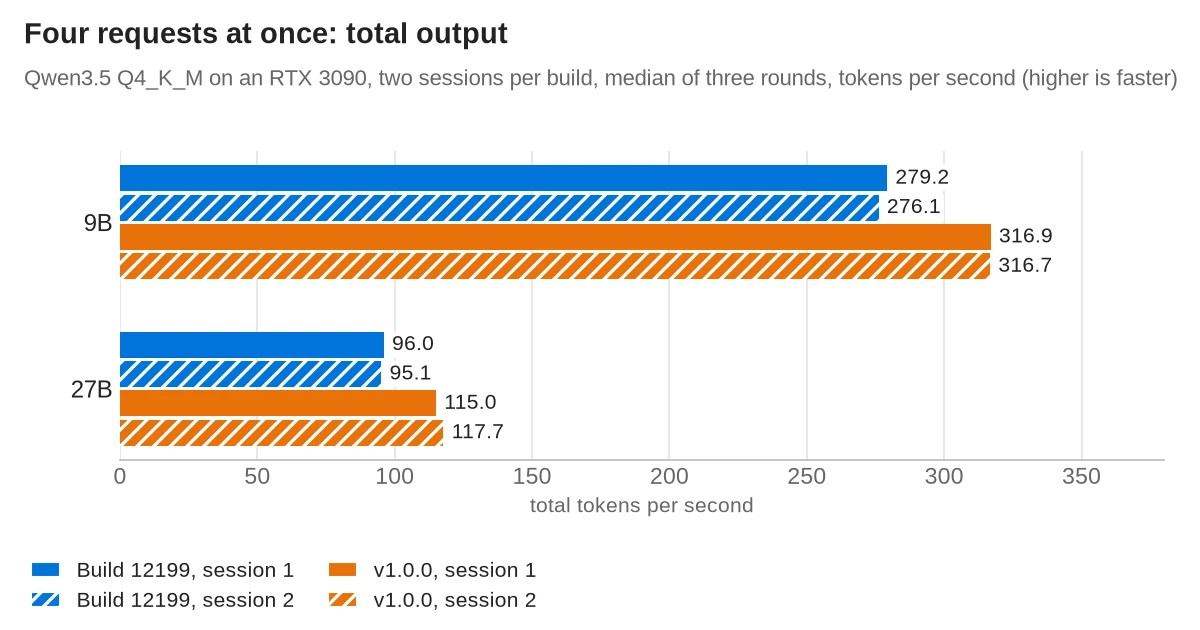
ベンチマークでは4つのリクエストを並行させた場合、9Bモデルで毎秒14%、27Bモデルで毎秒22%のテキスト生成量が増加した。
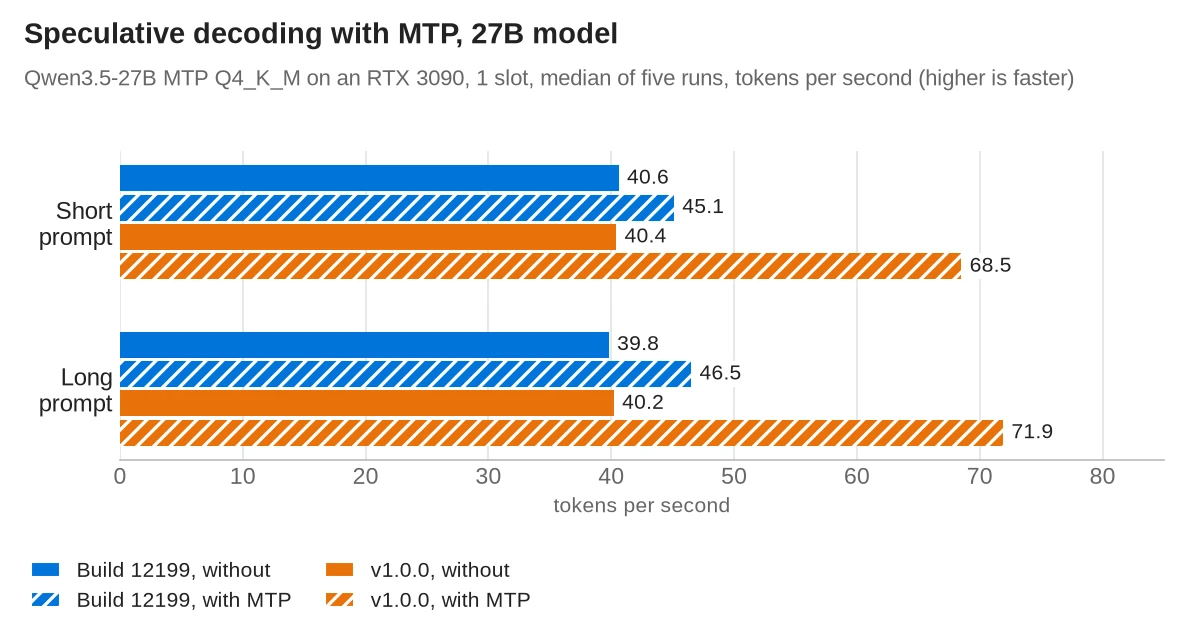
スペキュラティブデコーディングとMTP(Multi-Token Prediction)を組み合わせると、その効果はさらに大きくなる。27BモデルでMTPの推論ヘッドを用いた場合、v1.0では毎秒68.5トークンを生成し、旧ビルドの45.1トークンから52%高速化した。この速度差は、新しいカーネルが複数のトークンを一度にチェックする処理に最適化されているためである。
一方で、単一リクエストのみで推論を実行する場合やCPUのみの環境では、速度に有意な差は見られなかった。
テスト環境では短めのプロンプトで512トークンを生成し、長いプロンプトでは4,120トークンを入力して256トークンを生成した。温度を0に固定して最確のトークンを生成させた。単一リクエスト時の9Bモデルは毎秒116.0トークン、27Bモデルは毎秒38.7トークンを記録し、旧ビルドと2%以内の誤差範囲に収まった。
GPUメモリ使用量はデフォルト設定で13,932 MiBと変化がないため、既存の環境でアップデートしてもモデルがメモリ不足になる心配は少ない。写真では4リクエスト同時実行時の合計出力速度比較グラフが示されている。
MTPの有無による27Bモデルの推論速度変化グラフが写真に示されている。
セマンティックバージョニングとネットワークセキュリティの強化
バージョン管理はセマンティックバージョニングに移行し、APIやABIの破壊的変更があればメジャーバージョンが上がるようになった。これにより、llama.cppを基盤とするアプリケーションの開発者は、更新時の互換性を明確に判断できる。具体的な設定変更として、起動コマンドからdefrag-tholdフラグを削除する必要がある。
また、ネットワーク上のllama-serverはデフォルトでAPIキーが必須となり、外部アドレスからツールやMCPサーバーを呼び出す場合、キーの指定を忘れると起動に失敗する。
「今後、llama.cppとggmlは、APIおよびABIの互換性切れをメジャーバージョンの上げ下げで反映する」
内部メモリ管理の面では、コンテキストキャッシュにFP8形式を選択できるオプションが追加された。これにより、混合Expertsモデルのメモリ効率が改善される。また、画像やメディアのリンクでプライベートアドレスを指定する際はmedia-allow-private-urlsフラグが必要になった。これらの変更は、自宅サーバーを外部公開する際にセキュリティを強化する意図がある。
| 区分 | ビルド番号 | 備考 |
|---|---|---|
| 旧ビルド | 12199 | 0.9.0-dev相当 |
| v1.0 | 12359 | 正式リリース |
| Ollama最新 | 12177 | 0.40.16に使用 |
| Ollamaプレリリース | 12257 | 0.40.17に使用 |
ベンチマーク条件と既存ツールへの反映状況
公開されたベンチマークはFedora 44とDocker環境でRTX 3090を用いて計測され、Qwen3.5モデルの量子化ファイル(Q4_K_M)を比較対象とした。テストスクリプトはGPUが50度に冷却されるまで待機し、各数値は五回の実行中央値を採用している。実行セッションごとの若干の速度変動は許容範囲として扱われており、新旧ビルドが交互に実行された同一セッションでの比較が採用されている。
既存のツールチェーンへの反映状況は明確ではない。Ollamaの最新リリース0.40.16はビルド12177を使用しており、プレリリースの0.40.17も12257にとどまる。両方ともv1.0の12359より古いため、並列処理の高速化やスペキュラティブデコーディングの恩恵は、Ollamaが新しいビルドに切り替えて初めて適用される。LM Studioが現在使用しているエンジンバージョンは公式 changelog から特定できていない。
アップデート手順と今後の適用予定
アップグレードはDockerイメージの再取得やHomebrew、Wingetのコマンド実行で容易に行える。更新後は起動コマンドからdefrag-tholdを削除し、ネットワーク公開時はAPIキーを設定する必要がある。RTX 30シリーズ以降のNVIDIA GPUを搭載し、複数クライアントからのアクセスや大規模モデルのスペキュラティブデコーディングを利用するユーザーは、直ちに更新が推奨される。
単一ユーザーで推論を実行する環境や、AMD GPU、Apple Silicon、CPUのみのサーバーでは速度変化が確認できていないため、都合の良い時期にアップデートすればよい。CPU環境では9Bモデルで毎秒6.7トークンの生成速度を示し、長いプロンプトの読み込みには約50秒を要した。
Dockerイメージのタグにはserver-cuda-v1.0.0-b12359-b1b770dのような固定版も用意されており、ビルド番号の更新を止めたい場合に使用できる。
Ollamaがビルド12359以降に更新される時期は未定であり、LM Studioの対応ビルドも発表されていない。各ツールの公式リリースノートを確認しながら、環境に合わせた移行を進めることになる。
用語の注釈
- GGUF
- llama.cppで使われるモデルファイル形式であり、量子化された重みデータや実行に必要な情報を保存する。(参考:GGUF量子化ってなんだ?〜ローカルLLMを爆速で動かすための ...)