kllmでKaggle無料GPUからローカルPCにLLMAPIを構築する
35秒でわかる内容解説
開発者SANTHAN-KUMARが2026年11月18日に公開したPythonパッケージkllmは、ローカルGPUを持たないPCでもKaggleの無料GPU上でQwenなどの大規模言語モデルを動かし、ローカルでOpenAIやAnthropic互換APIとして利用できるようにする。55MBの軽量リレーが2基のTesla T4と通信し、12時間の制限を自動で継承する仕組みで長時間の推論を可能にする。自作のコーディングエージェントやIDEに簡単に組み込めるため、ローカル推論環境の構築が容易になる。週約30時間の無料枠を効率的に運用できる点も魅力だ。
ローカルPCとKaggleの連携仕組み
kllmはローカルPCに55MBのPythonリレープロセスを立ち上げ、Kaggleのノートブックと通信する。ユーザーはKaggleの認証トークンを渡すだけで、2基のTesla T4上でllama.cppがモデルを推論する。通信は暗号化されたトンネル経由で行われ、プロンプトはローカルから直接ノートブックへ送られる。
The relay holds the first request while the GPU starts, so the tool needs no retry logic.
リレーは最初の要求を保持するため、ツールのリトライ処理は不要である。
リレーは最初の要求を保持するためクライアント側でリトライ処理が不要になる。管理画面はブラウザで開き、Kaggleアカウントの登録からモデル選択、ツール接続、挨拶の4ステップで初期設定が完了する。
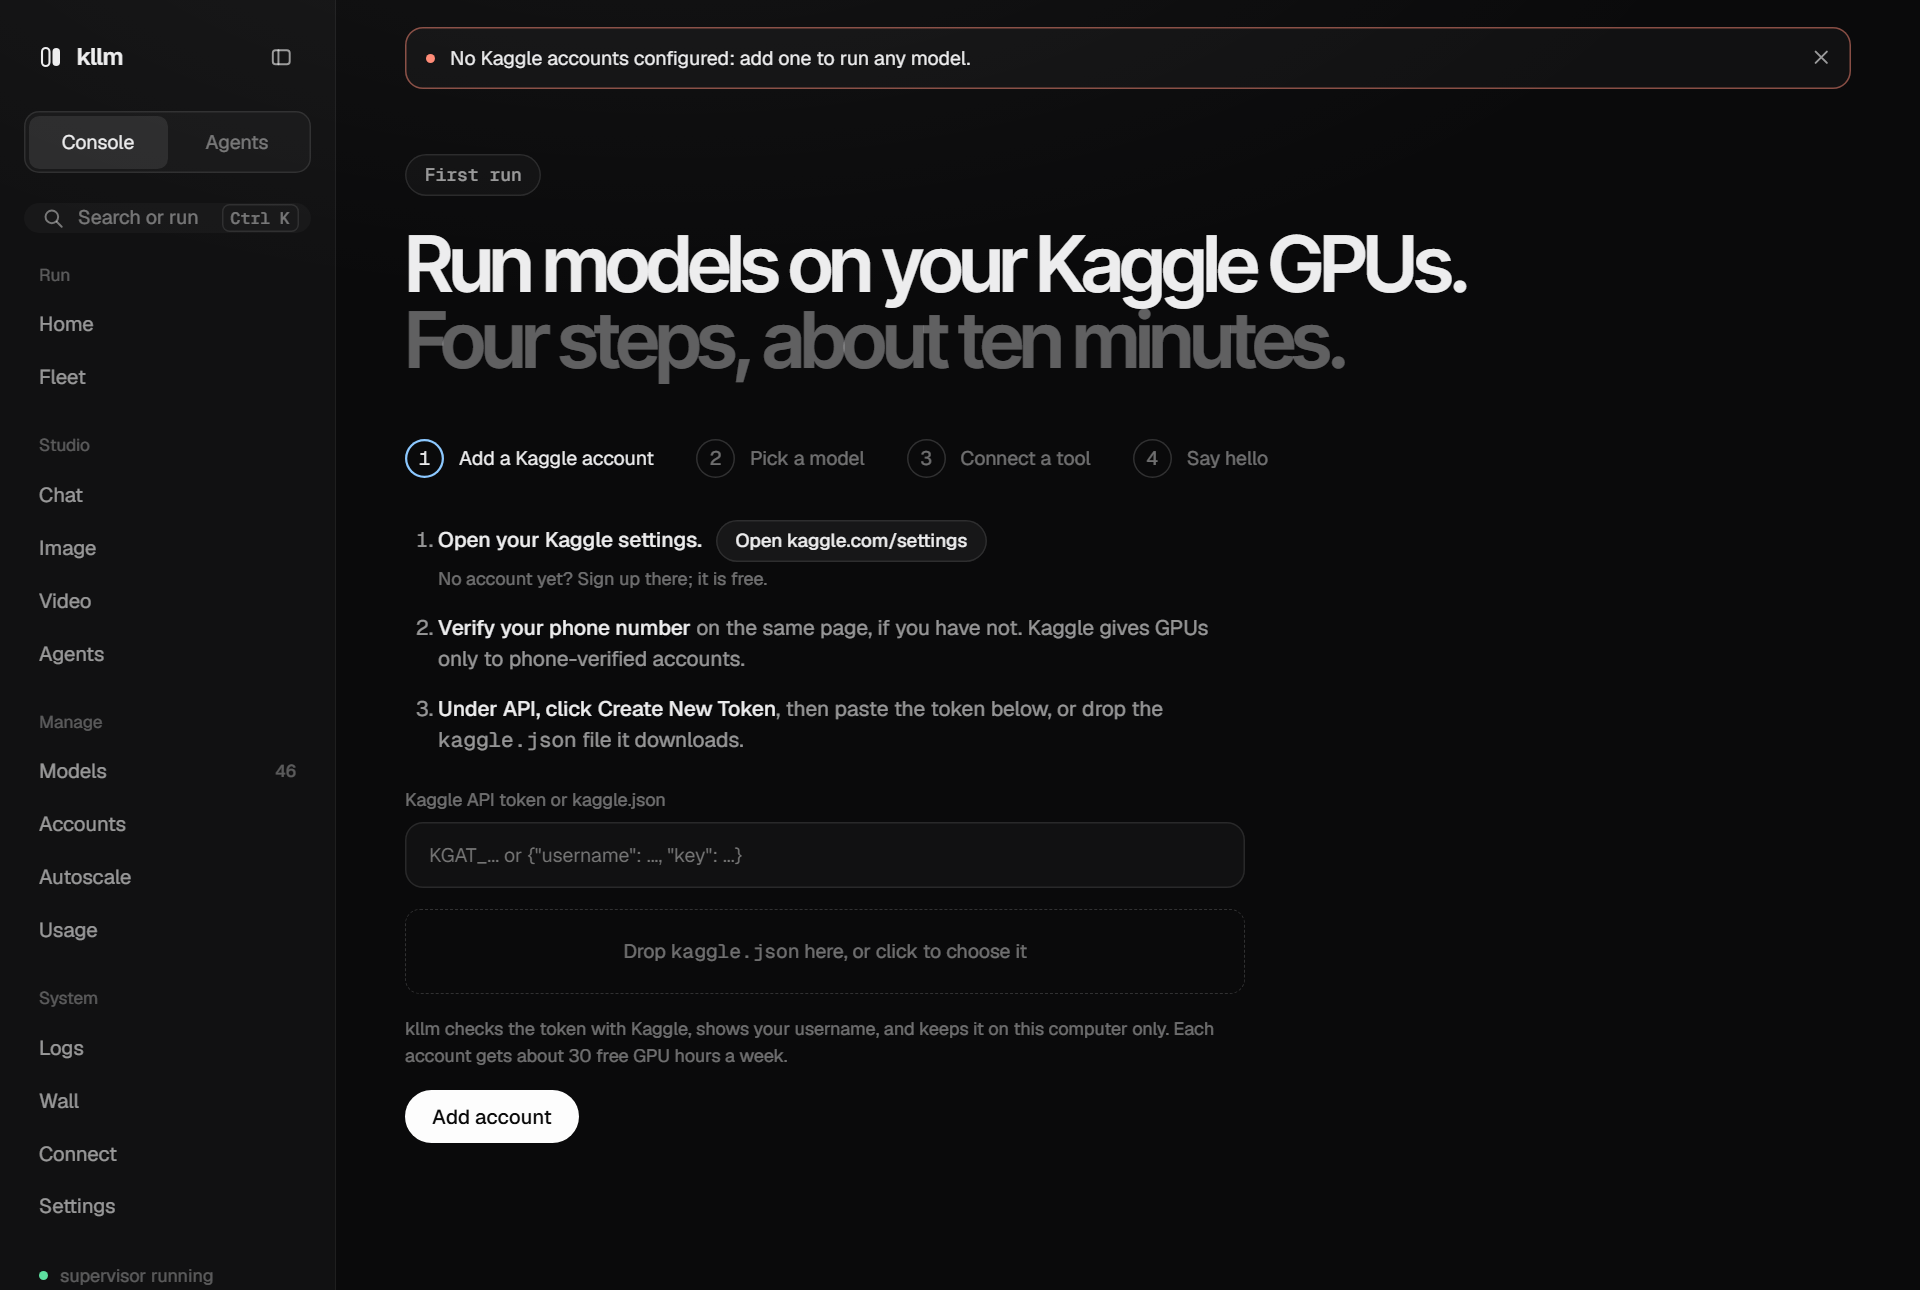
画面にはモデルライブラリやConnectページなどのタブが並び、設定を一元管理できる。初回起動時はモデルのダウンロードに約20GBが必要で8から10分待つが、2回目はキャッシュが効くため高速に起動する。12時間の制限が来る25分前には次世代ノートブックへ自動移行し、最新の対話を再生してキャッシュを温めた状態で接続を続ける。GPUは25分間リクエストがないと自動で停止し、週約30時間の無料枠を効率的に運用する。
管理パネルはローカル専用で、他のデバイスからのアクセスには設定画面に表示されるgateway keyが必要になる。ネットワーク内のクライアントや公開URLからも同じAPIを呼び出せるため、既存の開発環境へシームレスに統合できる。
対応モデルと推論速度の実測値
標準で採用されるQwen3.6-35b-abliteratedは安全フィルターを除去したMixture of Experts型モデルで、256Kのコンテキストに対応する。短文では70 tok/sを記録するが、209Kの長文コンテキストでは43 tok/sに低下する。
同様の処理を施したQwen3.8-27bは16から19 tok/sで高品質な回答を生成し、Qwen3-coder-30b-abliteratedは84 tok/sの高速なコード生成が可能である。
| モデル名 | 推論速度 | コンテキスト |
|---|---|---|
| Qwen3.6-35b-abliterated(安全フィルター除去版) | 70 tok/s(短文)/43 tok/s(209K) | 256K |
| Qwen3.8-27b | 16〜19 tok/s | 128K/256K |
| Qwen3-coder-30b-abliterated(安全フィルター除去版) | 84 tok/s(短文)/35 tok/s(84K) | 96K |
パネルには46モデルが登録され、Hugging FaceのGGUFやdiffusersリポジトリも追加できる。 一覧画面ではチャットや画像、動画モデルがフィルタリング可能で、各モデルのVRAM消費量とコンテキストサイズが事前に確認できる。ただし30GBを超えるVRAMを必要とするモデルは2基のT4では収まらない。
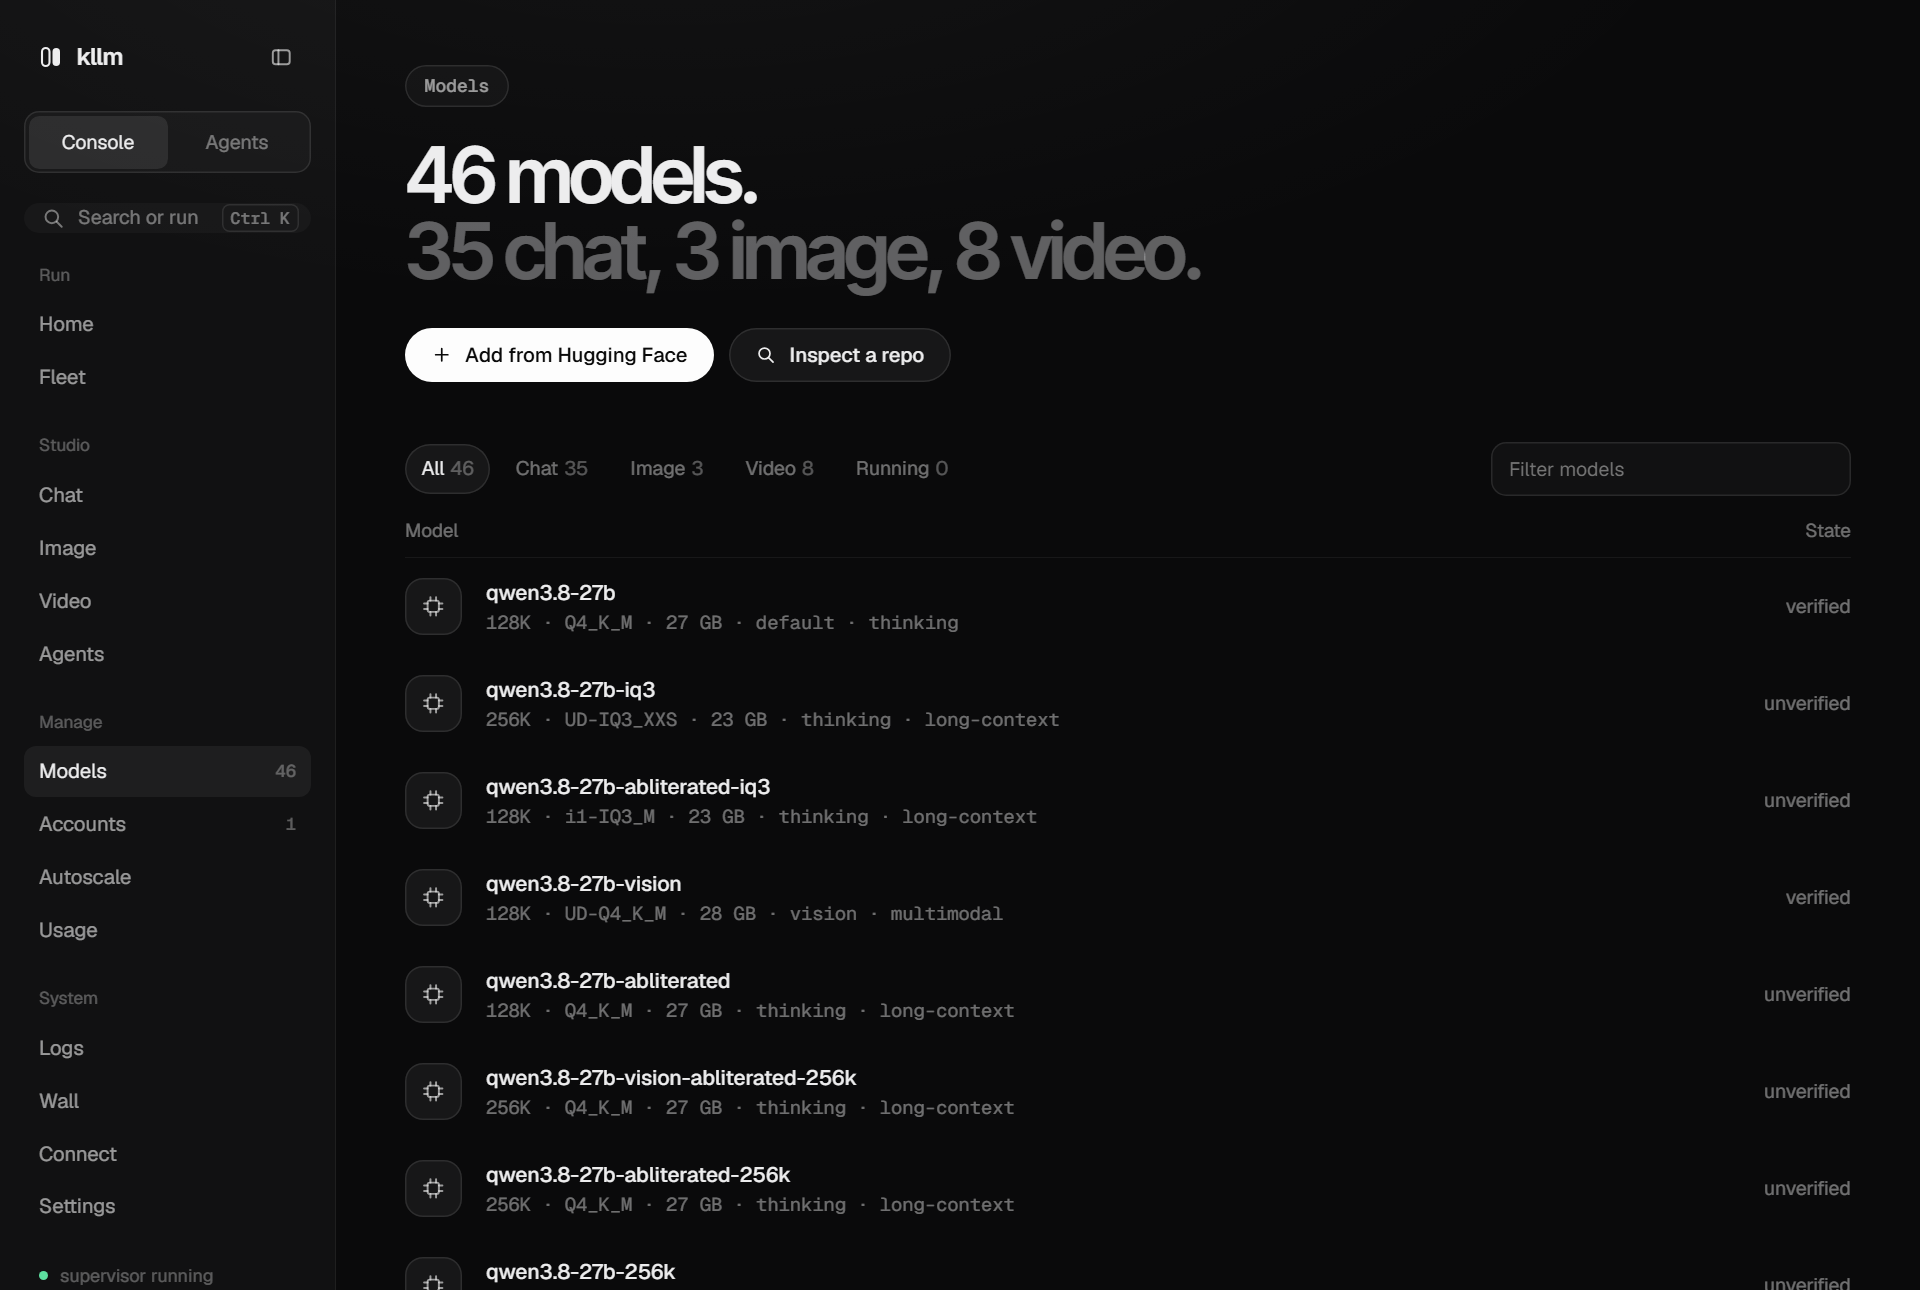
画像や動画モデルはサイズが適合しているものの、GPU上での実際の動作は未検証の状態である。開発者は実測ログを公開しており、6,889件のリクエストで成功率99.3%を記録した。3,109件のリクエストでは成功率99.9%を達成し、最大23万6千トークンまでコンテキストを拡張できる。
ベンチマーク値と実リクエスト値はモデルによって異なるため、用途に合わせて選択する必要がある。55Kトークンのコンテキストではプロンプトの99%がキャッシュから供給され、長文の連続対話でも速度の低下が抑えられる。
開発ログから見る実利用傾向
開発者の実測ログでは、2026年10月6日から11月16日の期間に1万5481件のリクエストが処理され、成功率は98.95%に達した。プロンプトトークンは750Mに達し、55Kトークンのコンテキストではプロンプトの99%がキャッシュから供給された。写真ではKaggleアカウント設定が4ステップで示される初期画面がある。
Kaggleアカウント設定が4ステップで示される初期画面の写真では、4ステップが示される。
複数のタブでリソースの状況を一元管理できる。
ガード機能は推論が暴走した際に自動で強制終了をかけるため、リソースの無駄遣いを防いでいる。一方でQwen3.6は些細なリクエストでも長時間の思考を行う傾向があり、品質に影響はないものの応答速度を数秒遅らせることがある。2,465件のリクエストは10万トークン以上の長文コンテキストを処理しており、システムは安定して稼働している。
ネットワーク経由で送信されるデータは暗号化と署名により保護され、第三者がURLを読み替えることもできない。セキュリティ面でも実用レベルの設計が施されており、長期運用における信頼性を担保している。
今後の検証予定と対応環境
公開から間もないためコミュニティの反応はまだ記録されていない。今後はHugging Faceからのモデル追加機能や、画像生成エンドポイントのGPU検証が進められる。28GB以上のVRAMを消費する大規模モデルや、230B規模のMiniMax-M2は現時点で非対応である。
開発者はテストを非接触で行う設計とし、ローカルのホームディレクトリや外部サービスへの依存を最小限に抑えている。MITライセンスで公開され、Python 3.10から3.13および主要OSに対応しているため、環境を選ばずに導入できる。
各ツールへの接続設定はパネルのConnectページが自動生成し、バックアップ機能付きでUndoも可能になる。ネットワーク内の他のデバイスや公開URLからもAPIを利用でき、gateway keyによるアクセス制限が設定できる。11月18日に公開されたkllmは、ローカルGPUの制約を超えた推論環境として11月下旬以降の利用者が拡大すると見られる。
インストールはcurlやpipxのいずれかのコマンド一発で完了し、uvがPython環境を自動で提供する。ノートブックの早期停止時にも同じ継承処理が実行され、最大17万5千トークンのコンテキストでも50から63 tok/sの生成を維持できる。
用語の注釈
- abliterated
- 安全フィルター(SFT)を除去して無検閲化されたLLM。(参考:Abliteratedモデルとは?無検閲LLMの仕組みと注意点 | Private ...)