NVIDIA GeForce RTX 20 30 40 シリーズ GPU 計算性能をmodsで2倍に解放
30秒でわかる内容解説
自作PCユーザー向けにGPUの計算性能を向上させるmodsが登場した。NVIDIAのGeForce RTX 20 30 40シリーズがファームウェア制限を解除され、FP16やBF16の計算速度が最大2倍に向上する。RTX 4090のテストでは165.6TFLOPSから331.6TFLOPSへ跳ね上がり、プロ用GPU並みの数値を記録した。ローカルLLMやAIワークロードを扱うユーザーは、追加投資なしで処理速度を大幅に上げられる。この変更は純正ドライバーと互換性があり、ブート時に適用するだけで動作する。
対象チップと計算速度の倍増
RTX 30シリーズ「Ampere」搭載カードでは、GA102からGA106までのチップでFPまたはBF16のFMA命令(浮動小数点乗算加算命令)がFP32操作へ発行される速度が約2倍に解放された。RTX 3090 Tiの場合、BF16行列乗算が最大80%高速化する。
RTX 40シリーズ「Ada Lovelace」では、AD102からAD106が対象となり、FP16とBF16のテンソルスループットがFP32の累積処理と合わせて2倍になった。RTX 4090のFP16テンソルスループットテストでは、解除前の165.6TFLOPS(1秒あたりの浮動小数点演算能力)が解除後331.6TFLOPSに向上した。この数値は通常、RTX 6000 Adaのような上位プロ用セグメントに割り当てられる。
RTX 20シリーズ「Turing」も同日に同様の手法で2倍の性能向上が確認された。この手法はGA102、GA103、GA104、GA106ベースのGeForce RTXグラフィックカードすべてに対応する。
「RTX 30シリーズ『Ampere』から始まる研究者による解除で、GA102からGA106までのチップにおいてFPまたはBF16のFMA命令がFP32操作への発行速度を効果的に2倍にした。」
ファームウェア制限の解除とドライバー互換性
消費電力の制限であるTGP(ターゲットグラフィックスパワー)は変更前後で同じ450Wが維持される。NVIDIA純正ドライバーのチェックを両方のmodsが通過するため、通常動作する。PCIe FLR(ファンクションレベルリセット)とも呼ばれる機能をオーバーライドし、カーネルへのバインディング前にmodsが適用される。
CUDA(NVIDIAの並列計算プラットフォーム)ベンチマークも問題なく実行できる。NVIDIAはコンシューマー向けGPUのファームウェアスタックで計算ポテンシャルを制限していた。プロ用GPUと同じダイを搭載しているため、シリコン自体は高い性能を持つ。
AD102シリコンの計算敏感な行列乗算と累積処理をNVIDIAが人為的に制限していた。modsによりその制限が外れ、本来の計算能力が引き出される。
「両方の解除はNVIDIAのドライバーチェックを正常に通過し、PCIeファンクションレベルリセットをオーバーライドして純正ドライバーで動作し、CUDAベンチマークも通常通り実施される。」
実用性と適用条件
計算集約型タスクであるローカルLLM(大規模言語モデル)を実行するユーザーにとって、追加の計算パワーはprefill(推論の初期処理)とdecode(応答生成処理)のトークンスループットを大きく向上させる。ゲームプレイでは恩恵が限られるが、機械学習やAI推論では即座に体感できる速度差となる。modsを有効にするにはブート時に適用し、NVIDIAドライバーがカードをカーネルにバインドする前に読み込ませる必要がある。
改変により保証が無効になる点は注意が必要だ。対象はGA102から106、AD102から106のチップに限定され、他のアーキテクチャの対応状況は未だ明記されていない。RTX 3090 TiのBF16行列乗算が最大80%高速化するとあるが、他カードの数値は記載がない。
フォーラムでは機械学習やAI用途に限定されるが、コンシューマーGPUの性能限界を超えられる点で評価されている。

下の画像はTechPowerUpのフォーラムで公開された解除前後のベンチマーク結果を示している。
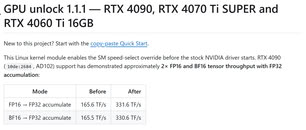
右のグラフはAD102チップのテンソルスループット変化を表している。
今後の展開と未確定事項
両方のmodsは2026年10月25日にほぼ同時に公開された。RTX 20シリーズの解除は同日09:20 UTCの更新で確認された。WindowsとLinuxの両方で動作するが、機械学習環境ではLinuxで主に検証されている。ドライバーの更新やmodsの安定版公開時期は現在未定である。今後は対応チップの拡大と、ゲームやレンダリングワークロードへの影響測定が進む見込みだ。