RTX 20から40シリーズGPUのAI演算制限解除ファームウェア exploit 解説
40秒でわかる内容解説
2026年10月26日、ModderらがRTX 20から40シリーズのGPUに課されたAI演算速度制限を解除するファームウェア exploit を公開した。SEC2ファームウェアのスタックバッファオーバーフロー脆弱性を突く手法により、RTX 4090のピークテンソルレートが2倍になるなど行列演算の性能が大幅に向上する。ローカルAI学習環境を組む自作PCユーザーにとって、既存のグラボの有効活用策となる可能性がある。実ワークロードでの向上幅はピークレートより小さく、電力制限の設定によってベンチマーク結果に幅が生じる。各世代ごとに独立したプロジェクトが非公式Linuxモジュールを提供しており、実験的なWindows版も開発中だ。
GPUのAI演算速度制限が解除される仕組み
NvidiaはGeForceのRTX 20から40シリーズにおいて、FP16演算速度の半分程度にFP32演算を制限していた。この制限はプロ向けTuringとAmpereカードには適用されず、GeForceシリーズに課されたものだった。ModderたちはSEC2ファームウェアのスタックバッファオーバーフロー脆弱性を発見し、これを突くことで制限を解除した。写真ではRTX 4090のチップが映っている。
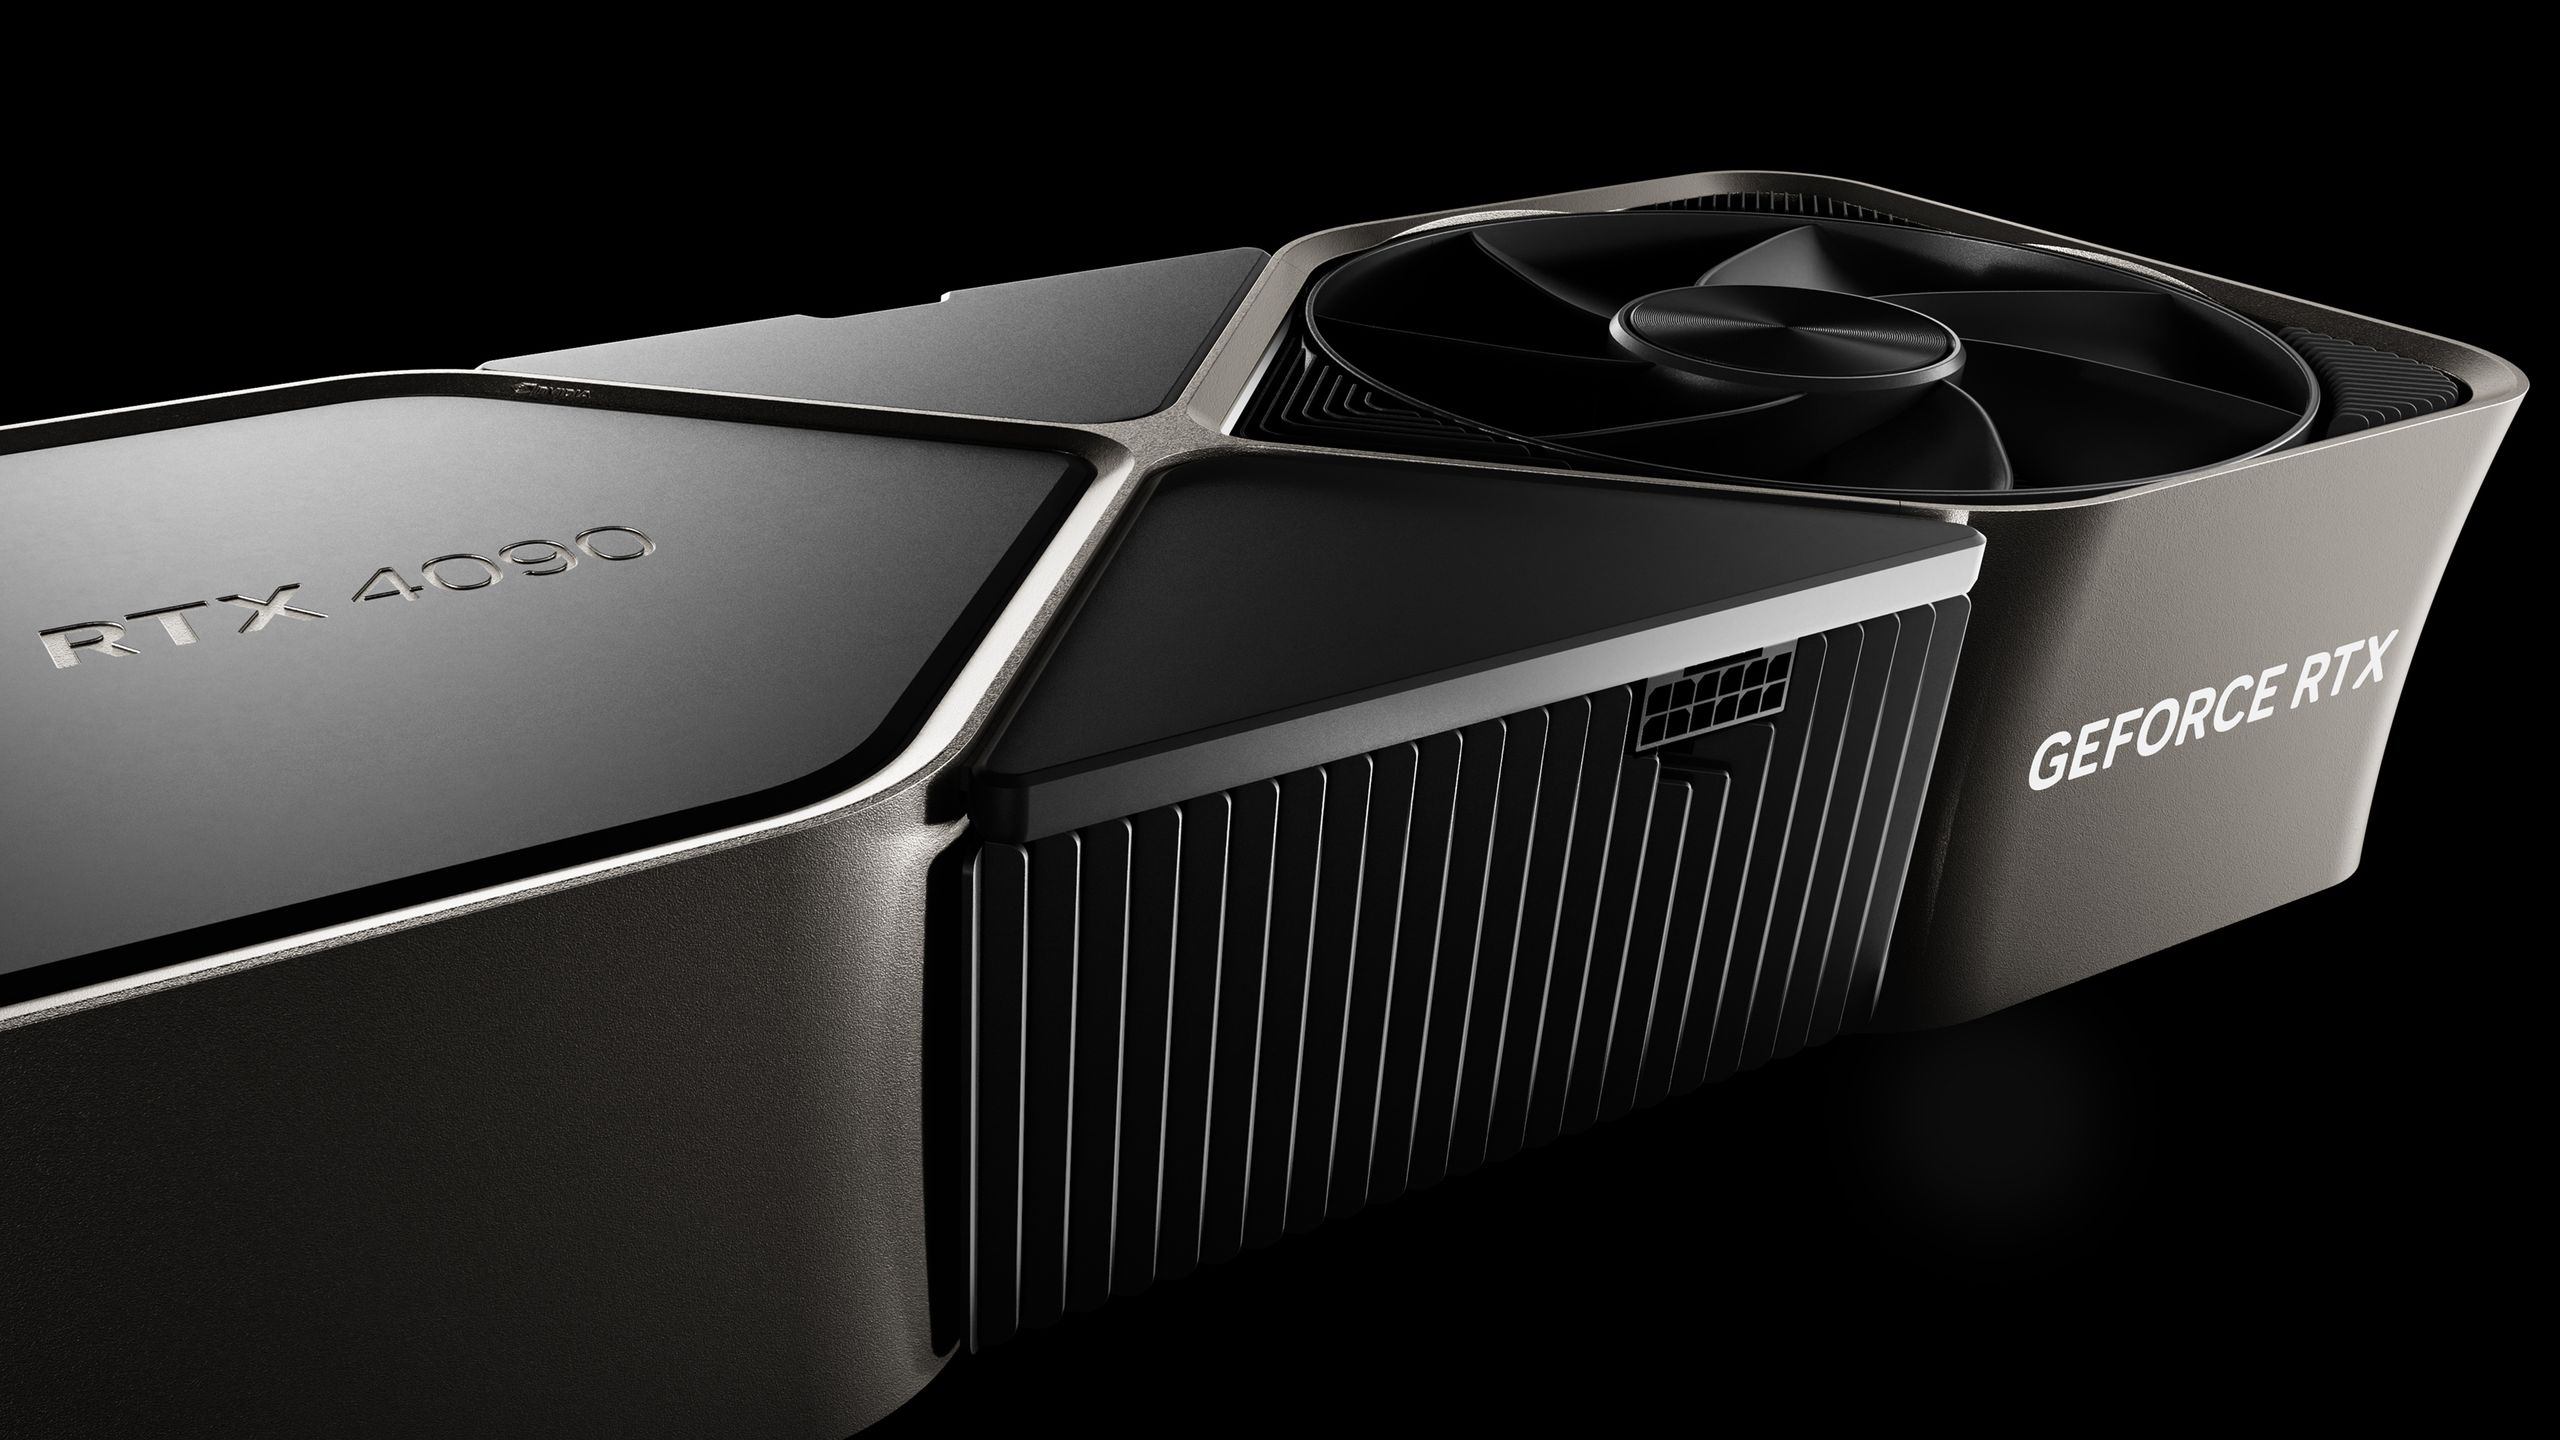
脆弱性はJon Pry氏がZenodoで公開した論文で解説されている。SEC2 Booterファームウェアはホストドライバが直接書き換えられない速度選択レジスタを持っている。V67ペイロードと呼ばれる4バイトのデータを書き込むと、Heavy Secureモードでコードが実行され、制限フラグが解除される。
解除には各世代ごとに独立したプロジェクトが用意されている。turing-unlockはRTX 2080 Tiの22GBメモリ増設モデルで動作を確認している。gpu-unlockはRTX 30シリーズのGA102からGA106までを対象とし、gpu-unlock-adaはRTX 4090でピーク値の倍化を実証した。RTX 50シリーズは対象外とされている。
理論値の向上は顕著だが、実ワークロードでの効果はピークレートほど大きくない。RTX 4090のテンソルレートは165.6 TFLOPSから331.6 TFLOPSに跳ね上がった。RTX 3090 Tiの行列数学は最大80%向上する。ただし、チャットボットのトークン生成速度はメモリ帯域幅に依存するため、ほぼ変わらない。
電力制限の設定によってベンチマーク結果に幅が生じている。cuBLAS GEMMベンチではRTX 4090で12から34%の改善にとどまった。Windows版ポートではRTX 4070 TiがFP16で80.1%向上した。RTX 3090 TiではFP16が35%、BF16が80%、TF32が94%の向上を示した。LLMのプリフィル処理は14から36%高速化した。
各世代ごとの対応状況と技術的背景
各プロジェクトは非公式のLinuxモジュールを提供し、実験的なWindows版も開発中だ。 gpu-unlockのZagitta氏はHacker Newsで、 exploit は自前のアイデアではないと明かした。既存のCMP 170HX unlockerから派生した手法を応用し、必要な2ビットを切り替えている。
| プロジェクト名 | 対象世代 | 主要対応カード |
|---|---|---|
| turing-unlock | RTX 20 | RTX 2080 Ti (22GB) |
| gpu-unlock | RTX 30 | RTX 3090 Ti, 3090, 3080 |
| gpu-unlock-ada | RTX 40 | RTX 4090 |
| — | RTX 50 | — |
対象カードの互換性は世代によって異なる。RTX 20シリーズはTuringアーキテクチャのBF16非サポートによりFP16のみの計算となる。RTX 30シリーズではRTX 3070 TiやGA103搭載カードの検証が残っている。RTX 40シリーズではRTX 4090 Dや4070 Ti Superの実験的サポートが進む。
開発ロードマップは未定で、互換性リストの拡充が主目的だ。 gpu-unlockはユーザーから動作報告を募っている。共有ファームウェアは未検証カードの正式サポートを意味しない。各プロジェクトは独立してベンダーIDを集約している。
既存のGeForceカードにAI演算用の速度制限が設けられた経緯は明確でない。プロ向けカードには課されていないため、市場差別化または熱設計上の理由が推測される。制限を解除することで、学習環境の構築コストを抑制できる可能性がある。
電力の上限値が性能に直結する。225 Wに制限したRTX 3090はBF16演算で25%の向上にとどまった。250 WのRTX 2080 TiはFP16で36から64%の改善を見せた。260 Wの同一モデルでは59%の向上が記録された。
自作PCユーザーが注目する実用性とリスク
自作PCコミュニティでは、推論よりも学習環境での有用性が指摘されている。LLMのトークン生成はメモリ帯域幅に依存するため、演算速度の向上が直接の速度上昇につながらない。一方、プロンプト処理や画像生成、モデル学習の速度向上が期待される。
Looks like its only for 16/32-bit ops, which are almost irrelevant to LLM inference, but are relevant to training.
LLMの推論では16ビットと32ビットの演算がほぼ無関係だが、学習には有用だという指摘がある。
性能向上の一方で、カード故障リスクへの懸念も根強い。turing-unlockのREADMEはハードウェア損傷の可能性を警告している。KohakUnlockプロジェクトはGPUやホストのハング、データ破損、起動不能を挙げている。電力制限を緩めた場合の安定性はカードや環境により異なる。
Nvidiaの価格戦略に対する不満も背景にある。マイニングブーム時の価格高騰を経て、中古市場で3年から4年前のカードが新品価格を超える現象が続いている。自作PCユーザーは既存のグラボでAI学習を完結させられる点に注目している。クラウドAPI利用コストと比較し、カード故障時のリプレイス費用を天秤にかける選択が主流だ。
制限の存在理由については、Nvidiaの利益戦略や熱設計説が浮上している。グラボをモッドして電力制限を上げても、必ずしも最適解ではないと指摘する声がある。ローカルAIを実行する際は、クラウド利用コストとハードウェアの耐久力を比較する必要がある。
今後の互換性確認と次世代GPUの対応予定
各プロジェクトの互換性リストは拡充途上だ。 gpu-unlockはRTX 3070 TiとGA103搭載カードの検証を待っている。 gpu-unlock-adaはRTX 4090 Dと4070 Ti Superの実験結果を集約中だ。 turing-unlockは未検証のTuring IDリストを公開している。
電力制限の設定がベンチマーク結果に大きく影響するため、実利用での安定した性能向上幅はカードごとに異なる。RTX 4090では450 Wで最大34%の改善にとどまる報告もある。RTX 3090 Tiでは450 WでBF16演算が80%向上する。
開発者はHopperとBlackwell世代を現在の手法の対象外としている。RTX 50シリーズのGPUには別のアプローチが必要だ。セキュリティプロセッサのアーキテクチャ変更により、SEC2ファームウェアの脆弱性が解消される可能性がある。
Tom's Hardwareによると、各プロジェクトのロードマップは未定とされている。ユーザーからの互換性報告を受け、2026年内に主要カードのリストが更新される見込みだ。