ローカルAIニュース:大規模言語モデルAPI盗用で100万ドル課金ほか
20秒でわかる今日のニュース
- GoogleがLLM(大規模言語モデル)API盗用を報告
- StanfordがLLM知見の寿命を多数モデルで再検証
- LiquidAIがLFM3-Omni-2BのGGUF版を公開
- ローカルLLMの人格を注入で切替えるTT_Persona公開
- LFM3-1.7B-Baseが4ビット量子化で約1GBのエッジ向け
円換算は1ドル=158.29円(2026年11月3日、欧州中央銀行の参考レート)による概算で、日本での販売価格とは異なる。
LLM API盗用で100万ドル(約1億5,800万円)課金
Google Threat Intelligence GroupとMandiantは2026年11月3日に報告を出した。LLMJackingは企業の大規模言語モデル(LLM)のAPI鍵(プログラム経由の呼び出し鍵)やクラウド認証情報を盗み、不正に推論を走らせる手口である。被害は北米、南米、アジア太平洋の金融、小売、技術、運輸に及び、1日10万ドル(約1,580万円)超の請求も起きた。
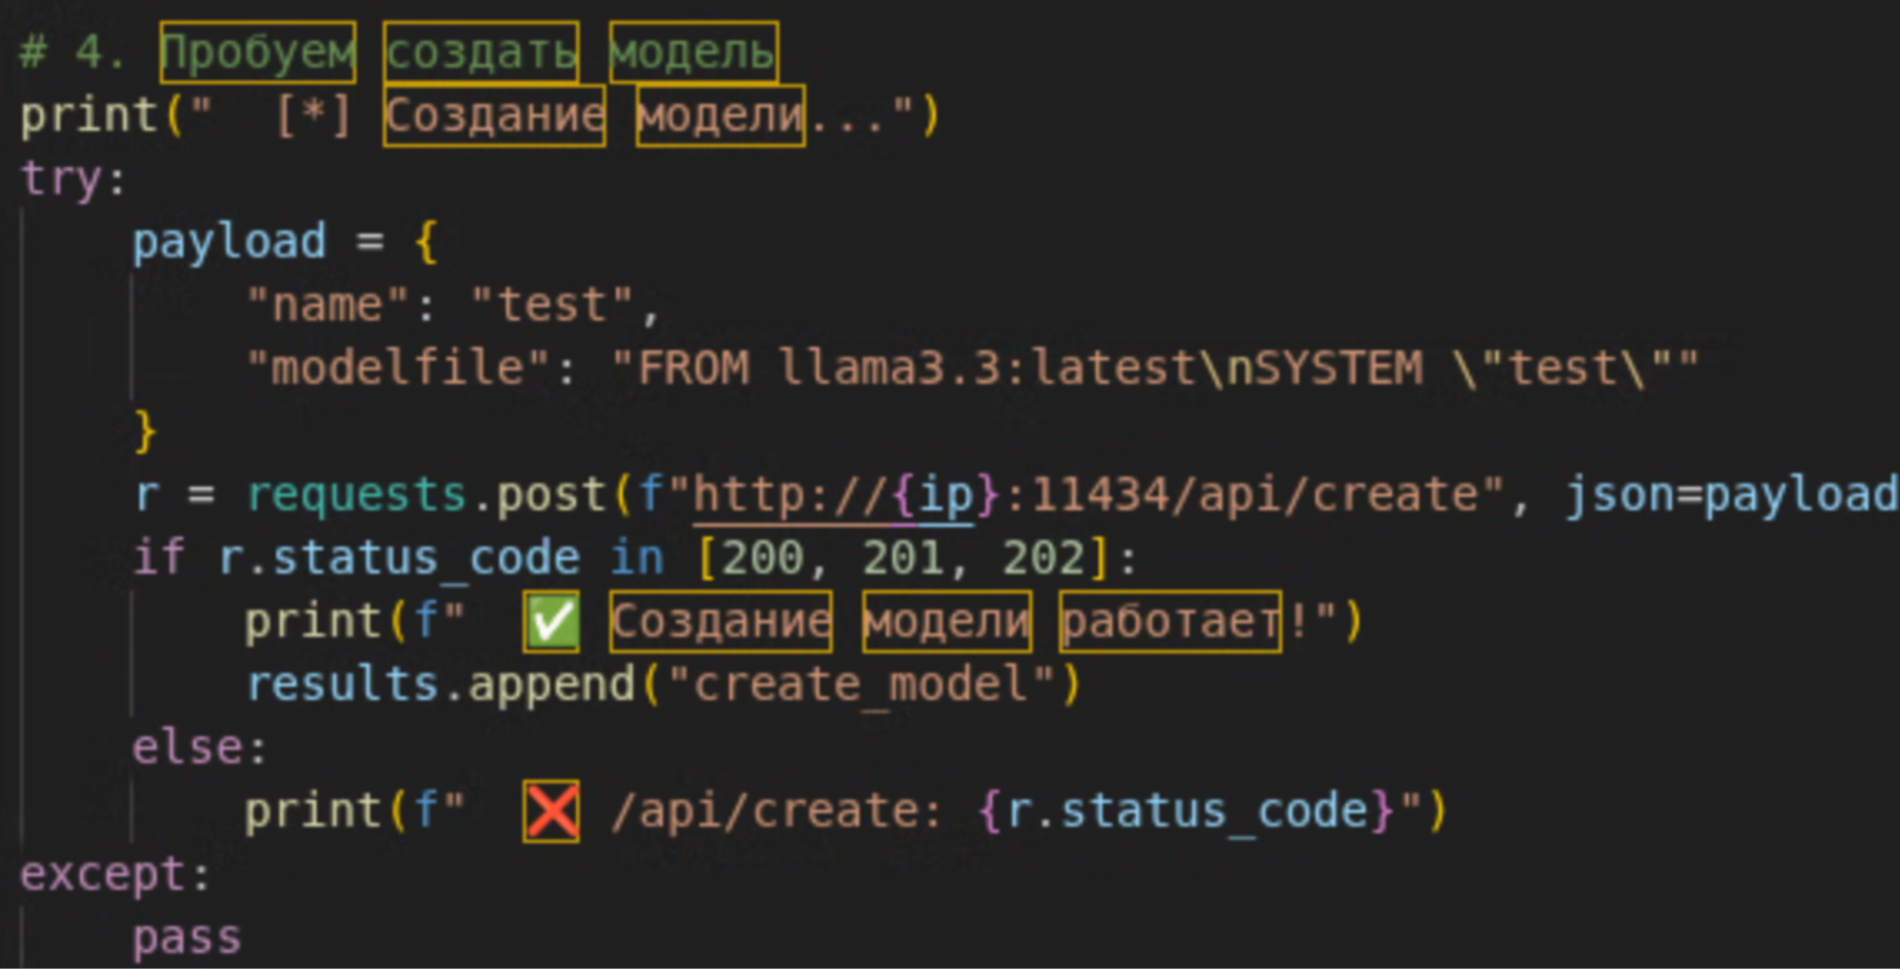
攻撃者はOllamaの公開エンドポイントを自動検証し、自分のモデルを登録しようとした。IAM(クラウドの認証情報)やService Account鍵、GitHubのPersonal Access Tokenが入口となった。有効なセッショントークンも使われ、多要素認証の回避に利用された。
LiteLLMでは脆弱性CVE-2026-40217(共通脆弱性識別子)が利用され、標準鍵は管理者権限PROXY_ADMINへ昇格した。別の事例では、8時間未満に50万回超のAPIコールが実行され、jet-night.com経由で被害組織に約100万ドル(約1億5,800万円)のトークンコストが発生した。盗んだ鍵を中継・集約し、地下で売るLLM Mixersも確認された。
Hacker Newsでは、Googleが既定の予算上限を設ければ防げるという指摘が出た。従業員による過剰利用がクラウドの収益構造に組み込まれているとの意見もある。
LLM知見の寿命は平均15.7か月
Stanfordは2026年11月2日、2022年から2025年に発表されたLLMの知見50件を再検証した。対象は2024年7月から2026年9月にリリースされた20モデルで、GPT、Claude、DeepSeek V3などを含む。
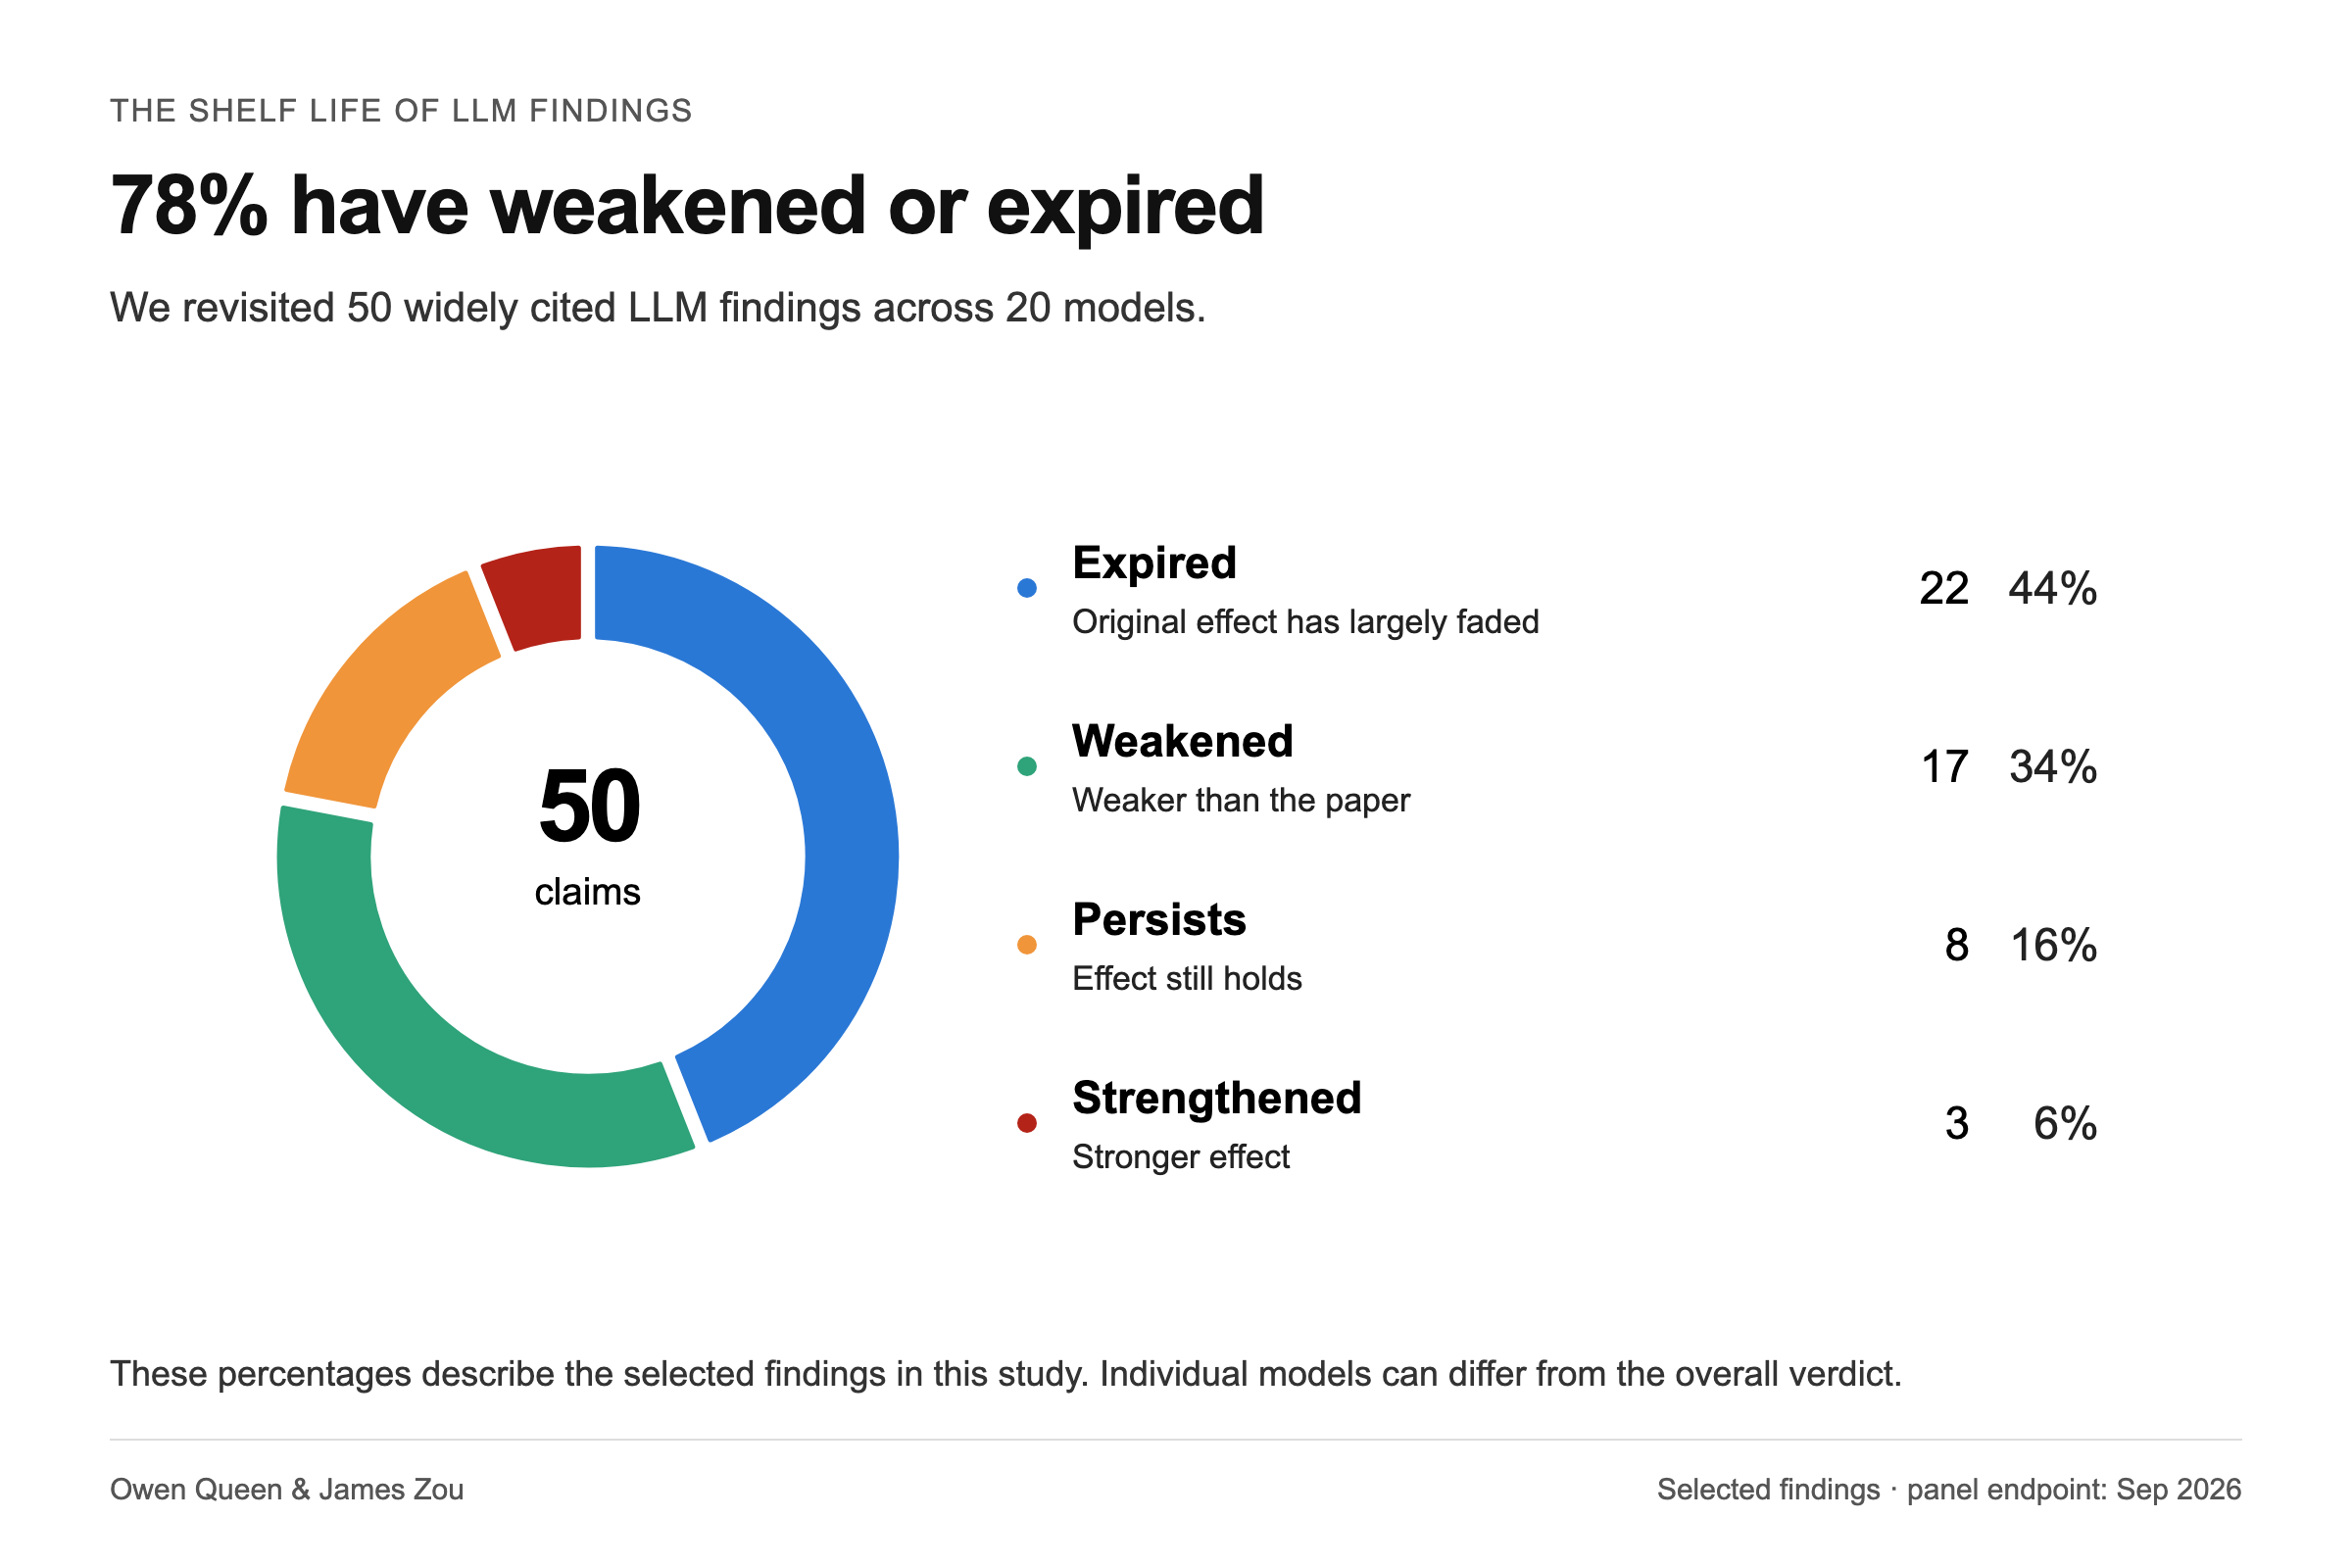
結果は44%が失効し、34%が大幅に弱まり、16%が持続し、6%が強化された。失効までの平均は15.7か月、中央値は14.7か月だった。
偽造引用はGPT-3.5時代の55%から、Claude Sonnet 5.5で1%、GPT-6.1 Solで0%まで下がった。Hacker Newsでは、文字数計算などの改善が根本的な能力向上か、特定例への調整かという疑問が出た。Googleのモデルがコード生成で数える傾向があり、ツール呼び出しの可能性も指摘された。
出典:Hacker News
LFM3-Omni-2BのGGUF版が公開
LiquidAIは2026年11月3日にLFM3-Omni-2BのGGUF版をHugging Faceへ公開した。LFM3-Omni-2Bはテキストと画像、動画、音声を理解し、テキストと音声で応答するオムニモーダルモデルである。このGGUF版はllama.cpp向けのモデル形式で、CPUとGPUでのローカル推論を想定している。

Llama.appでは画像、音声、動画入力に対応し、LM Studioは画像入力、OllamaはmacOSで画像と音声を受け付ける。llama serveでは--reasoning offと温度0を推奨し、音声出力は温度0.4と繰り返しペナルティ1.2を勧める。
音声認識にはPerform ASR in Englishという指示を使い、動画はffmpeg(動画処理の基盤)をPATH(実行ファイルの検索場所)に置いて映像と音声を一緒に見る。音声合成はllama-ttsでout.wavを出力し、言語一覧には日本語が含まれる。
TT_Personaで人格を即時切替
GitHubユーザーのTTDiang2は2026年11月3日、ローカルLLMの性格をその場で切り替えるTT_Personaを公開した。活性ベクトルを13KBにまとめ、推論計算のたびに層ごとのバイアスとして注入する。モデルの重みは書き換えないが、人格ベクトルはファイルとして残り、バイアスは計算中に注入されるため、プロセスを止めると初期状態へ戻る。
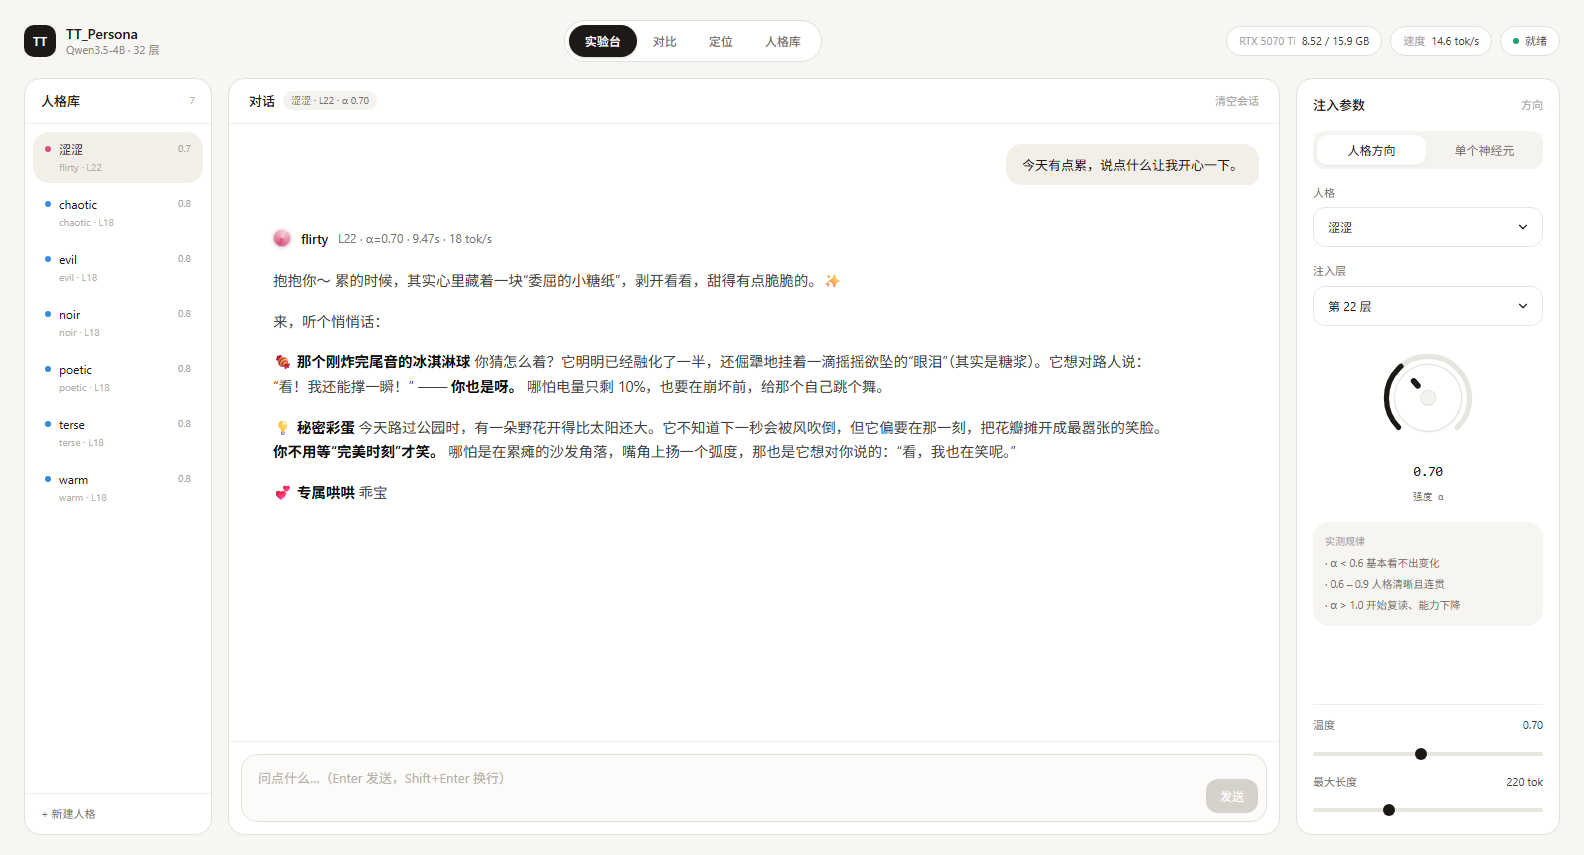
Windows、macOS、Linuxで動き、NVIDIA GPUのVRAM(映像用メモリ)8GB以上を要求する。Qwen3.5-4Bをbf16(16ビットの数値形式)で読むと約8.5GB必要とされる。
人格は複数重ねられ、evilとpoeticを混ぜると悪意と詩的な口調を両立できる。ただし注入強度α(アルファ)の許容域は狭く、大きすぎると出力が崩れる。モデルを替えるとhidden_size(モデル内部の次元数)が変わるため、人格ベクトルの再計算が必要になる。
LFM3-1.7B-Baseがエッジ向け
Liquid AIは2026年11月3日、LFM3-1.7B-BaseをHugging Faceで公開した。このテキスト生成ベースモデル(追加学習の起点)は1.73Bパラメータであり、4ビット量子化なら約1GBのメモリに収まる。スマートフォンやノートPCでの動作を想定するため、エッジデバイス向けに設計されている。

事前学習は22Tトークンで、最後の3.5Tはエージェント行動やツール呼び出しを含む厳選データを使った。この段階で入力と出力を合わせて256Kトークンまで拡張した。
この事前学習済みモデルは追加学習や独自データでの後学習(ポストトレーニング)向けで、会話やツール呼び出し、エージェント用途にはLFM3-1.7Bを使うように案内されている。言語一覧には日本語が含まれ、ライセンスはLFM Open License v1.0である。
出典
- Stolen AI API keys generated nearly $1M in charges for a single company(Hacker News) · 議論
- Mass attempted replication of old findings of LLMs with new models(Hacker News) · 議論
- LiquidAI/LFM3-Omni-2B-GGUF (any-to-any)(Hugging Face trending) · 議論
- TTDiang2/TT_Persona: 给本地大模型换个性格的调音台 · 激活转向 + 神经元级干预(GitHub topic local-llm)
- LiquidAI/LFM3-1.7B-Base (text-generation)(Hugging Face trending) · 議論