ローカルAIニュース:Qwenが125B実験モデル、Unslothが量子化
20秒でわかる今日のニュース
- Qwenが125BのFlash-Next公開、Unslothが量子化
- Ricursiveが65B公開、密型で1M対応
- Qwenが27B密モデル公開、1M拡張対応
- 24GiB Mac用JustFit公開、320Kページ容量
- MacBook Proで検索拡張、30B-A3Bが2.7倍高速
Qwen125B実験モデルとUnsloth GGUF
Qwenは2026年11月5日、オープンウェイトのQwen3.8-Flash-Nextを公開した。Qwen4の基盤と位置づける実験アーキテクチャで、125Bのうち6Bだけを活性化し、51BのN-gram埋め込み(短い語列の埋め込み)と4BのMTP(追加の予測層)を足す。
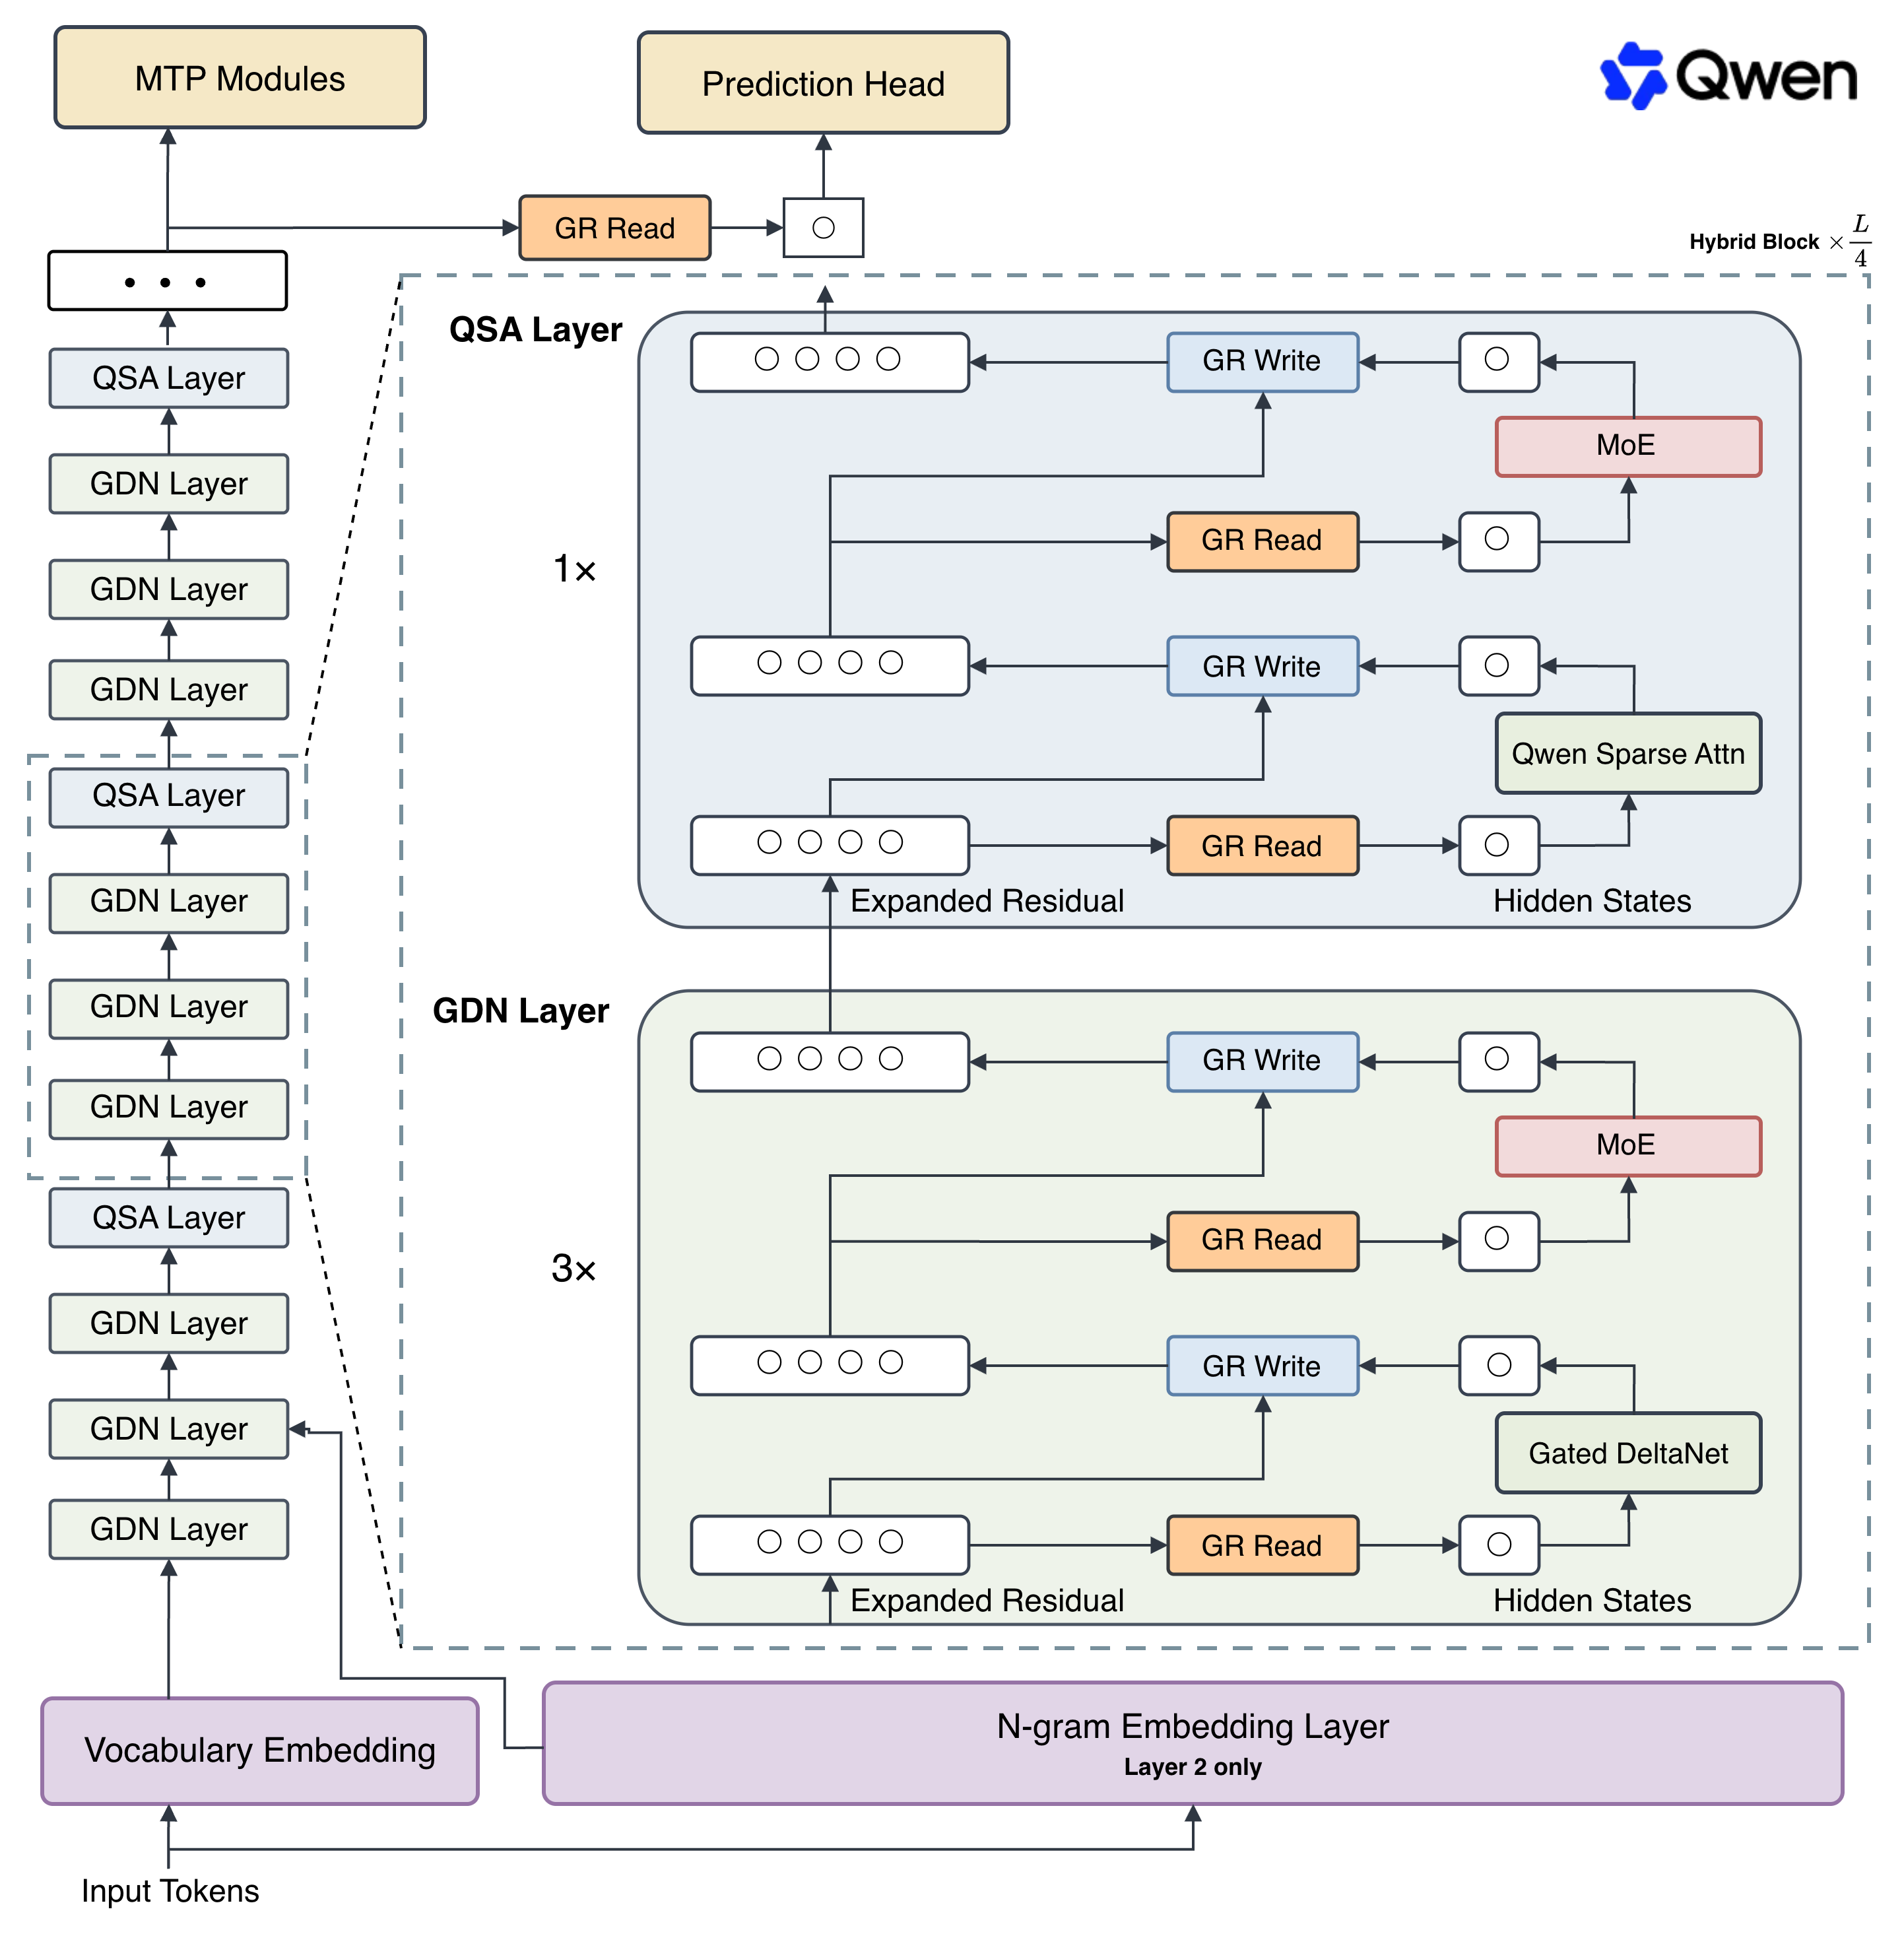
コンテキストは262,144トークンを標準とし、1,000,000トークンまで拡張できる。推論側ではUnslothがDynamic v3.1 GGUFを11月4日に公開した。GGUFはllama.cpp向けの重み形式で、MTPを使うと1.3〜1.7倍速くなるとされる。
アーキテクチャはGated DeltaNetとQwen Sparse Attention(疎な注意)を組み合わせる。Gated Residual(残差接続の制御)とN-gram Embeddingも加わる。MuonとAdamW(学習用最適化器)を重み分類に割り当てる学習手順を採る。N-gram埋め込みはMoE(専門家ネットワーク)よりメモリから外しやすいとされ、メモリが限られる加速装置での扱いやすさを狙う。
出典:Hugging Face trending、Hugging Face trending詳しくはクローズアップ記事へ
Ripple-65B Preview公開、65B密で1M対応
Ricursive Intelligenceは2026年11月4日、65BパラメータのモデルRipple-65B Previewを公開した。Apache 2.0で配布され、密なTransformer型として設計された。12Tトークンのテキスト中心コーパスで事前学習し、コンテキストは最大1M(100万)トークンに対応する。

エージェント型コーディング試験のTerminalBench 2.1で80.52を記録した。Reflection Beam 501Bの80.1を上回った。比較対象にはThinking Machines Inkling 975BやNVIDIA Nemotron 3 Ultra 550Bも含まれる。
同社は1〜5人の小規模チームでNVIDIAハードウェア向けに設計し、BF16(16ビット浮動小数点)のまま学習したと説明する。MoE(専門家ネットワーク)ではなく密なTransformerを選び、DGX Sparkなどの消費者向け機器で動かせるサイズに収めた。
BF16とNVFP4(低精度形式)のチェックポイントが用意され、NVFP4はローカル開発を想定した配布だ。評価環境によってスコアは変動する。
Qwen3.8-27B公開、27B密型と思考制御
Qwenは2026年11月5日、27Bパラメータの密なビジョン言語モデル(画像と言語を扱う)Qwen3.8-27Bを公開した。Qwen3.5のアーキテクチャを基盤に、コーディング、専門業務、研究、長時間のエージェント作業で性能向上を掲げる。
コンテキストは262,144トークンを標準に、1,000,000トークンまで拡張できる。推論はHugging Face Transformers、vLLM、SGLang、TokenSpeedに対応し、画像と動画の理解を備える。
思考機能は既定で有効だが、リクエストごとに無効化できる点が特徴だ。reasoning_effort(推論設定)で深さを調整し、preserve_thinking(思考保持)で過去の思考文脈を保持する。ベンチマークではTerminal Bench 2.1(エージェント型端末操作試験)で73.0、SWE-bench Pro(実装課題試験)で61.7を記録した。
Qwen Cloudでは既定で1Mコンテキストと公式ツールを備えたホスト版が予定され、提供時期は近日公開とされている。
JustFit v2.3.1、24GiB Macで27B
2026年11月5日、JustFit v2.3.1がGitHubで公開された。Apple SiliconのMacで27Bパラメータの言語・視覚モデルを動かす。M4 Pro、M5 Pro、M6で24 GiB以上のメモリを想定し、macOS 27.0以上で動く。
圧縮したコンテキスト、常駐する補助モデル、CPU、GPU、ANE(Appleの機械学習用演算装置)の役割分担を一つのメモリ予算で調整する。ウォームプレフィックスでは2つの同時リクエストで合計320Kページ容量に達したが、単一リクエストの保証ではない。
16K設定ではv2の中央値デコード速度がv1の2.0〜2.5倍になった。標準モデルパックは約17.4 GBで、Python 3.12が推奨され、3.12〜3.14がサポートされる。M5 ProではTQ4 KV(鍵と値のキャッシュ)量子化のAIME 2026(数学試験)を測った。A8(GPU経路)オフで86/90(95.6%)、A8オンで85/90(94.4%)だった。
画像処理のオフロードはGPU容量を確保する目的で、画像の応答時間低下は保証されない。実装はSplash 1.3.0由来で、Apache 2.0のコードとして配布される。
出典:Hacker News
uni-rag、MacBookでRAGエネルギー比較
dmay01は2026年11月5日、MacBook Pro M5で動く完全ローカルRAG(検索で文脈を補う生成)アシスタントuni-ragを公開した。Ollama(ローカル実行環境)とLanceDB(ベクトルデータベース)を使い、埋め込みモデルbge-m3で埋め込み、Qwen3系列の4B、14B、30B-A3Bを比較した。
大学の文書4,297ファイル、266,057チャンクを対象に、60問のうち回答可能な45問で検索性能を測った。期待する出典が上位8件に入ったのは20件で、検索が主な制約になった。MoE(専門家ネットワークから一部だけを使う構造)のQwen3-30B-A3Bと、密な14Bモデルを比べた。
MoEのQwen3-30B-A3Bは密なQwen3-14Bより2.7倍速く、回答あたりエネルギーは185 Jで362 Jの約半分だった。期待する出典の引用率は18/45で同じとなり、速度とエネルギーに差が表れた。4BはMoEより37%少ないエネルギーで済んだが、引用は14/45に留まった。
Thinking機能(推論過程を生成する機能)はエネルギーを2.8〜5.5倍増やし、30Bの引用率を高めなかった。計測は単一マシン単一実行の中央値で、期待する出典の引用率は回答の正しさを直接測る指標ではない。2026年11月5日時点で、v0.2では再ランク付け(検索結果の並べ直し)と文書ごとの多様性を同じ質問で測る。
出典
- Qwen/Qwen3.8-Flash-Next (image-text-to-text)(Hugging Face trending) · 議論
- unsloth/Qwen3.8-Flash-Next-GGUF (image-text-to-text)(Hugging Face trending) · 議論
- ricursiveAI/Ripple-65B-Preview (model)(Hugging Face trending) · 議論
- Qwen/Qwen3.8-27B (image-text-to-text)(Hugging Face trending) · 議論
- JustFit: Run Qwen 27B Fast with its full 256K context on a 24 GB Mac(Hacker News) · 議論
- dmay01/uni-rag: Fully local RAG over my university documents, with latency and energy measured per answer(GitHub topic local-llm)