ローカルAIニュース:drakestapletonがOmegaでNVIDIA GB10の機械コード生成
25秒でわかる今日のニュース
- drakestapletonがOmegaでNVIDIA GB10の機械コードを独自生成
- Memorillaが凍結LLM向け固定メモリトークンをarXiv公開
- AMD Strix Haloで763BパラメータDeepSeek V4.1をGufoで動作
- Francesco149が消費者向けGPU用ディープサーチスイートを公開
- V100 4枚でThinkingCap-Qwen3.8を1Cat-vLLMで高速化
円換算は1ドル=158.33円(2026年11月6日、欧州中央銀行の参考レート)による概算で、日本での販売価格とは異なる。
OmegaコンパイラがGB10で独自機械コードを生成
開発者drakestapletonが独自言語Omegaのコンパイラを408バイトのシードから成長させ、NVIDIA GB10の機械コードを生成した。Cコンパイラやリンカーを一切使わずにビルドされ、104万個の値がすべて正しく出力された実績を収めている。
2026年11月7日にはGitHubがアクションをスパムと判定し109のレポジトリを非表示にした。プロジェクトは分散型コードホスティングネットワークRadicleへ移行した。10月21日には350億パラメータのモデルをCUDAライブラリゼロでサーブする実績も残している。
x86-64バックエンドは未検証ドラフトで動作速度に課題が残る。NVIDIAのカーネルモジュールとファームウェアがあれば独自パスで動作する環境が整っている。コンパイラ自身も4段階のラングで成長し自己コンパイルする固定点に達した。
Memorillaが凍結LLM向け固定メモリトークンを公開
Vignesh Kothapalliらの研究チームが凍結LLM向けの固定メモリトークン生成システムMemorillaをarXivで公開した。文書コレクションを一度エンコードし、クエリに応じて固定数のトークンをモデルの埋め込み空間に配置する仕組みだ。16メモリトークンだけでMem0やMemoRAGを8ベンチマーク中5つで上回り、FactKGではフルコンテキスト推論の80.43%を超え84.33%の精度を達成した。
トークン数は108分の1で済み、エージェント環境での平均成功率も18.6%から24.2%に改善された。テキストをスキップして意味情報を直接注入する方式は概念把握に強く、正確な引用には弱い特性が報告されている。連続するドキュメント数が増えるアジェント環境でも、記憶が蓄積されながら推論が安定する。
出典:Hacker News
763BパラメータモデルがAMD Strix Haloで動作
Francesco MocaがAMD Strix Haloプロセッサと128GB統一メモリを搭載したLinux環境で、763BパラメータのMoEモデルDeepSeek-V4.1-Flash-1017を分散型AI推論エンジンGufo経由で動作させるソース拡張機能ds41-gufo-extensionを公開した。密度の高い重みをRAMに保持し、ルーティングされた専門家をSSDから読み込む専門家ストリーミング機能を備える。
推奨される推論補助モデルはLucebox提供のDSpark-draft-Q2K-Q4Kで、サイズは4.6 GiBである。
2台のPCIe 4.0 x4ドライブに専門家テールを配置すると10.7 GB/sの読み込み速度を達成し、11月7日のベンチマークではフォーク版と同等の生成テキストを確認した。ホストメモリは約1.75 GiBを残してモデルが動作し、約95〜96 GiBの専門家キャッシュを確保する。
消費者向けGPU用ディープサーチスイートが登場
Francesco149が消費者向けGPU上で動作するDeepSeek Harness(dsh)向けディープサーチスイートdsh-deep-researchをGitHubで公開した。オーケストレーターとリサーチャー、クリティッカー、ライター、ファクトチェッカーが協調する。検索やPDF解析、YouTube動画の解析、引用レポート生成を行う。
16GB VRAMと64〜128GB RAMの環境で約70 tok/sの推論速度と256Kコンテキストを実現する。
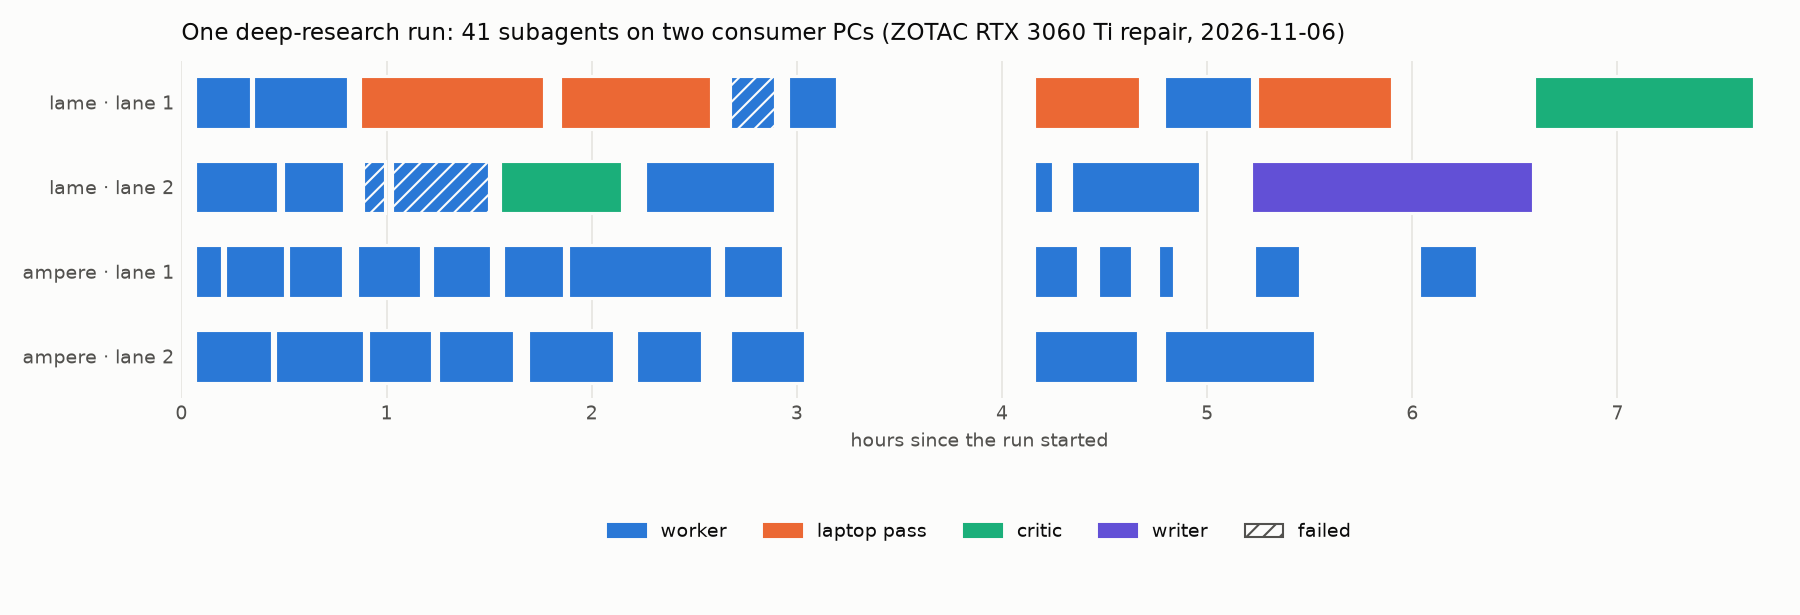
2026年11月のテストランでは7.8時間で41のサブエージェントが1692回のツールコールを実行し、14560語のレポートを生成した。検索コストは1回あたり約0.30ドル(約47円)で、Exaクレジットのみが必要となる。各ワーカーは発見内容をファイルに追記し、コンテキストが圧縮されるためセッションの安定性が向上する。
4枚のV100でThinkingCap-Qwen3.8を高速化
GitHubユーザーtemptationOne-webがTesla V100 32GB 4枚構成(PCIe接続、NVLinkなし)環境向けに、ThinkingCap-Qwen3.8-Flash-Next NVFP4を1Cat-vLLMで高速動作させるセットアップレシピを公開した。独自パッチを適用し環境変数VLLM_SM70_CT_NVFP4_TM=1を設定する。NVFP4形式の専門家をTurboMindパスにルーティングしている。
これにより単一ユーザーの推論速度は80 tok/sから114 tok/sへと向上している。
GPUを150Wにクロック制限しカーネルフラグiommu=ptを適用するとP2P速度が約11%向上する。単一ユーザーで約160〜170 tok/s、4ユーザー同時で合計約340 tok/sを達成している。LiveCodeBench easy+mediumでは55/61のスコアを記録している。262144トークンのコンテキスト長とビジョン機能、ツール呼び出しにも対応し、MTPによる推論加速を有効化している。
出典
- drakestapleton/sovereign-intelligence: GitHub censored me. I demand to be heard. I broke CUDA: Omega, my own language, writes NVIDIA GB10 (DGX Spark, sm_121) machine code with its own encoder. No CUDA toolkit, no nvcc, no PTX. 1,048,576 of 1,048,576 correct on the chip. Code on Radicle; receipts, papers and the DGX Spark field manual at aienos.com(GitHub topic local-llm)
- Memorilla: Latent Semantic Memory for LLMs(Hacker News) · 議論
- franzmoca/ds41-gufo-extension: DeepSeek V4.1 Flash for Gufo on AMD Strix Halo: DSpark drafting, vision, tool calls and SSD expert streaming(GitHub topic local-llm)
- Francesco149/dsh-deep-research: A deep-research swarm for DeepSeek Harness that runs on your own consumer GPUs: lanes across local model servers, fact checks, cited reports, optional real-browser laptop MCP(GitHub topic local-llm)
- temptationOne-web/v100-thinkingcap-setup: ThinkingCap-Qwen3.8-Flash-Next NVFP4 on 4x V100 32GB (PCIe, no NVLink) with 1Cat-vLLM: setup, patches and benchmarks. ~160 tok/s single user, ~370 tok/s with 4 users, LiveCodeBench 55/61.(GitHub topic local-llm)