ローカルAIニュース:Linux向け音声アシスタントUltron公開、Macで177Bモデル駆動
20秒でわかる今日のニュース
- Linux向け100%ローカル音声AIアシスタント公開
- LLMが重みを理解する実験ログ1125ターン公開
- Apple MLX向けQwen3.8-27B推論速度2倍から4倍高速化
- Mac向け推論エンジンTokspurで177Bモデルを65kコンテキスト動作
- Qwen3.8-Flash-NextのNAS探索版E384がHugging Faceで公開
Linux向け100%ローカル音声AIアシスタント公開
NVIDIA GTX 1650などのコンシューマーGPUで動作する完全ローカルの音声AIアシスタントUltronが、2026年11月9日にGitHubで公開された。開発者のNitin Yadavが手掛けた本プロジェクトは、画面認識とブラウザ連携を統合する。Apple visionOSにインスパイアされたGlassy Dashboard V18で操作する。
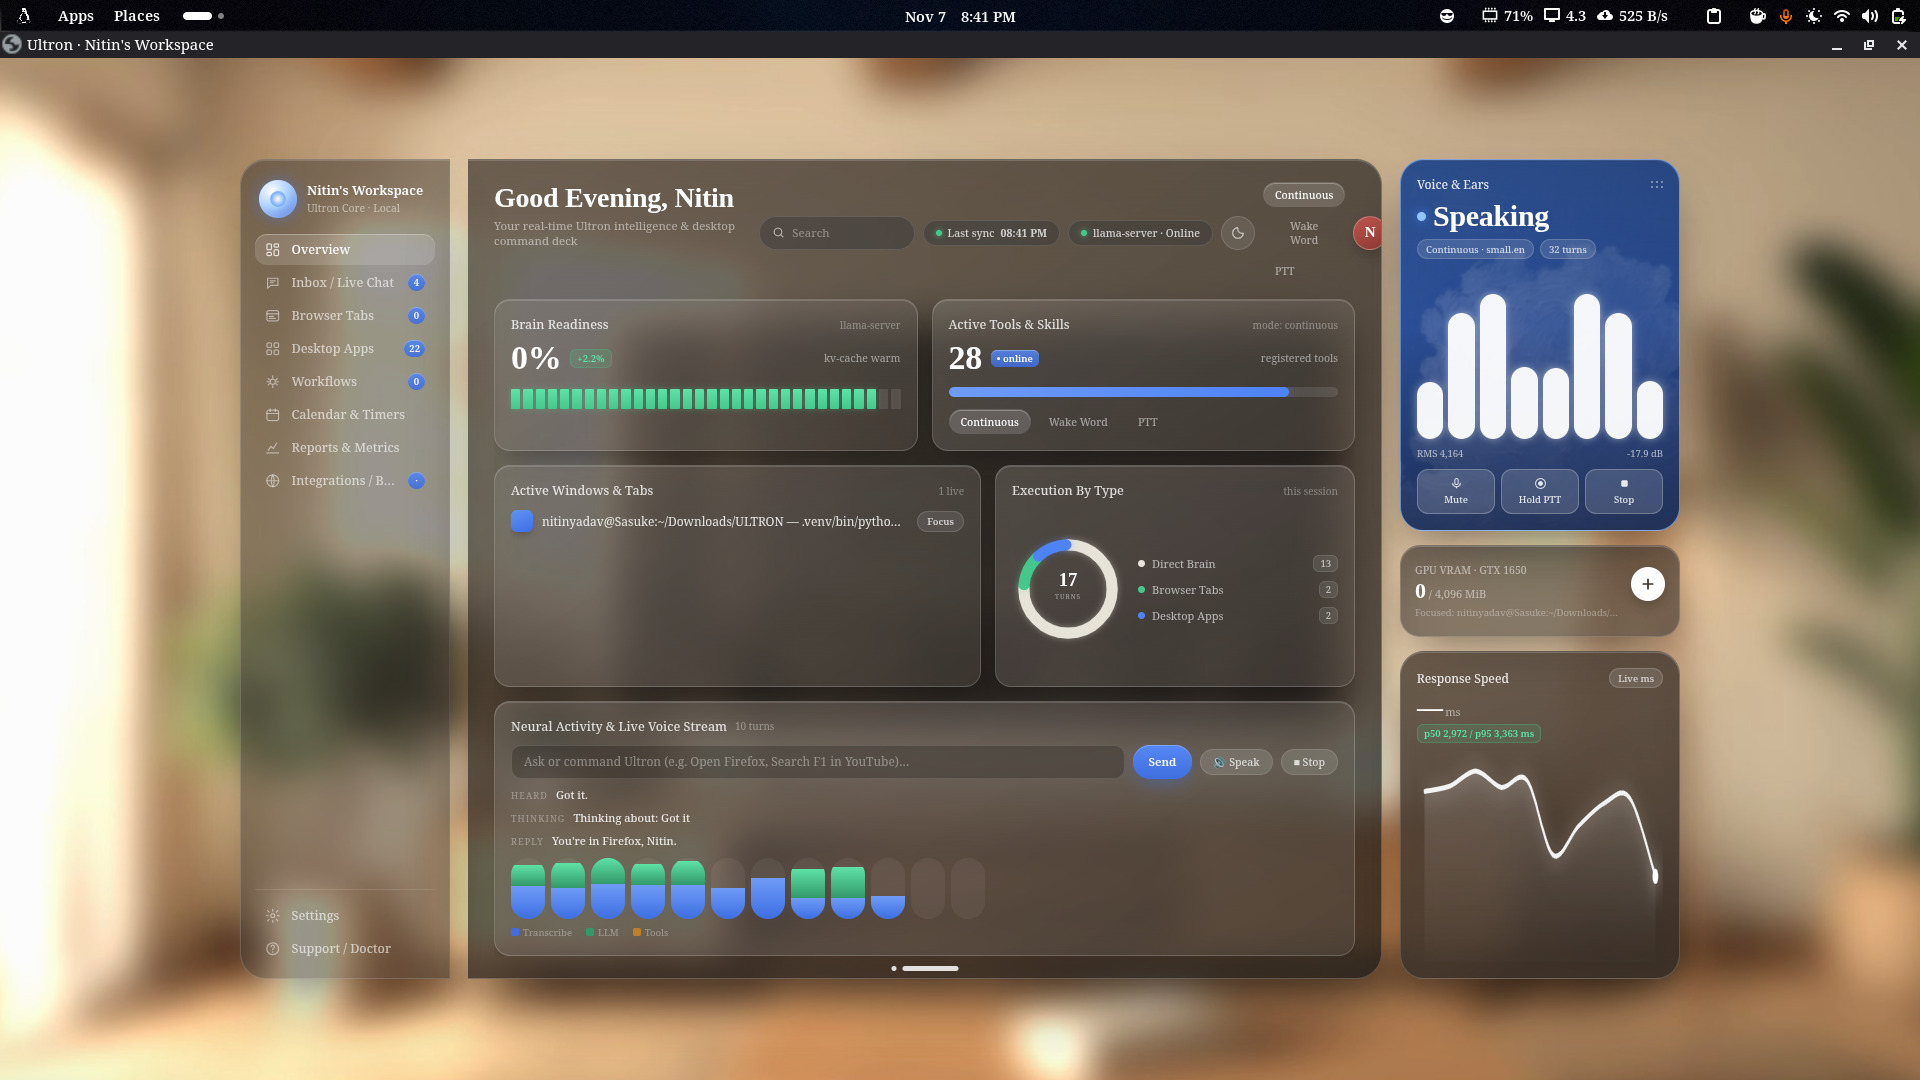
音声パイプラインはDynamic AGC GuardとSilero VADを備え、Piper TTS再生中にハードウェアマイクをミュートする4層のエコー保護を行う。現在Phase 10で一時停止中だが、655件の自動テストに合格している。
画面の認識にはGNOME Shell Wayland D-Bus IntrospectionとAT-SPI2アクセシビリティツリーを活用する。ブラウザのDOMブリッジも統合している。ユーザー固有の音声ワークフローを学習できるLoRAファインチューニングやSQLite長期メモリエンジンが将来実装される予定だ。
LLMが重みを理解する実験ログ1125ターン公開
Sparks of Weight Space Programmingで報告された8つの実験の完全なログとデータが、2026年11月8日にGitHubで公開された。RikiyaTが管理するリポジトリでは、OpenAIのgpt-6-astraを指すAstraが重みを読み書きする過程が記録されている。
全1,125ターンはすべてツール非依存で監査されており、Pythonコードの実行結果やネットワークの状態遷移が逐次保存されている。各実験フォルダにはREADMEが用意され、グラフや表のどのセルがどのファイル由来か明記されている。
実験8では数学能力向上のためにQwen3.5-0.8BとGemma 3 270Mが使用された。バブルラップサンドボックス内でネットワーク非接続の状態で推論が行われた。CC BY 4.0ライセンスで公開され、モデルの読み込みからエディットまでの全プロセスを追える。
出典:Hacker News
Apple MLX向けQwen3.8-27B推論速度2倍から4倍高速化
テンセントのDSpineアルゴリズムをApple MLX環境に移植した推論キットが、2026年11月9日にGitHubで公開された。NetProjectsが手掛けた本キットは、GatedDeltaNet層とフルアテンション層を持つハイブリッド型Qwen3.8-27Bに対応している。
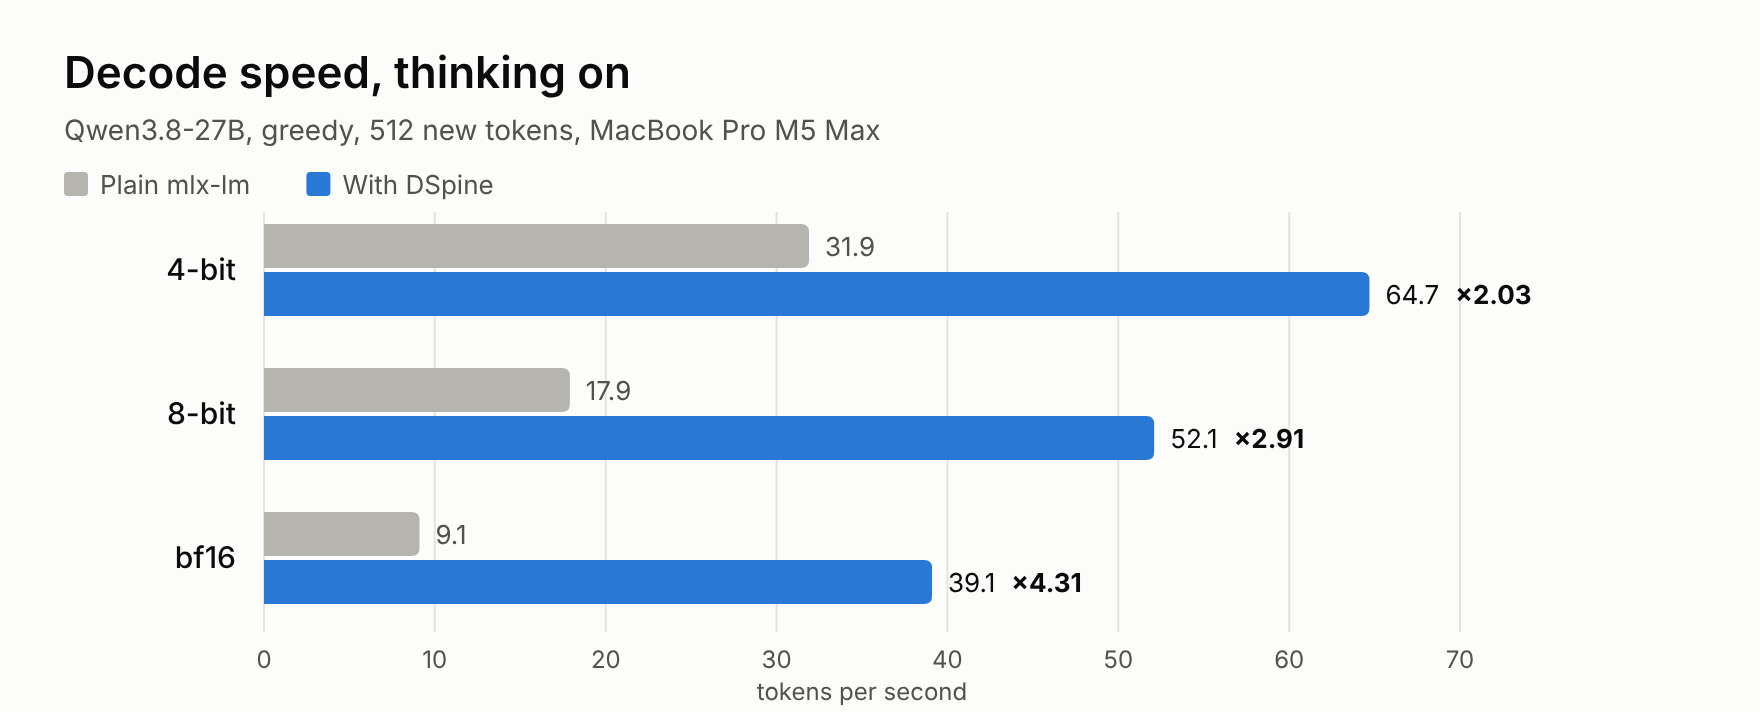
推論速度を大幅に向上させる。拒否されたドラフト時の状態巻き戻し機能を追加した。MacBook Pro M5 Maxの128 GB環境で4-bit版に約2倍、bf16版に約4.3倍の速度向上を確認した。
ドラフターを4-bit量子化することでラウンドあたりの所要時間を短縮し、受容トークン数はほぼ同等を保った。33kトークンの長文コンテキストでも速度向上が維持され、Apache 2.0ライセンスで配布されている。
Mac向け推論エンジンTokspurで177Bモデルを65kコンテキスト動作
GitHubで公開されたMac用ローカル推論エンジンTokspurにより、177BパラメータのQwen3.8 Flash-Nextモデルが動作する。最大65,536トークンのコンテキストで推論が可能となった。
san-digitalが提供する本エンジンは、Apple M5 Maxの40コアGPUと128GB統一メモリ、macOS 27以降を必要とする。XcodeのMetalツールチェーン、Git、Python 3.12、Rust 1.99.1のビルド環境で構築後、ターミナルからワンコマンドでインストールできる。
OpenAI互換APIエンドポイントはlocalhostの18081番ポートに設定され、生成されたAPIキーでクライアント接続が可能だ。独自開発のMetalエンジンとNative MTP(マルチトークン予測)対応により、プライベートなチャットやコード生成を高速に実行できる。
Qwen3.8-Flash-NextのNAS探索版E384がHugging Faceで公開
NVIDIAのQwen3.8-Flash-Next-FP4-LocalをNAS(ニューラルアーキテクチャサーチ)で探索した軽量モデルが、2026年11月8日にHugging Faceで公開された。autotrustが手掛けたQwen3.8-Flash-Next-E384-FP4-V2は、ルーティング済みエキスパートを512から384に削減し、モデルサイズを約16%縮小した。
GRPO(グループ比較最適化)形式の強化学習を施した完全結合済みのチェックポイントとして公開され、AIME 2026ベンチマークでは推論精度が92.5から95.0に向上した。
平均推論トークン数は2.05%減少し、2,200トークン予算内のCVSS3完成率は39%から70%へ改善した。vLLM 0.31で検証が完了しており、2026年11月8日に公開されたチェックポイントが配布されている。
FP4/CSF/PLEの重みレイアウトに対応するパッチファイルが含まれており、B200上で単一GPUで動作検証済みだ。利用者は独自のパッチ適用で推論サーバーを構築できる。
出典
- nitinyadav025/Ultron: [WIP / Ongoing R&D] Ultron — 100% Local Screen-Aware Voice AI Assistant & Spatial Glass OS Environment for Linux Wayland(GitHub topic local-llm)
- LLMs can understand and write neural network weights(Hacker News) · 議論
- internet-projects/dspine-hybrid-mlx: DSpine speculative decoding for hybrid Qwen3.8-27B on Apple MLX(GitHub topic llm-inference)
- san-digital/tokspur: Private chat and code on your Mac. Run a 177B model on a 128 GB M5 Max: local Qwen3.8 Flash-Next inference with a 65,536-token context, Tokspur's own Metal engine with native MTP, and an OpenAI-compatible API. Apache 2.0.(GitHub topic local-llm)
- autotrust/Qwen3.8-Flash-Next-E384-FP4-V2 (image-text-to-text)(Hugging Face trending) · 議論